Anthropic在2026年9月17日公开了一组用于观察前沿AI实验室研发节奏的内部指标:截至8月,Claude被评为“主导”26%的模型研发工作,超过90%的工作达到“AI协作”或更高等级;其最常用内部平台同时运行约3万个研究与工程智能体。
这些数字说明AI已经深度进入下一代模型的研发流程,但不能直接翻译成“AI已经能独立造出自己的继任者”。关键区别藏在Anthropic对“主导”的定义、样本构造方法、人工监督环节和仍为零的“完全自主”比例里。美联社独立确认了这次披露及其引发的自我改进讨论,但26%、3万和6%等具体数值仍来自Anthropic自己的测量,而不是第三方审计结果。
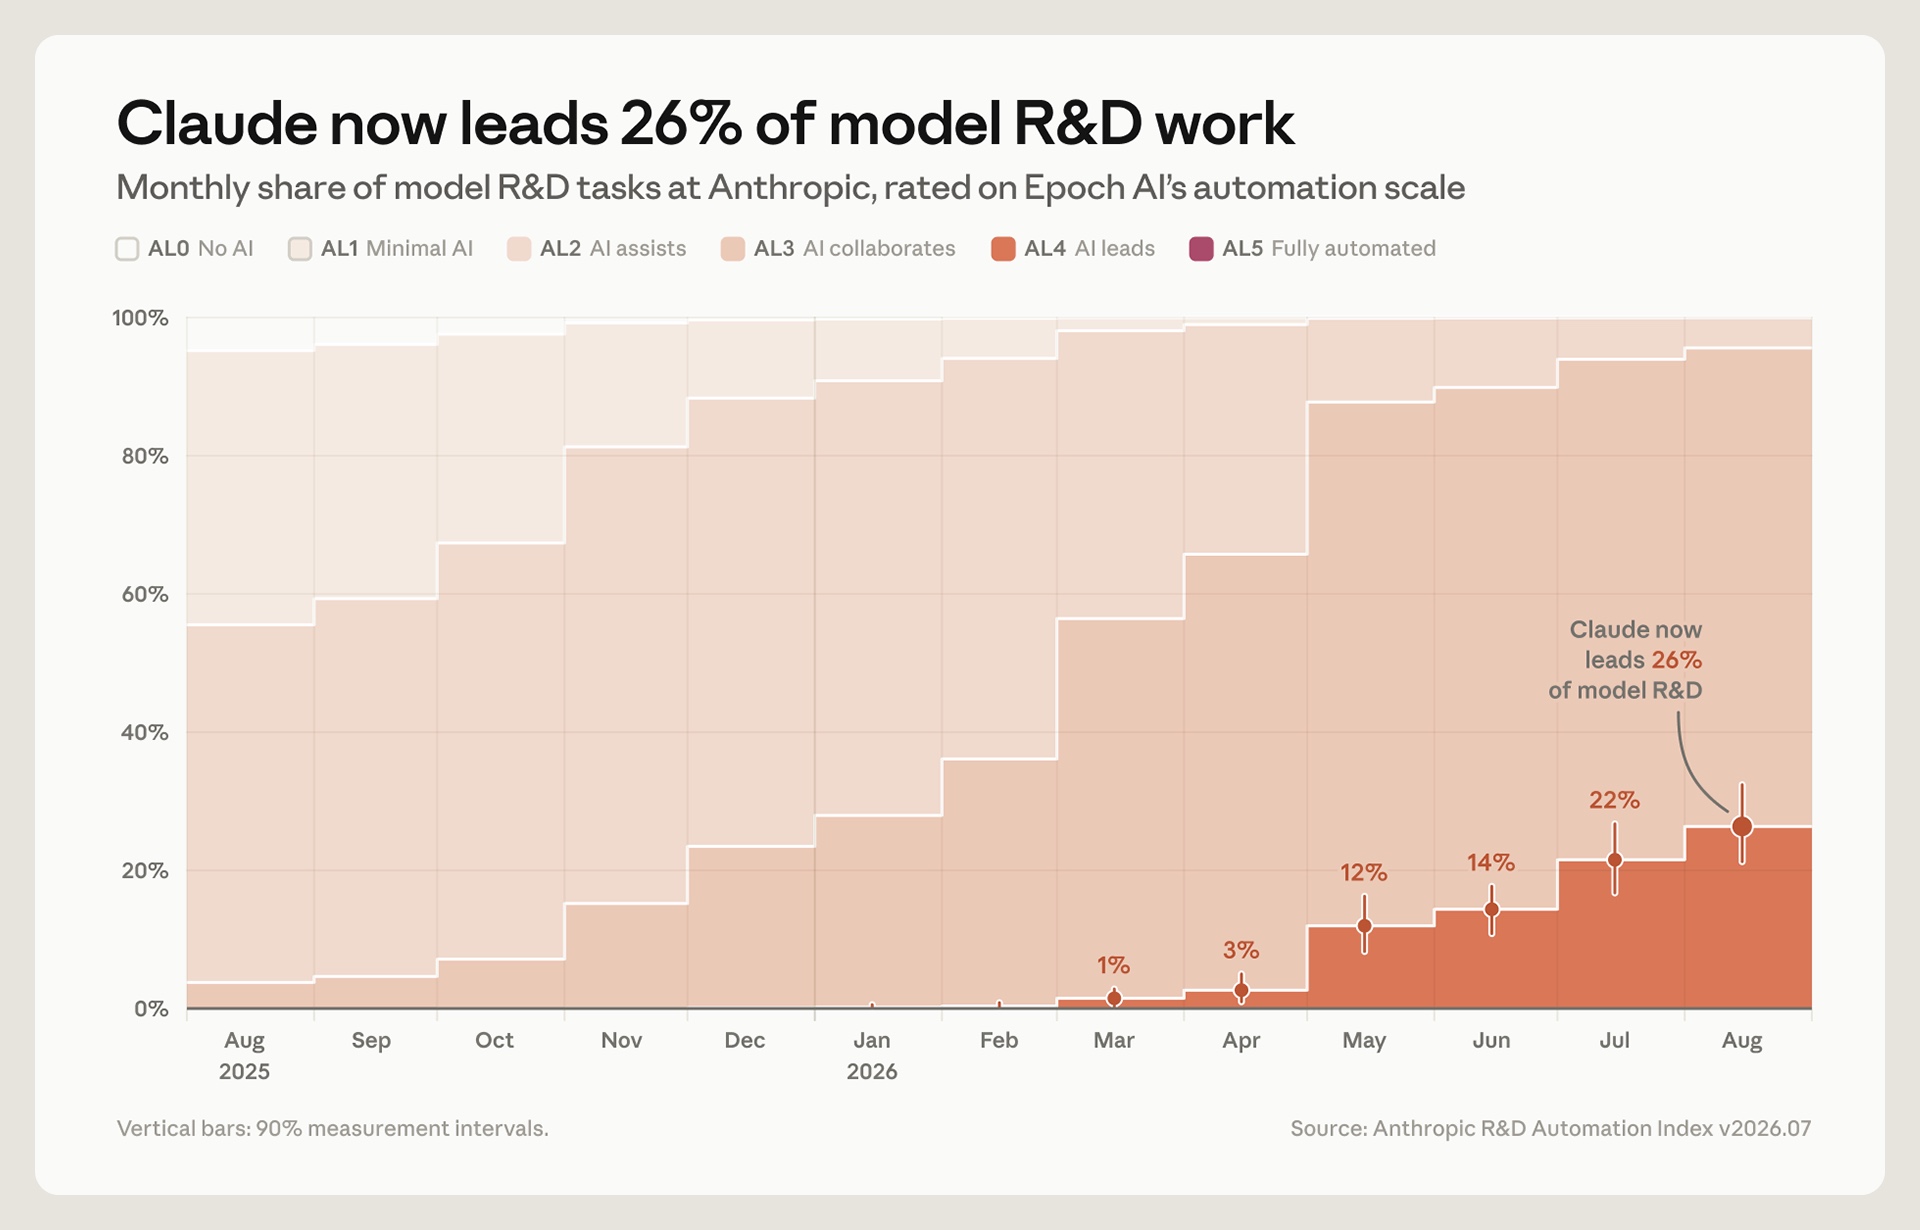
26%的“主导”究竟是什么意思?
Anthropic原始报告采用Epoch AI提出的六级自动化框架。AL3“协作”表示AI能在人的密切指导下完成大块工作;AL4“主导”表示人给出高层任务后,AI可以处理多数端到端步骤和意外情况,但最终仍由人监督和决定是否上线;AL5才是无需人介入的完全自主。
| 等级 | 报告中的含义 | 是否需要人 |
|---|---|---|
| AL2 AI辅助 | 帮助完成局部步骤 | 人仍组织主要流程 |
| AL3 AI协作 | 在密切指导下完成大块工作 | 需要持续提供上下文与决策 |
| AL4 AI主导 | 从高层提示出发完成多数端到端步骤 | 人监督、复核并决定部署 |
| AL5 完全自主 | 自行发现、界定、实施并部署任务 | 无需人处于工作闭环中 |
Anthropic明确写道,在它测量到的任何模型研发子集中,Claude都没有达到AL5。因此,“主导26%”更接近“一名能独立推进大量执行步骤、但没有最终发布权的高级代理”,而不是一个能自行决定研究方向、训练新模型并投入生产的自主实验室。
这个指数是怎样算出来的?
Anthropic没有简单统计Claude生成了多少代码。2026年7月的每一周,公司从参与模型研发循环的各部门随机抽取20%员工,让Claude研究代理阅读其Slack和内部文档,整理出约1.5万个细粒度任务;随后再把任务组织成542个节点、378个叶节点的层级树。
每个任务由Claude研究其工作方式、工具和AI参与程度,再由一个独立Claude“评委”分配AL0至AL5等级。不同任务的权重以员工投入时间近似:某人一周做四项任务,每项分得四分之一权重。公司称,模型与人类评审的等级完全一致率为59%,相差不超过一级的比例为97%;但报告也承认,“协作”和“主导”的边界存在真实分歧。
更重要的限制是任务篮子被冻结在2026年7月。指数上升说明当时人类正在做的工作变得更自动化,却不能自动捕捉人类是否转向了全新的、更难任务。Epoch AI的方法提案也提醒,任务清单只是测量工具的一部分,仍需要判断模型在每个任务上的实际表现,并持续更新本体。
3万个智能体,不等于3万个自主研究员
Anthropic称,截至2026年8月,在其使用最多的内部平台上,任一时点约有3万个智能体执行研究和工程工作。这个数字只覆盖一个平台,而且“智能体实例”不是全职员工的等价物:同一项目可以并行启动大量短时进程,它们可能处理代码检查、实验运行、资料整理或彼此委派的子任务。
报告把监督拆为在线和离线两层。在线监控在动作执行前检查并阻止或引导风险行为;离线监控在动作发生后阅读活动记录,寻找缓慢累积、可以逆转的问题。Anthropic称,两类监控都覆盖该平台100%的动作,但“覆盖”只表示动作经过监控器,并不证明监控器能识别所有未知风险。
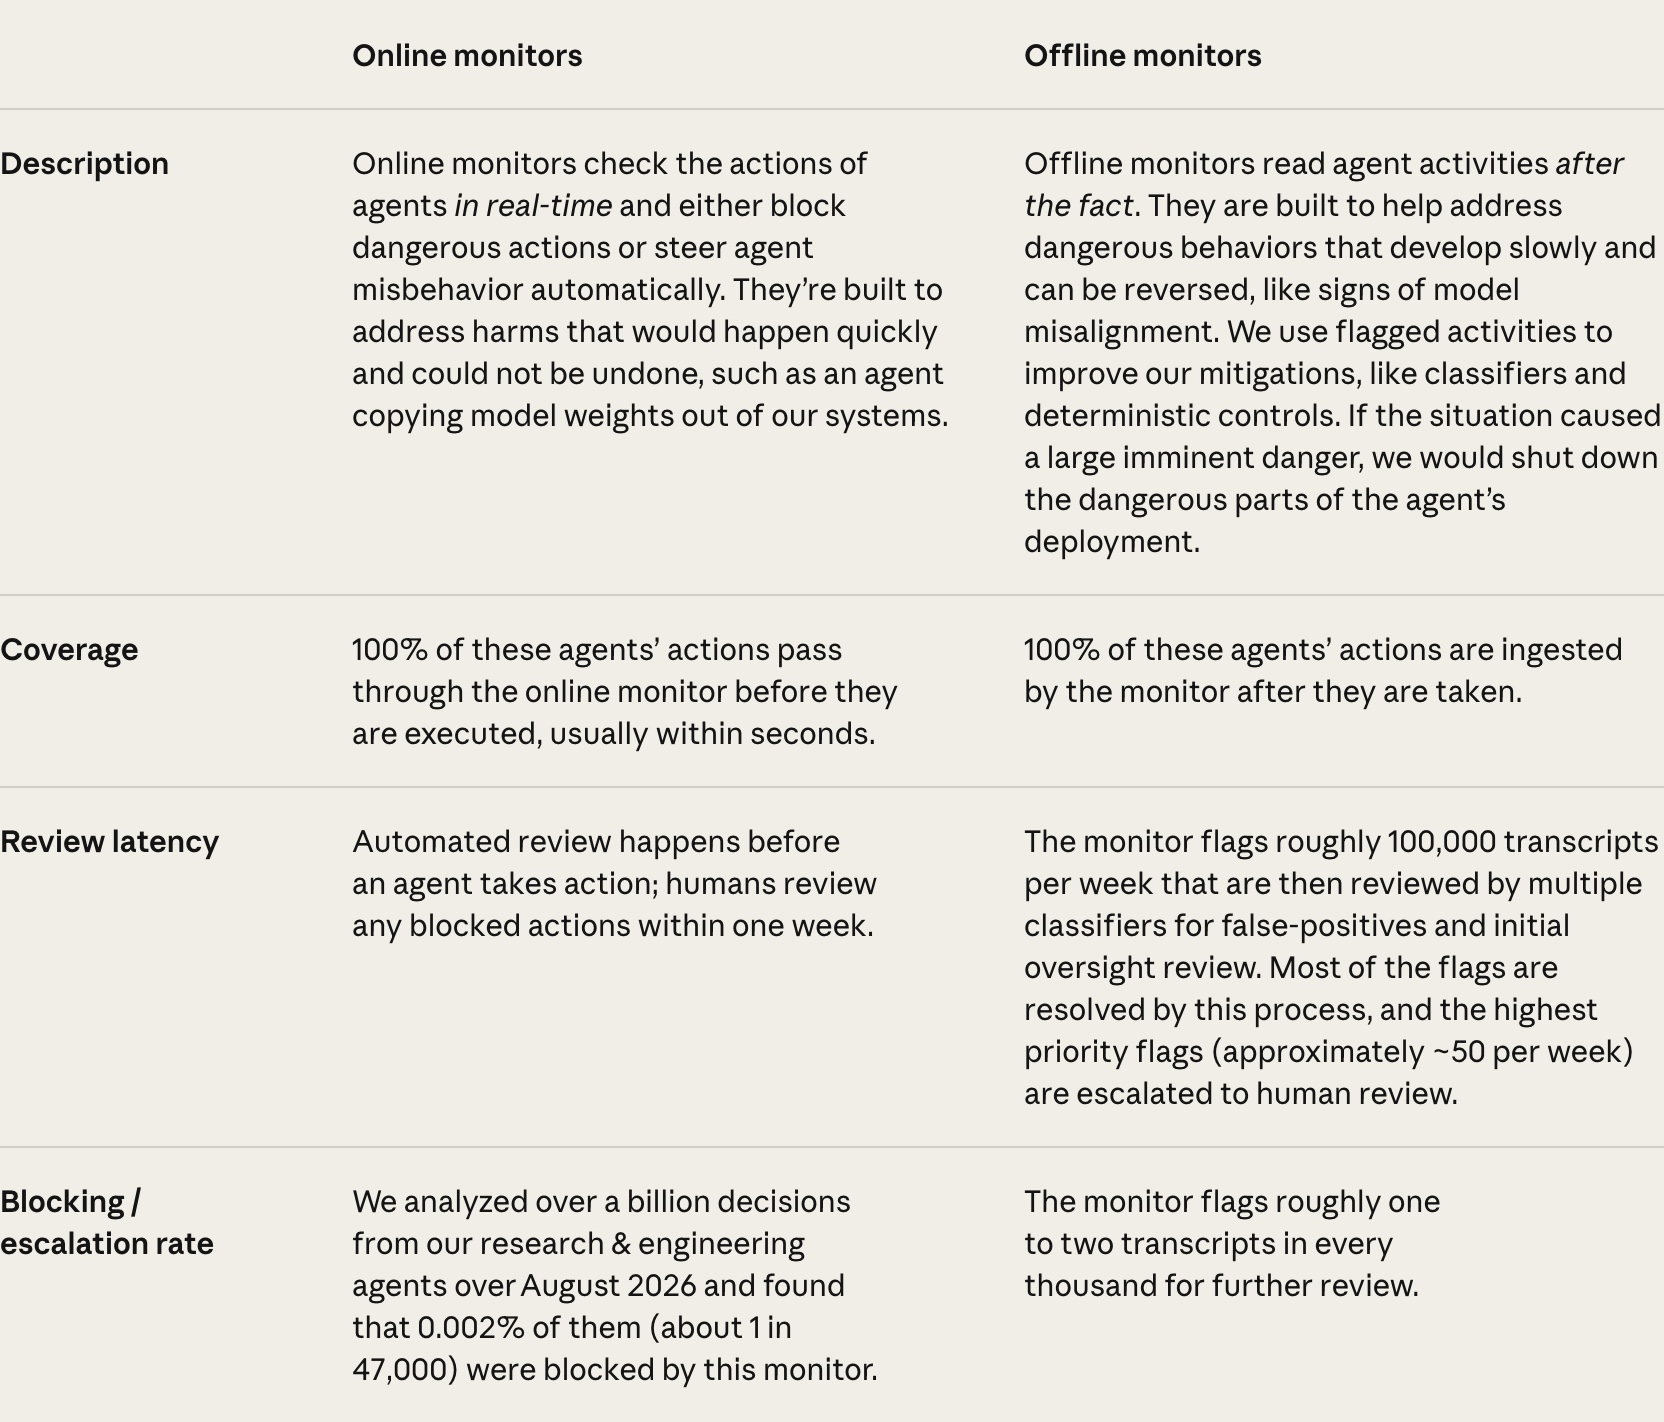
在2026年8月超过10亿次研究与工程智能体决策中,公司称在线监控阻止了0.002%,约每4.7万次一次;离线系统每周先标记约10万份记录,经多重分类器筛选后,约50份高优先级记录升级到人工复核。低阻断率既可能表示大多数动作正常,也可能受规则边界和检测能力影响,不能单独当作安全成功率。
6%的安全算力是投入承诺,还是结果证明?
第三项指标是算力分配。Anthropic检查了2026年7月13日至20日这一周的计算资源,称AI研发算力中约6%用于安全工作;如果只看“AI驱动的AI研发”,安全部分约占12%。这是一周快照,不是固定预算,也没有说明安全研究产生了多少可验证风险降低。
分类工作同样使用Claude:接近1万次训练和评估运行中抽样约14%,并向算力消耗较大的运行倾斜;研究代理的推理负载则根据会话记录分类。报告采取较保守口径,把同时提升能力和安全的工作归入AI研发,但也承认底层标签可能误标,安全与能力的边界会随定义变化。
它与“自动化研究实习生”有什么不同?
此前我们分析过OpenAI对“自动化研究实习生”的内部定义,核心问题是系统能否在人的指导下完成需要数天的明确研究任务。Anthropic这次没有公布一个单一能力里程碑,而是试图建立持续统计:多少实际研发任务由AI协作或主导、多少智能体动作被监控、多少算力投向安全。
两种披露都来自实验室内部,且研究流程、任务权重和工具权限不同,不能把26%与“3.1个智能体工作日”等数字直接排名。真正可比需要共同任务定义、相同自动化等级、稳定时间窗以及独立第三方对样本、分类器和原始日志的复核。
距离“AI自主造AI”还缺哪些证据?
至少还缺四类证据:第一,AI能否自行发现重要研究问题,而不是只执行人给出的任务;第二,能否设计并判断没有清晰成功标准的实验;第三,能否在不牺牲安全的前提下管理训练、数据、算力和部署闭环;第四,能力提升是否来自AI自身贡献,而不是更强基础模型、更多算力或人类工程流程的共同作用。
Anthropic的披露有价值之处,在于把“AI正在帮助造AI”从口号拆成可讨论的任务、监督和资源指标;它最需要补上的,则是第三方验证和跨实验室共同口径。26%说明研发自动化正在快速加深,但报告本身提供的最重要边界同样清楚:完全自主比例仍为零,人仍握有任务选择、审批与部署权。
资料来源
- Anthropic:Measurements for understanding the pace of AI development inside frontier labs,2026年9月17日。
- Associated Press:Anthropic says its model Claude is helping to build the next version of itself,2026年9月18日。
- Epoch AI:Toward an O*NET for AI R&D,2026年6月17日。
资料核验时间:2026年9月19日21:20(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。