2026年9月30日,美国疾病控制与预防中心(CDC)发布2025—2026季FluSight评估:谷歌的Google_SAI-FluEns在39个符合条件的模型中表现最佳。这是对一个已经结束的流感季的评估,不是对下一季疫情作出的新预言。对读者更有意义的问题是:AI究竟改进了什么,这个第一名又不能证明什么?[CDC评估]
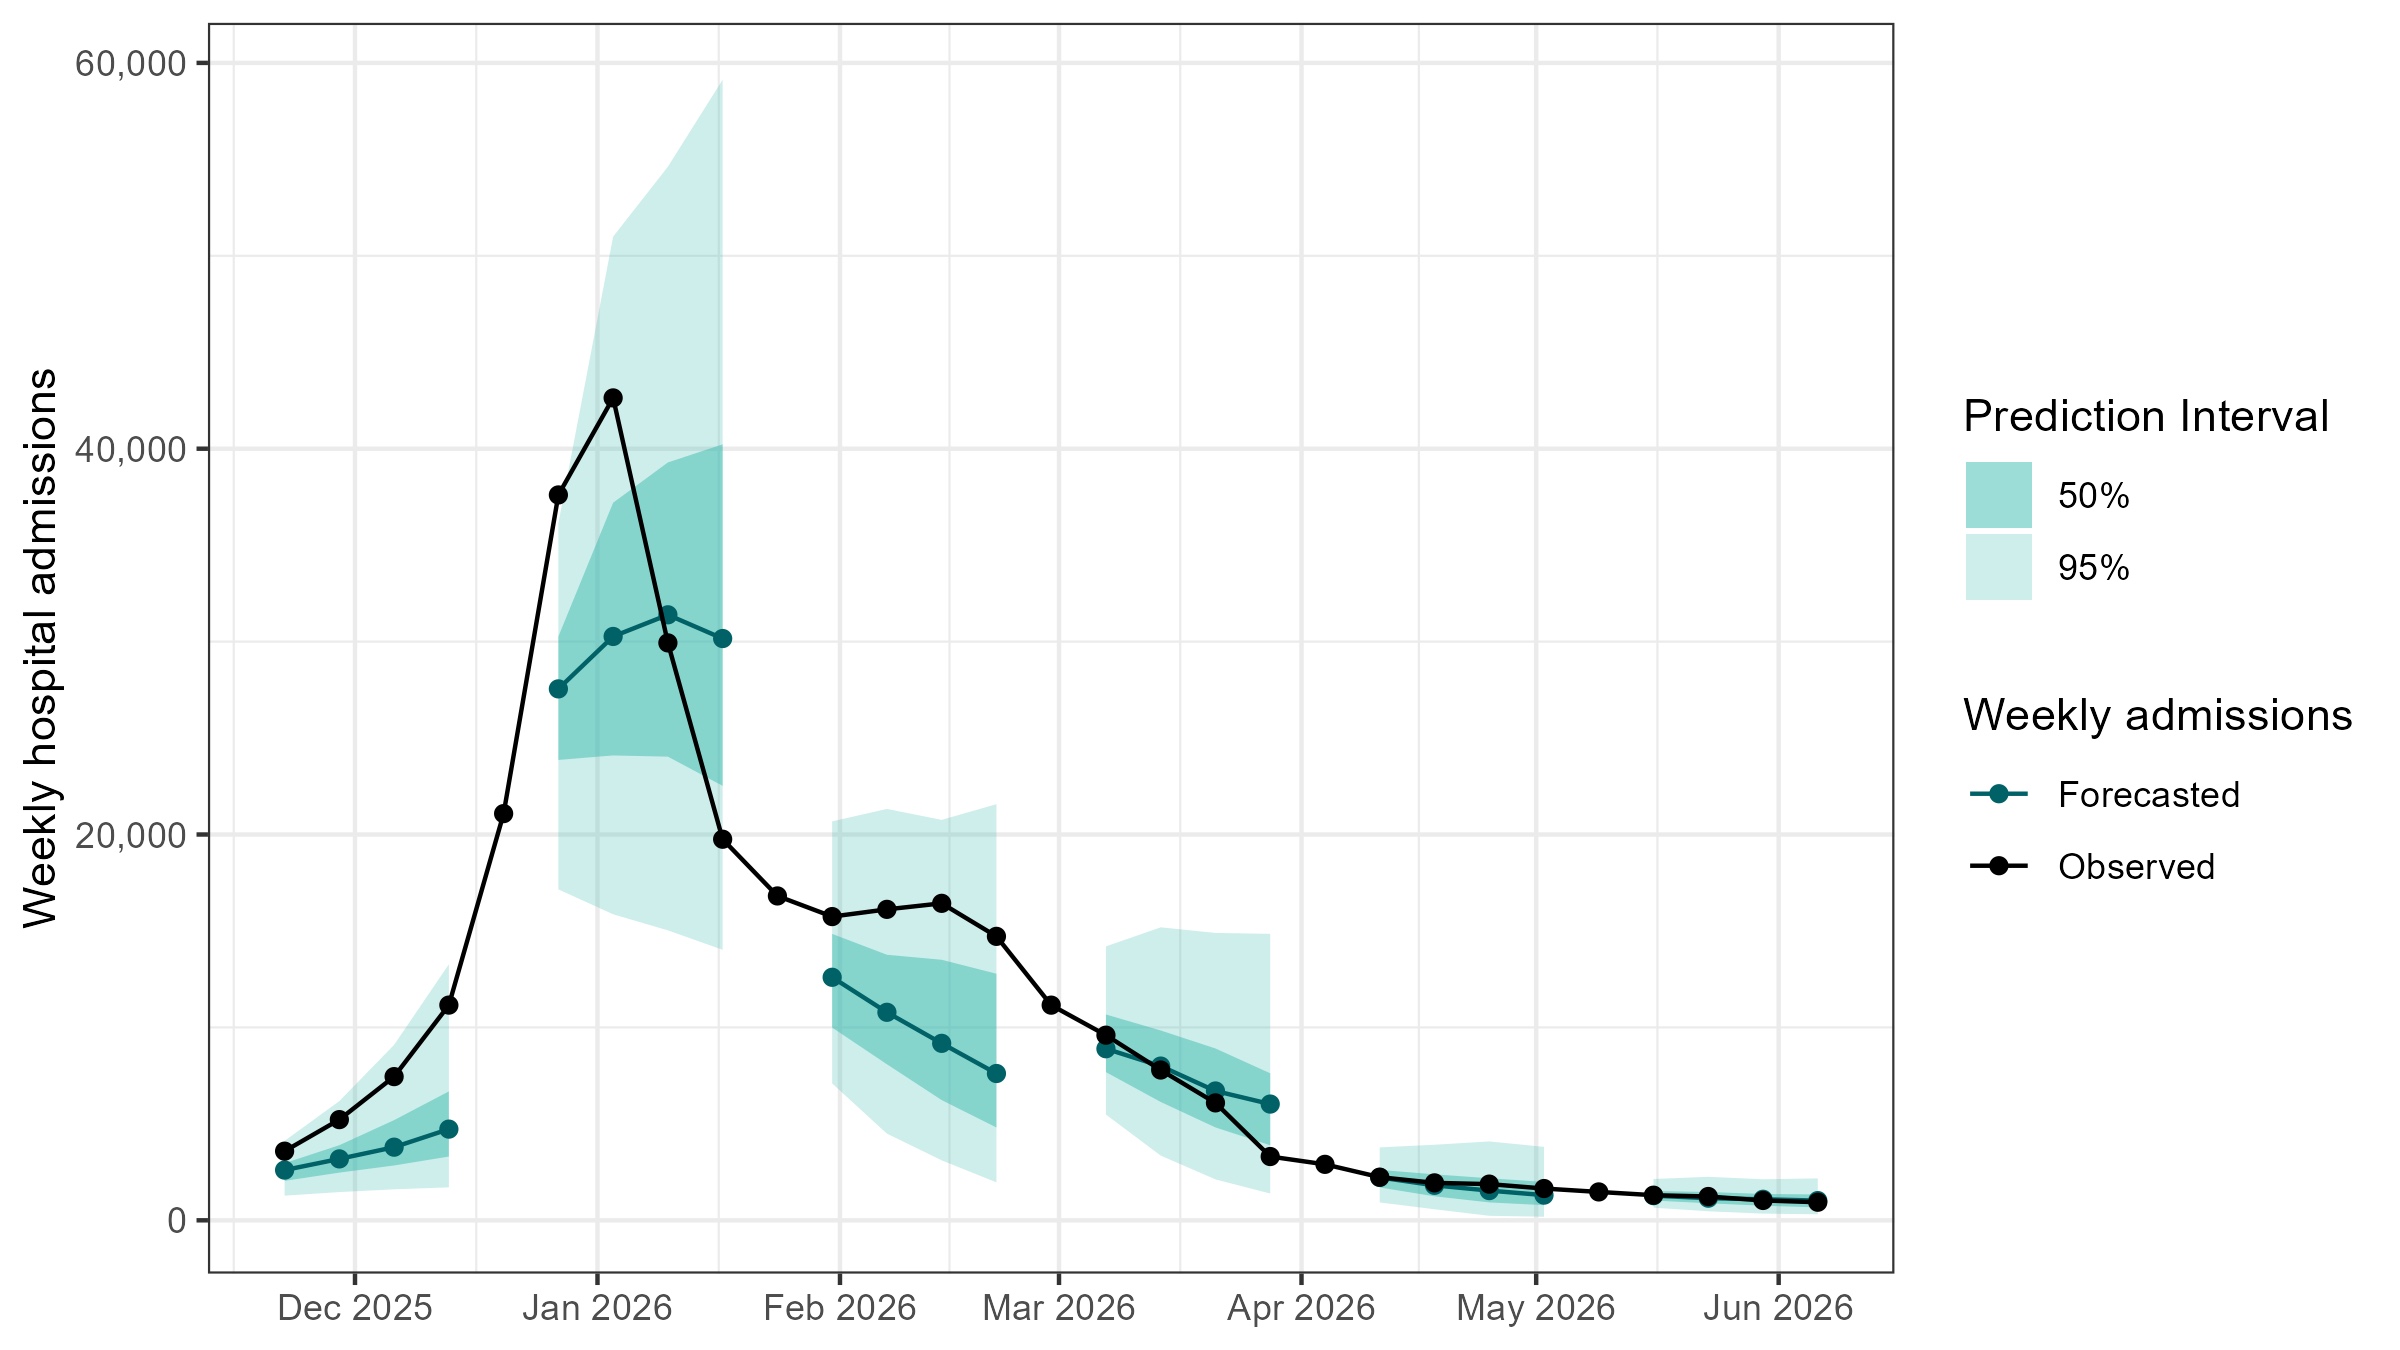
AI先开发软件,再让软件提交预测
谷歌同日说明,预测模型由Empirical Research Assistance(ERA)辅助开发。研究预印本描述的流程并不是让聊天机器人凭文字回答“下周会住院多少人”,而是让大语言模型在树搜索过程中生成、运行、评分并改进可执行预测代码,随后把选出的模型组合起来。这里的AI更接近模型开发者,而不是向患者提供诊断的聊天界面。[谷歌说明][研究方法]
研究团队称,2025—2026季的预测按周实时提交,并留下可审计的时间戳。其价值在于,预测先于对应结果出现,区别于知道完整疫情曲线后再挑选表现最好的模型。预印本也指出,真实运行会遇到迟报、节假日异常和后续数据修订;只在历史数据上得到好分数,还不能替代这种前瞻检验。
0.56是区间评分,不是“56%的准确率”
本次任务预测的是实验室确诊流感的每周住院数量,时间范围为当周至未来三周。CDC主要比较相对加权区间分数(relative WIS):住院数先作对数变换,再衡量预测区间与观测值的相容程度;分数越低越好,基线设为1。它不是一次判断“对或错”的命中率。
以下数值来自CDC随报告公布的原始排名表。区间覆盖率表示最终观测值落入相应预测区间的比例,不等于对个人患病的判断准确率。
| 模型 | 相对WIS | 50%区间覆盖率 | 95%区间覆盖率 |
|---|---|---|---|
| Google_SAI-FluEns | 0.56 | 51.20% | 93.72% |
| FluSight官方集合模型 | 0.62 | 51.62% | 89.85% |
| FluSight基线模型 | 1.00 | 41.54% | 85.75% |
因此,“0.56”不能写成“准确率56%”,也不能直接换算成住院人数误差减少44%。一个模型还应同时接受不同预测时间、不同地区与疫情拐点的检验,而不是仅用一个总分描述全部表现。
为什么论文中的43个模型,变成了官方榜单的39个?
两个数字来自不同的比较范围,并不应混在同一条结论里。5月的预印本分析截至5月2日的提交,包含52个辖区,要求模型覆盖至少80%的任务,得到43个符合条件的流感模型。9月的CDC最终评估排除了全国和波多黎各目标,并采用至少75%的提交门槛,最终纳入39个模型。本文的“第一名”以新公布的CDC评估为准。
这也提示了一个阅读AI榜单的方法:先问预测对象、时间窗口、地点和入选规则是否一致,再比较排名。研究团队较早的自评可以解释方法,但不能冒充后来发布的独立机构评估;CDC对流感任务的排名,也不能自动替论文中的其他病原体结果背书。
它支持公共卫生规划,不支持把榜单当个人诊断
谷歌说明,FluSight的组合预测服务于州级医疗服务需求的沟通。本文据此分析,这类成果更适合讨论怎样提前准备医疗资源,而非回答某个具体人会不会感染、是否需要住院。群体住院数量和个人临床风险是不同的问题,需要的数据、验证方式与使用责任也不同。
还要区分“取得第一名”与“已替代现有公共卫生流程”:CDC报告继续将官方FluSight集合模型列为其预测信息沟通所用模型。这次评估没有宣布由谷歌模型取而代之。更稳妥的结论是,AI辅助开发代码在一个有边界、可评分的真实预测任务中取得了竞争力;它在新地区、新流感季或新的工作流程中的效益,仍需进一步验证。
从软件生成到实际决策之间,最容易被忽略的是两项检查:预测区间能否恰当地表达不确定性,以及决策者在模型失准时怎样调整行动。一次排名提供了值得研究的证据,不是对未来永远领先的保证。
主要来源与资料说明
- CDC:FluSight 2025—2026 Evaluation,发布及更新日期:2026年9月30日;支持最终排名、任务范围与评分规则。图表数值见其Table 1数据文件。
- Google Research:Google's AI ranks #1 for predicting flu hospitalizations,发布日期:2026年9月30日;属于开发机构的说明,不作为第二份独立评估。
- Martinson等:Prospective multi-pathogen disease forecasting using autonomous LLM-guided tree search,arXiv v1提交日期:2026年5月15日;本文阅读其HTML全文,用于核对方法与阶段评估范围。该材料为预印本。
- CDC PHIL 11745,图像制作年份:2009;照片署名与授权信息见原页面。两张CDC资料图的使用遵循CDC机构资料规则,不代表CDC、HHS或美国政府对本站或任何产品、服务的认可。
上述公告标注了日期,但未给出精确发布时间与时区,本文不据此推算小时级发布先后。资料核验时间:2026年10月2日09:15(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。