2026年10月2日,马里兰大学介绍了机器人世界模型μ₀(Mu Zero)的研究进展:这项工作近期获得IROS 2026 RoBoWoMo研讨会最佳论文奖第二名。研讨会官网列出了获奖名单,活动日期为9月27日;这是研讨会奖项,不是IROS主会最佳论文奖。论文预印本早在6月公开,此次新闻不能解读为一个全新模型首次发布。
Mu Zero尝试从视频中学习物体、手和工具的三维运动轨迹,再把这种运动知识用于机器人控制。它与读者关心的“机器人能否看视频学做事”直接相关,但有一个容易误读的边界:不用机器人动作标签来预训练世界模型,不等于让机器人执行任务时完全不用示范。
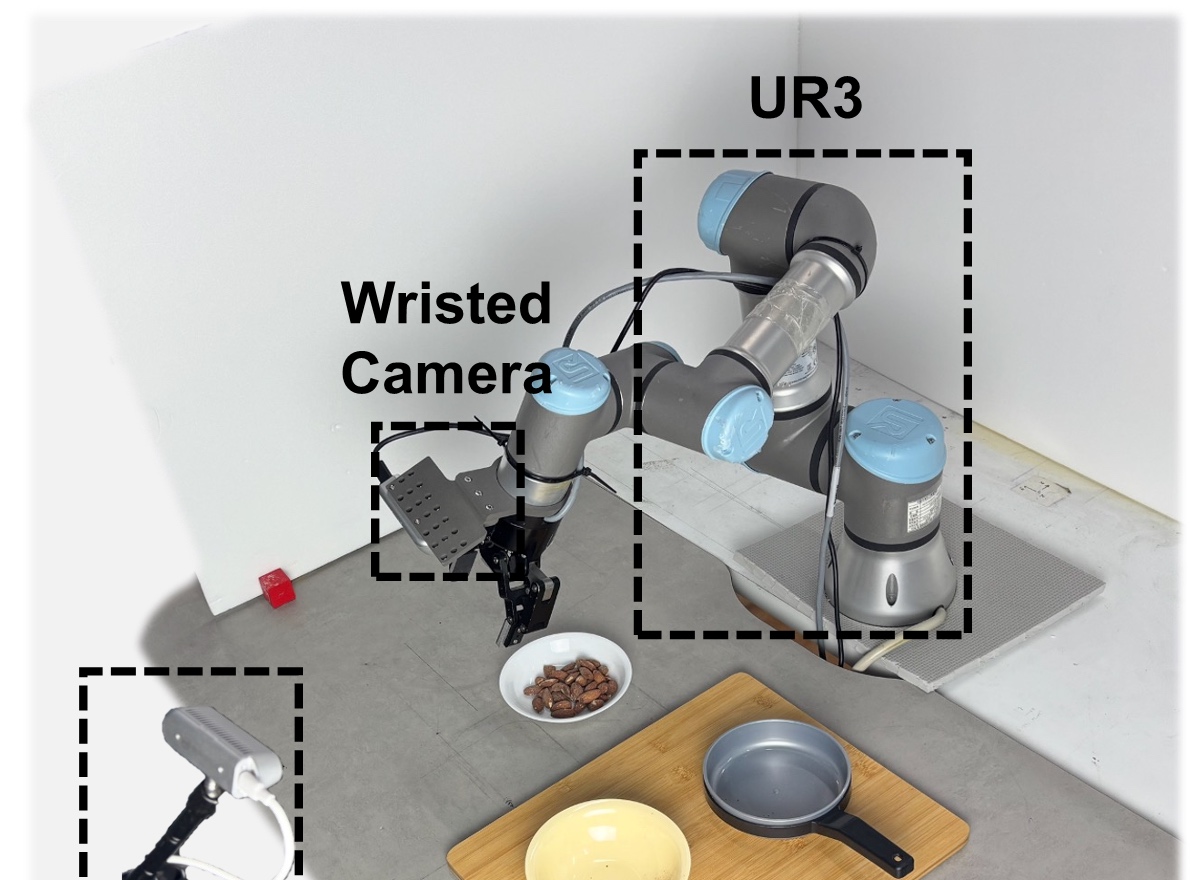
把“物体怎样移动”和“机器怎样执行”分开学习
视频能记录杯子被拿起、移向水槽的过程,却通常没有同时记录机器人各关节的控制指令。Mu Zero采用一个中间层:预测与任务有关的关键点怎样在三维空间移动,而不是重建每一帧的全部像素,也不是直接输出某台机器人的关节动作。
作者的TraceExtract流程从人和机器人视频中提取关键点、三维轨迹及动作事件描述;世界模型学习这些轨迹。实际控制时,另一个Action Expert(动作模块)结合机器人观测和自身状态,把运动特征转换成可执行指令。
省掉预训练动作标签,不是省掉全部机器人示范
原论文第4.2节和附录D.4明确说明:适配真实机器人时,世界模型保持冻结,动作模块仍利用人遥操作采集的示范训练。下面的数量来自作者的UR3实验设置,不能理解为任何机器人、任何任务都只需这些数据。
| 真实实验任务 | 作者采集的示范 | 训练与评估范围 |
|---|---|---|
| 把物体放入水槽 | 90条 | 固定底座UR3、两指夹爪;作者报告每项任务20次执行评估 |
| 把杏仁倒入指定容器 | 80条 | 在设定的物体与任务条件下测试 |
| 展开毛巾 | 50条 | 验证桌面操作,不代表长程家务已解决 |
由此可以看出,方案改变的是训练成本的分工:视频提供可复用的运动先验,机器人示范仍负责把先验落到具体硬件上。这不等于“随便看一段视频,任意机器人就能零训练完成任务”。
91.7%与30.25%为什么必须分开看?
作者报告,Mu Zero加动作模块在三项真实UR3任务上的平均成功率为91.7%,π₀和π₀.₅分别为71.7%与80%。但在八项RoboCasa365仿真任务中,三者平均成功率分别为30.25%、25.25%与42%。因此它在这组真实实验中领先,不能推导出所有测试场景都优于π₀.₅。
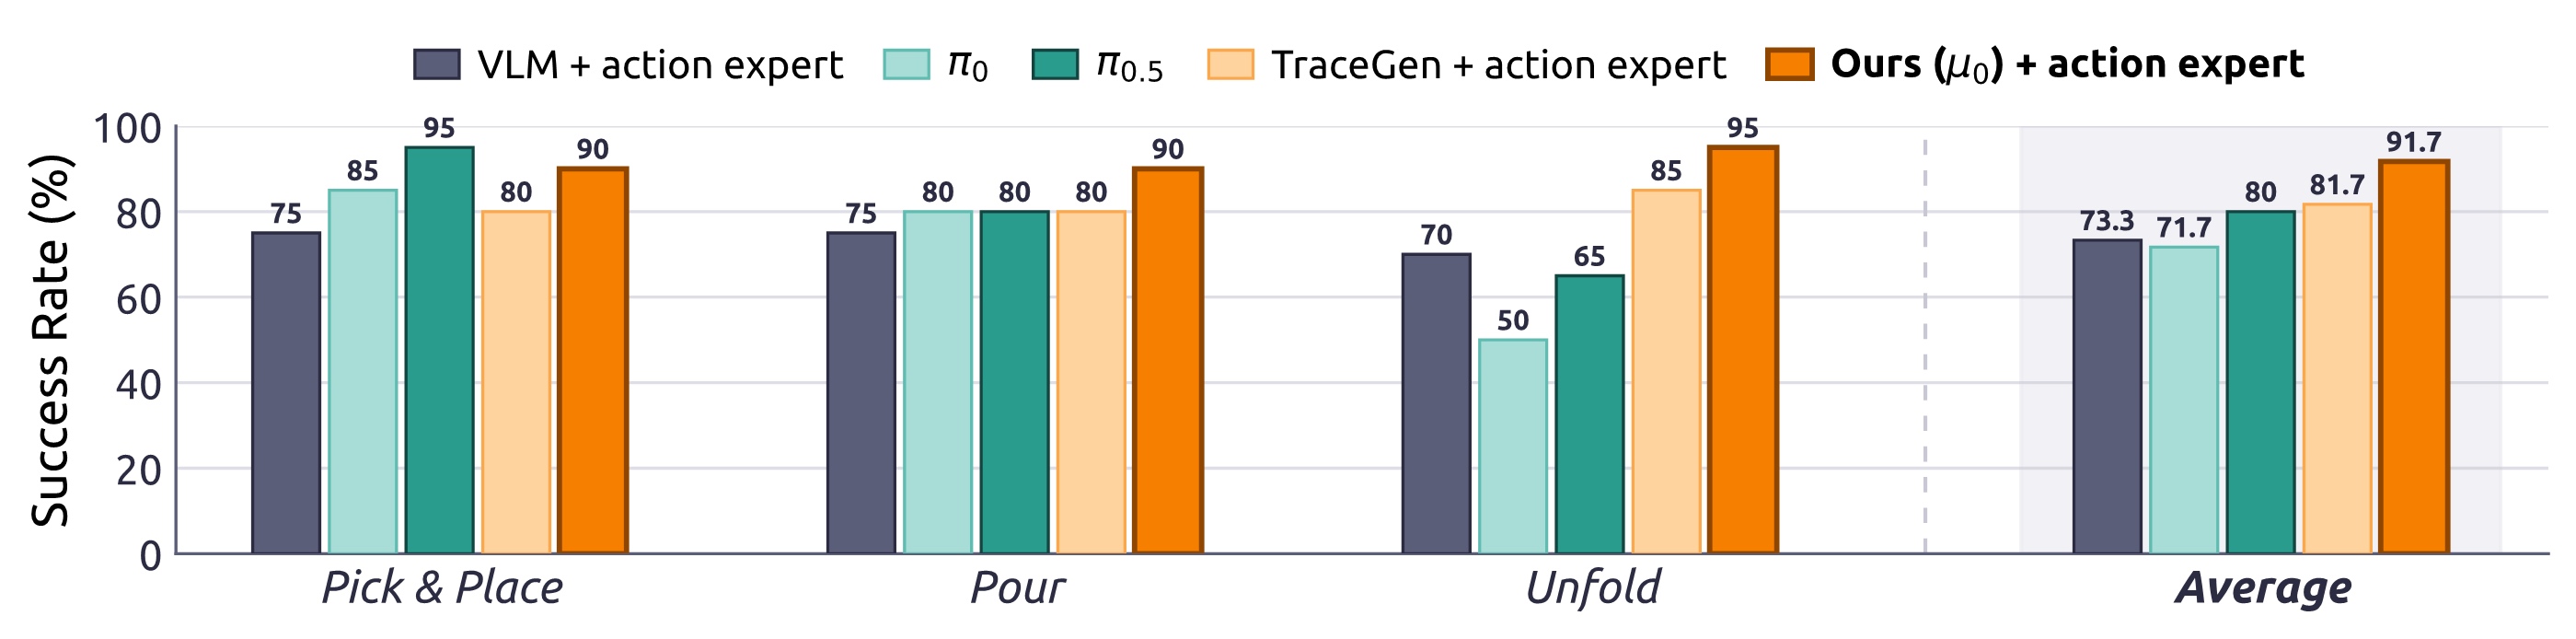
比较还需要注意训练条件:论文指出π₀.₅使用了大规模带动作标签的预训练数据,双方并非预训练数据完全匹配的对照。真实测试与仿真测试的任务、环境也不同,不能把两个百分比相除,解释为“真实世界比仿真容易多少”。
能预测轨迹,仍不等于掌握全部物理交互
论文列出的限制包括轨迹提取、三维重建和文字描述误差,以及没有显式建模力、触觉反馈与接触模式。已有验证集中在有限硬件和桌面任务;移动操作、灵巧手以及更长任务链仍需进一步研究。
对读者而言,判断这类进展时至少应分开核对三件事:世界模型预训练用了什么监督信息,硬件适配还需要多少示范,以及结果覆盖哪些任务。研讨会获奖名单可以独立核对;性能数字则来自同一作者团队的论文与项目材料,不能当作独立复现实验。关于产业与高校搭建机器人研究平台的另一类进展,可参阅本站亚马逊与佐治亚理工学院科研合作报道,合作计划和具体实验成果属于不同层次的证据。
资料来源与说明
- 马里兰大学UMIACS:Teaching Robots to Follow the Motion,发布日期2026年10月2日,页面未标明发布时刻与时区。
- RoBoWoMo研讨会官网:Spotlight and Award Papers,获奖名单未标注更新日期;活动日期说明列明研讨会于2026年9月27日举行。
- 原论文:μ₀: A Scalable 3D Interaction-Trace World Model,预印本首次提交于2026年6月11日17:59:56 UTC,本文核对版本为6月15日06:13:42 UTC修订的v2;实验细节见第4.2节及附录D.4,许可为CC BY 4.0。
- 作者项目页,未标注发布日期,提供原始实验资料图与演示;它与论文同属作者团队材料,并非第二份独立性能验证。
资料核验时间:2026年10月5日09:08(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。