2026年9月22日,UCLA研究团队在《eLight》正式发表一种数字与光学混合的深度伪造视频检测方案:先由神经网络编码视频,再让光的传播承担部分解码计算。15路并行的实际光学实验,在Celeb-DF数据集上取得97.79%的平均检测准确率。这为大批量视频初筛提供了一个研究方向,但不是“任何假视频都能被识破”的承诺。
对经常接触AI生成视频的读者来说,值得追问的不只是准确率:光究竟替代了哪部分计算?测试到底用了多少独立素材?节省的电能又属于哪个环节?沿着这三个问题看原论文,才能理解这套装置做到了什么。
光没有直接“看懂视频”,数字编码仍是前提
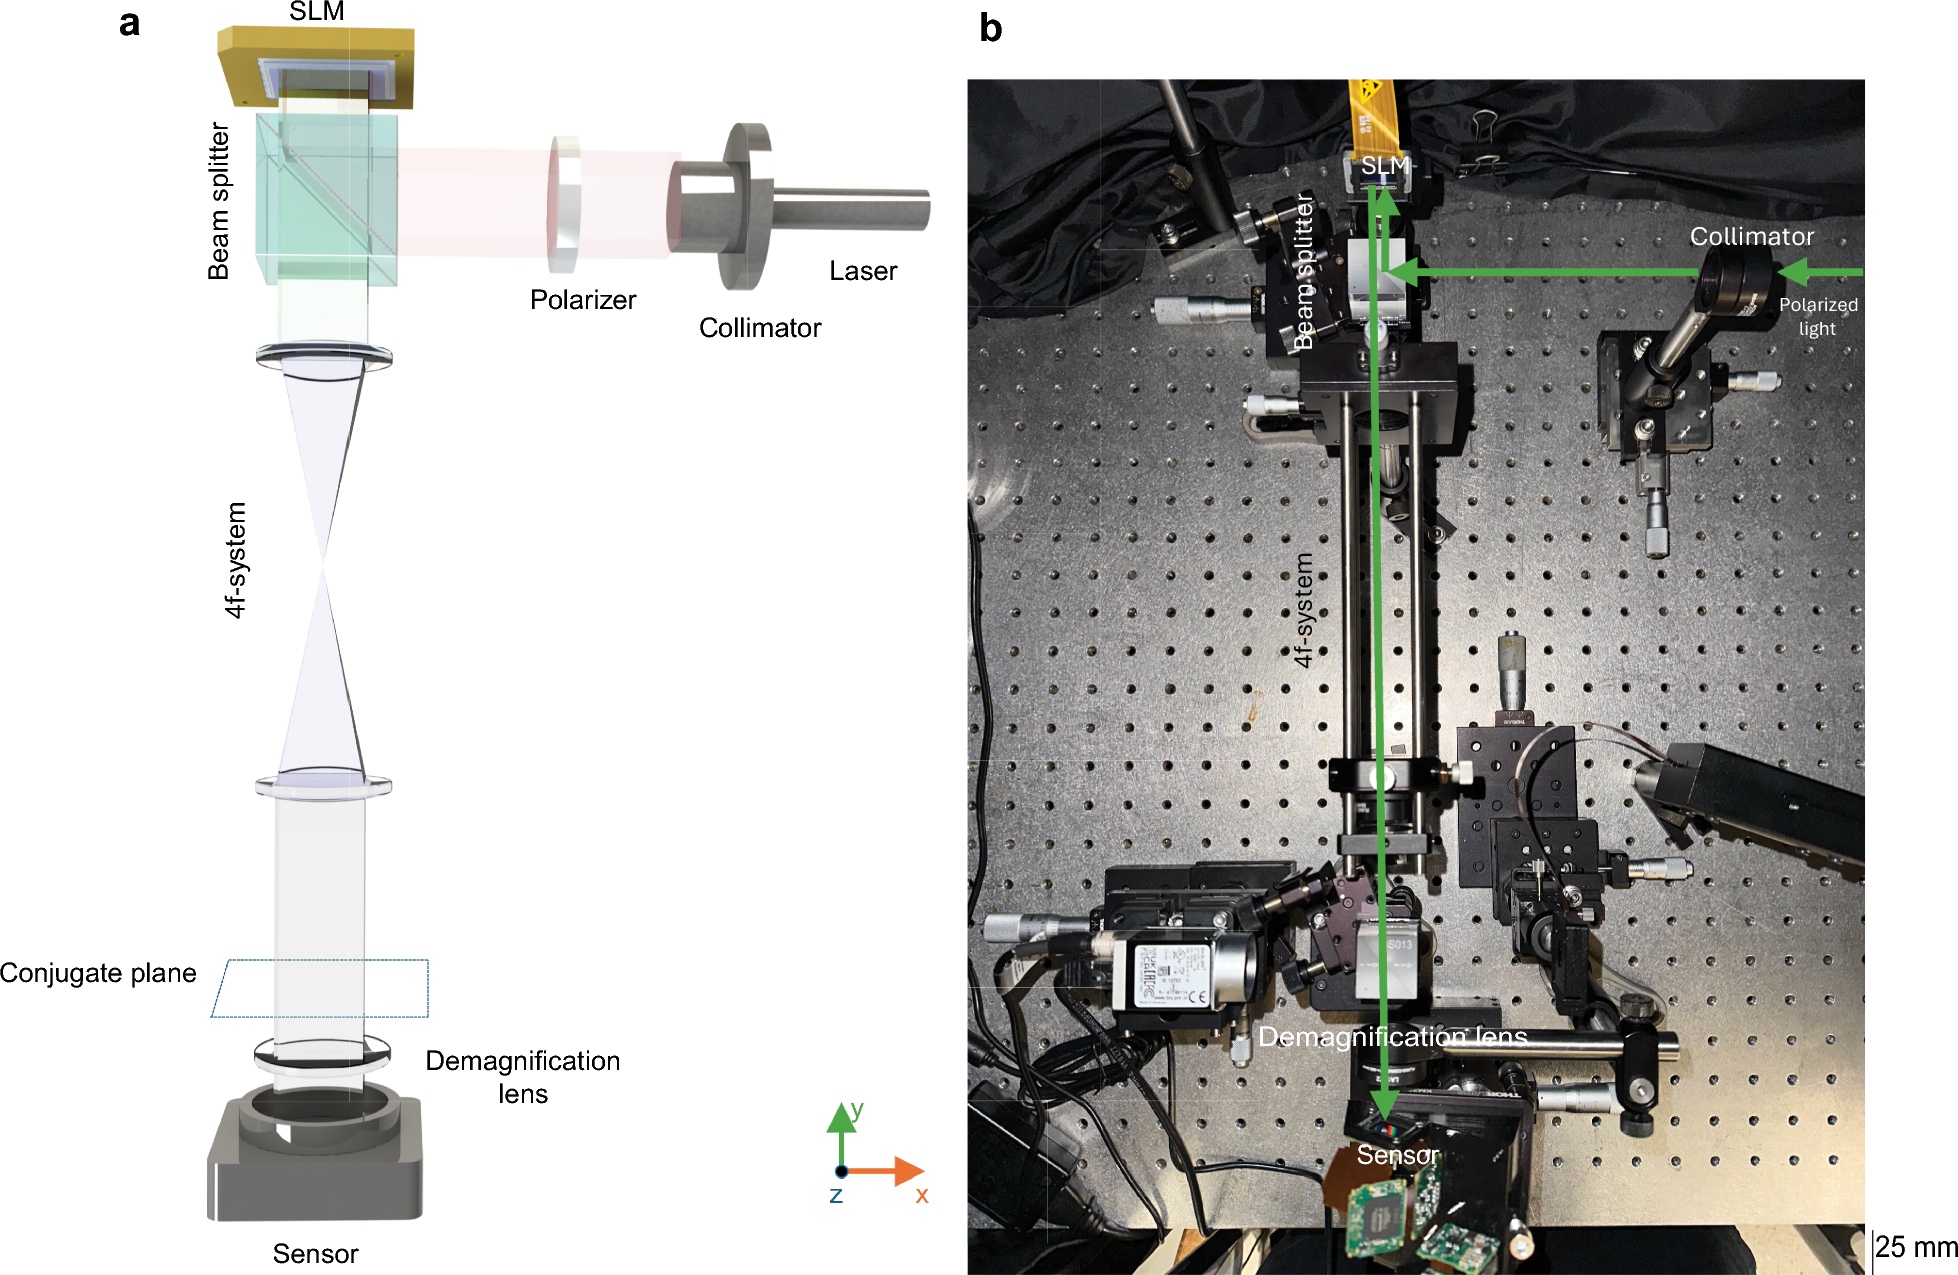
在15路设计中,系统从每段视频抽取12帧,先进行人脸检测与标准化,再通过数字神经网络提取空间和频域特征,生成二维相位图案。15段视频的编码被放到同一块空间光调制器(SLM)的不同区域,光学后端再一次性并行处理这些区域。
输出端为每一路设置一对检测区域,通过两者的光强差得到真假分类分数。由此,光承担的是已经编码后的推理环节,视频读取、特征提取和相位生成仍需要数字计算。这是一套混合系统,而不是不用电脑的“全光视频鉴定器”。
它也不同于光互连:此前介绍的NPO近封装光学主要围绕AI系统中的数据传输;这项工作则利用光传播来执行一部分解码运算。两者都用光,但解决的问题不同。
210段素材与21,000次排列,要分别理解
论文的Celeb-DF盲测保留了105段真实视频和105段伪造视频,均未用于训练。每段测试视频采用100种随机种子重新抽取帧,并打乱它所在的并行通道,形成21,000次视频采样实例,再组织成1,400个15路并行的相位图案。
可核对的关系是:210×100=21,000,21,000÷15=1,400。这些重复采样能考察抽帧、通道位置和相邻光学通道串扰带来的变化,却没有把独立测试素材从210段变成21,000段。扩大测试排列和扩大独立素材覆盖,是不同的证据。
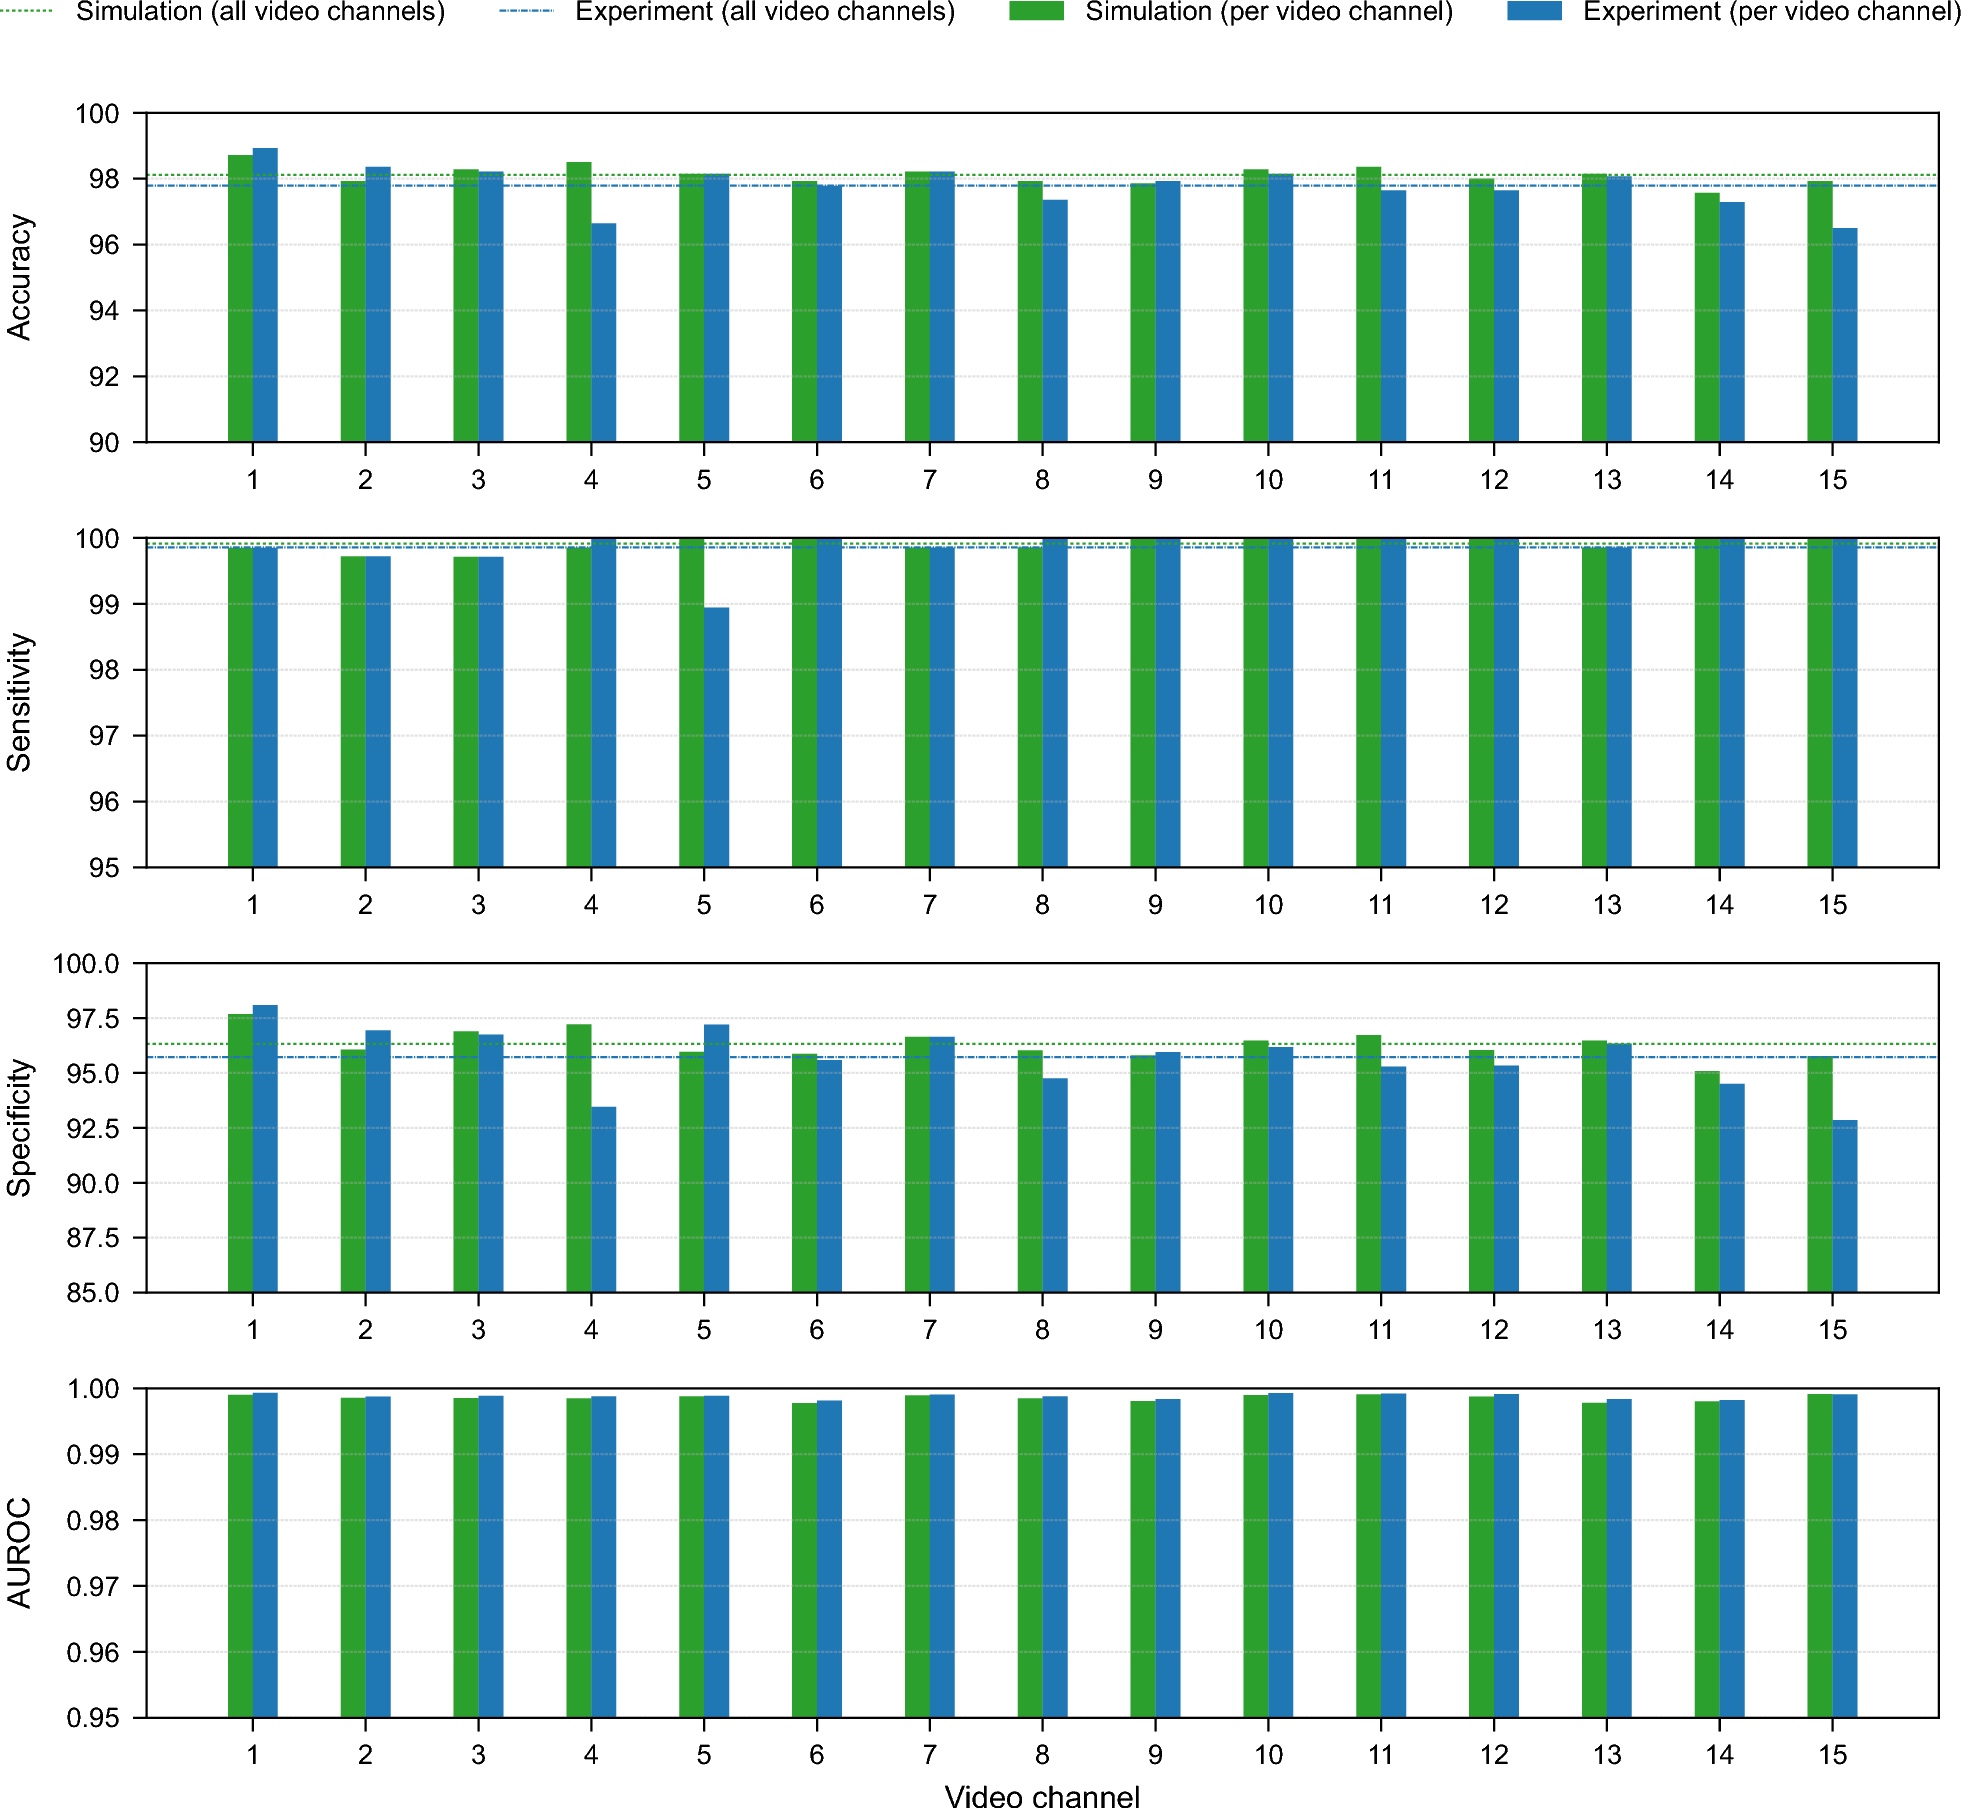
在这项实验里,平均准确率为97.79%,伪造视频的检出敏感度为99.86%,真实视频被正确排除的特异度为95.72%。这三个数字描述的是相应测试条件,不能直接推定未知平台、未来生成模型或任意视频类型上的表现。
解码器节能,不等于整套系统同比例节能
论文在能耗对照中保持数字编码器不变,比较光学解码与不同数字解码器。下面的数字来自作者按GPU计算量、器件功耗和刷新率建立的基线预算,属于估算,不是实验装置插座处的整机功耗实测。
| 能耗口径 | 论文基线估算,每段视频 | 应如何解读 |
|---|---|---|
| 共享数字编码器 | 178.82毫焦耳 | 混合系统和对照数字系统都保留这一环节。 |
| 光学解码器/性能相近的数字解码器 | 1.38—4.11/30.44毫焦耳 | 作者估算解码环节节能约86.5%—95.5%。 |
| 编码加解码的端到端预算 | 混合系统180.20—182.93;数字对照209.26毫焦耳 | 对应端到端节能约12.6%—13.9%,并非九成。 |
这张对照表的重点是共同开销:后端省电,并不会消除前端成本。论文进一步研究了更轻的编码器,但缩小它也会改变准确率与特异度,不能把不同配置的最优数字拼接为一台不存在的系统。
刷新率也要分开:论文的实际光学装置使用60Hz的SLM,而能耗基线讨论采用120—180Hz部件预算。论文还估算了更快调制器的潜力;这些预测不能被写成该实验装置已经实测达到的整机吞吐量。
从实验到视频初筛,仍需要验证什么?
同一论文把并行数从15提高到18时,Celeb-DF实验平均准确率降到96.13%,作者将差异与通道串扰等因素联系起来。这说明“放进更多视频”并非没有代价,光学孔径、检测区布局和对准精度都属于系统设计条件。
在VEO-3生成的视频上,团队先用50段生成视频微调数字编码器,再进行独立保留素材的实验,得到94.80%的平均准确率。因此,这个结果支持针对新生成方式进行适配,不代表原模型无需微调就能识别所有未来生成器。
本文分析:比较合理的应用定位是大规模初筛,将可疑素材交给后续模型或进一步核查。实际部署还需要在目标平台的数据分布、压缩方式、持续器件漂移和误报成本下验证;实验中的真假标签判断,也不能证明视频叙述的事件、地点或上下文真实。
这项研究的增量,是把部分推理从数字运算转向空间并行的光学过程,并给出真实装置与测试数据。它并未提供已经在媒体平台大规模运行的证据。更稳妥的结论是:光计算有望成为视频筛查流水线的一环,而不是一键确认所有内容真实性的工具。
来源与资料说明
- Scalable, energy-efficient optical-neural architecture for multiplexed deepfake video detection,Ghapandar Kashani、Chen、Ozcan,《eLight》6卷27号,正式发表日期2026年9月22日;支持本文方法、图2/图3、测试规模、性能、能耗预算和实验装置参数。论文页面未给出精确发表时刻或时区,本文不作推定。
- UCLA Ozcan研究团队的公开论文目录,确认作者团队列出该研究;目录未标注统一发布日期,按本次访问内容核验。主要实验数字来自同一篇原论文,此目录不是独立复现实验。
资料核验时间:2026年10月8日09:04(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。