NEWS & INSIGHTS
材料AI复现研究:28项提交仅2项直接通过环境检查
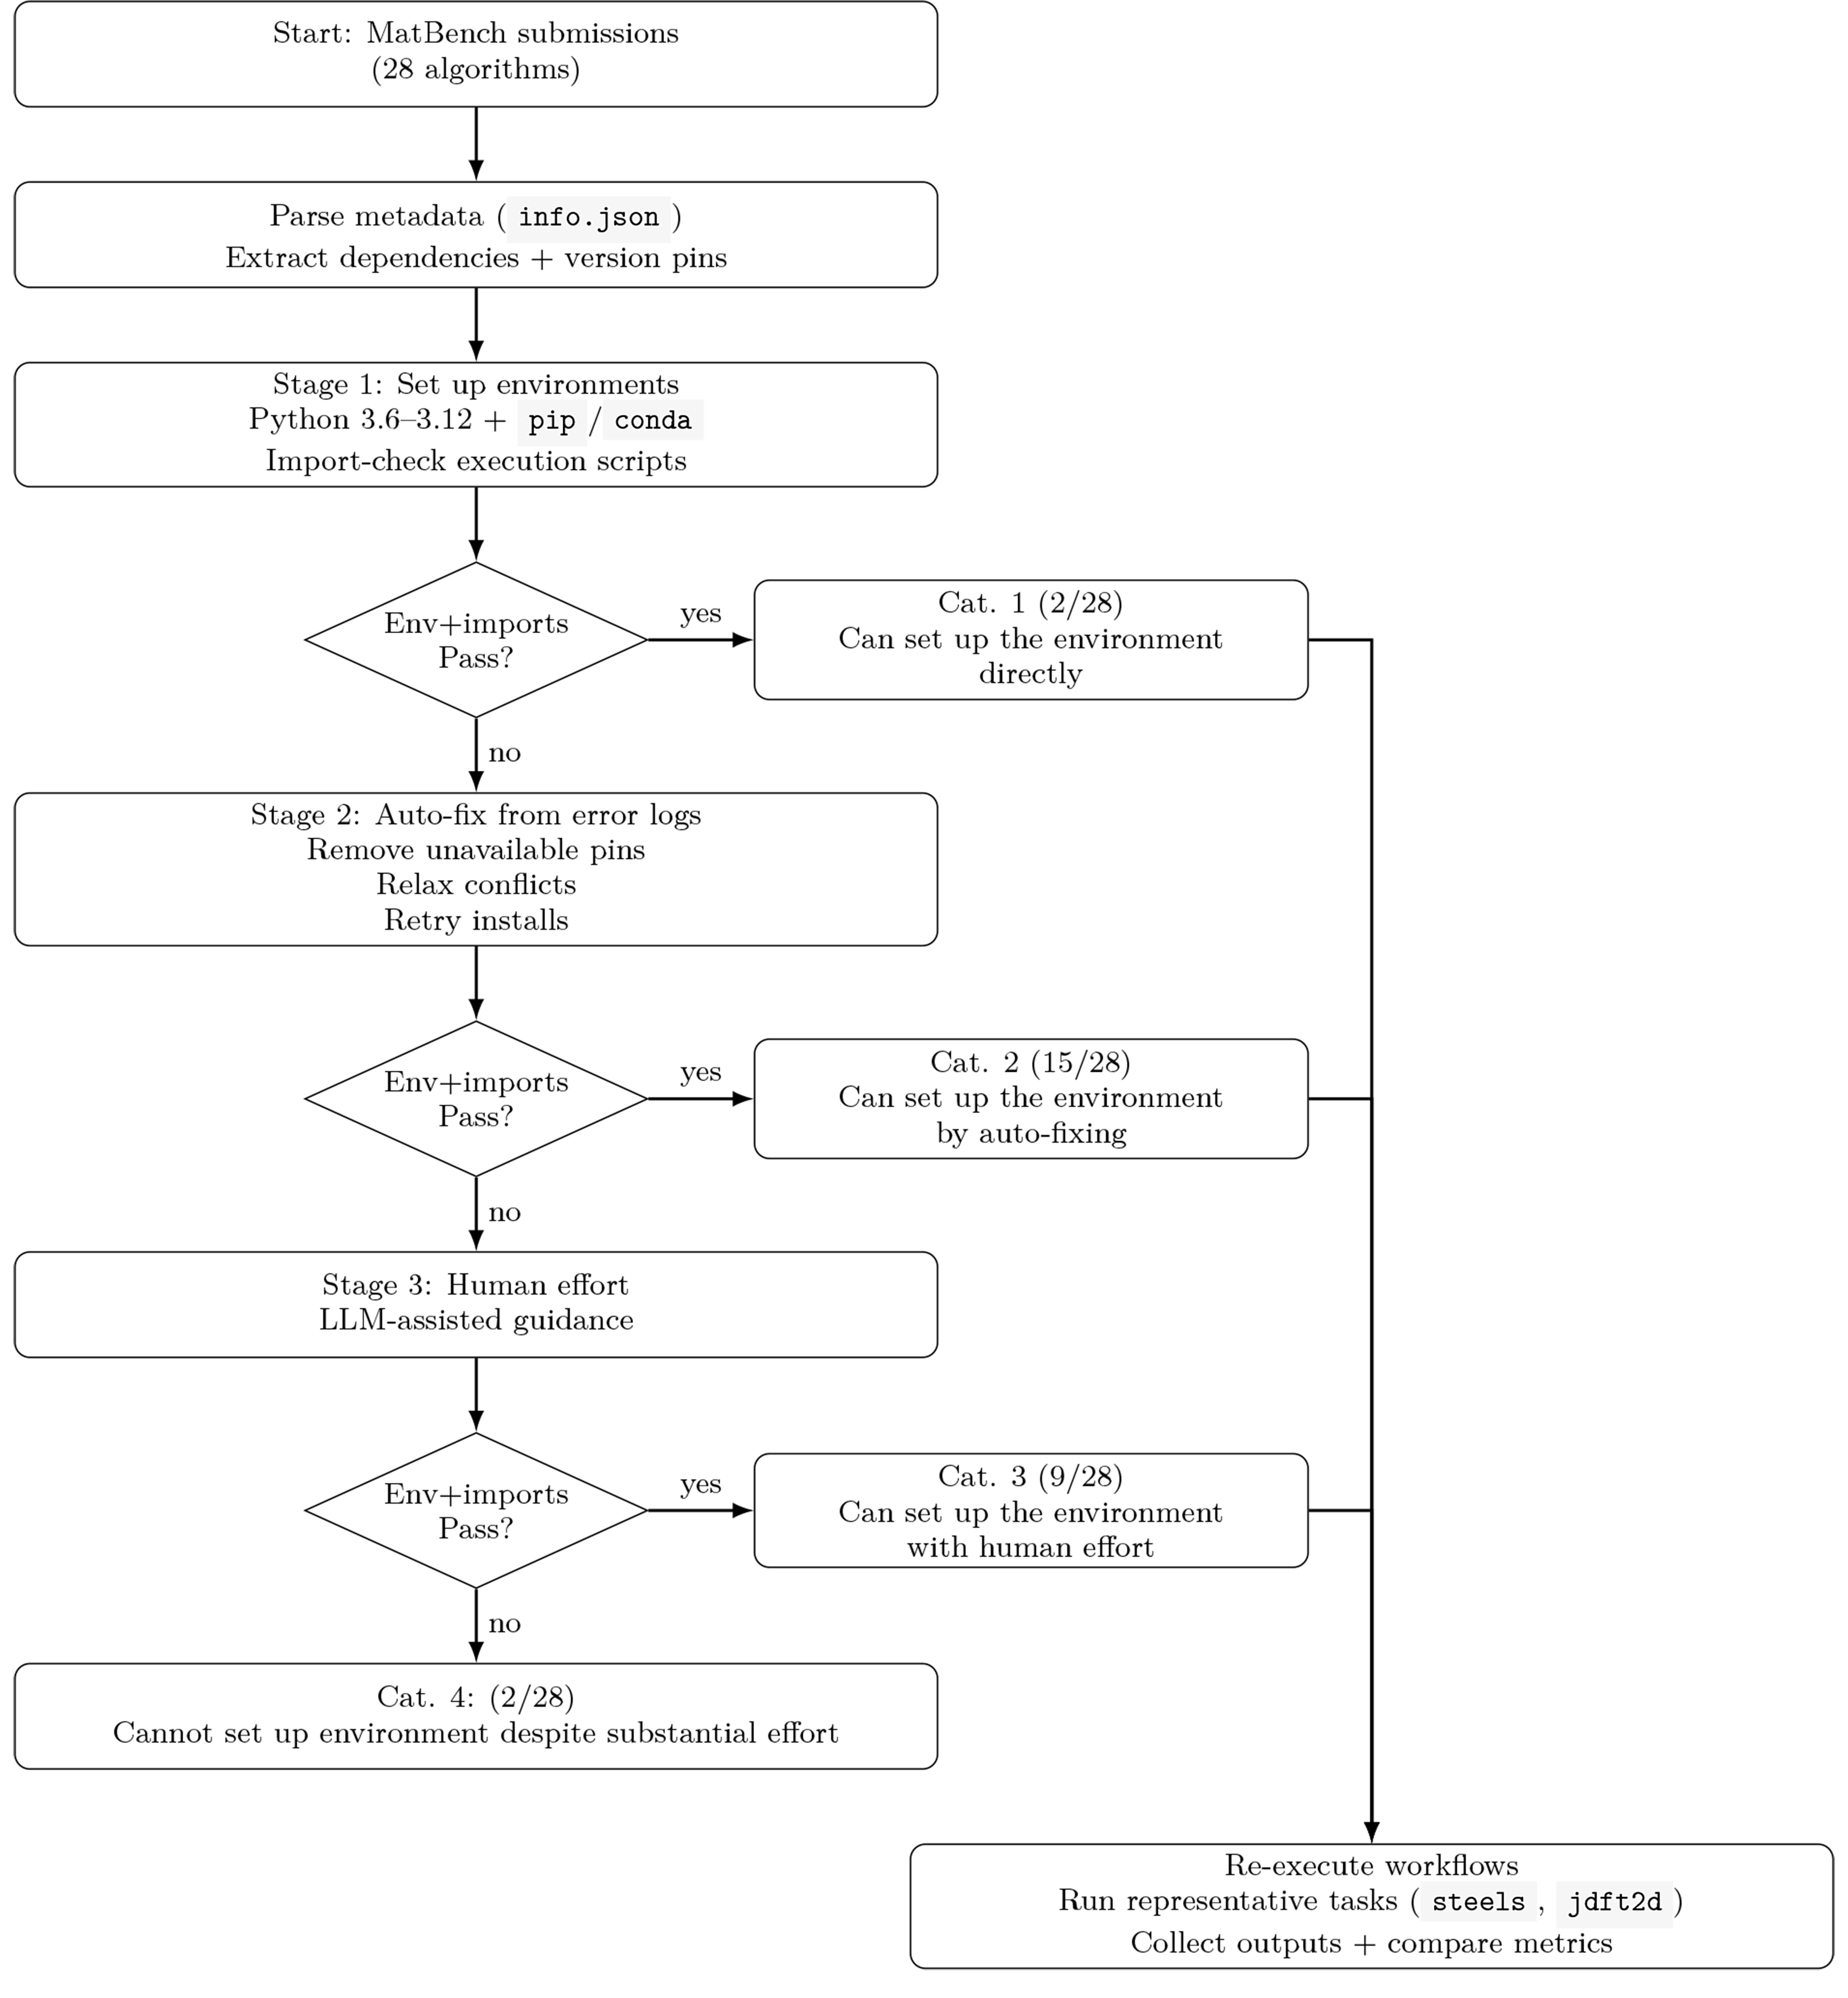
2026年9月28日,《AI Agent》发表了一项材料机器学习基准复现研究:研究团队检查了MatBench上的28项算法提交,只有2项能依据原始依赖说明直接完成环境安装和导入检查。经过分阶段排障,26项最终建立起可用环境,但其中只有13项完成了所选代表任务的重新运行。对准备采用开源材料AI模型的研究者和工程团队,这提示了一个实际问题:公开了代码和榜单分数,距离别人重新得到结果还有多远?
这不是“只有两项研究有效”的结论。论文把环境重建、任务执行和数值比较分开检查;在真正成功重新运行的13项提交中,得到的误差指标与原报告总体接近。值得关注的障碍,首先出现在模型开始计算之前。
2、26和13,分别在回答什么问题?
论文作者来自多伦多大学、美国国家标准与技术研究院(NIST)等机构。他们以公开的MatBench提交信息、代码和原有结果文件为起点,在隔离的GitHub Actions Linux环境中尝试重建软件依赖,覆盖Python 3.6至3.12,并分别考虑pip和conda安装路径。环境阶段的成功条件是安装完成且指定导入检查通过,不是完整训练流程已经通过。
| 检查阶段 | 论文报告的数量 | 这一结果不代表什么 |
|---|---|---|
| 按原始依赖说明安装并做导入检查 | 2/28直接通过 | 未通过不等于模型结论错误 |
| 按错误日志自动调整依赖约束 | 新增15项,累计17项 | 仍不是端到端任务执行成功 |
| 人工排障,参考并验证LLM建议 | 新增9项,累计26项;2项仍未解决 | 不是LLM自主修复了整个项目 |
| 重新执行所选代表任务并生成输出 | 26个重建环境中13个成功 | 不是重跑了所有算法的全部基准任务 |
最后一行的分母尤其重要:13项是26个已重建环境的50%,也是最初28项提交的约46.4%。把“环境能用”的26项直接称为“结果已复现”,或者把“任务跑通”的13项说成“全部基准已验证”,都会跨过论文没有给出的证据。
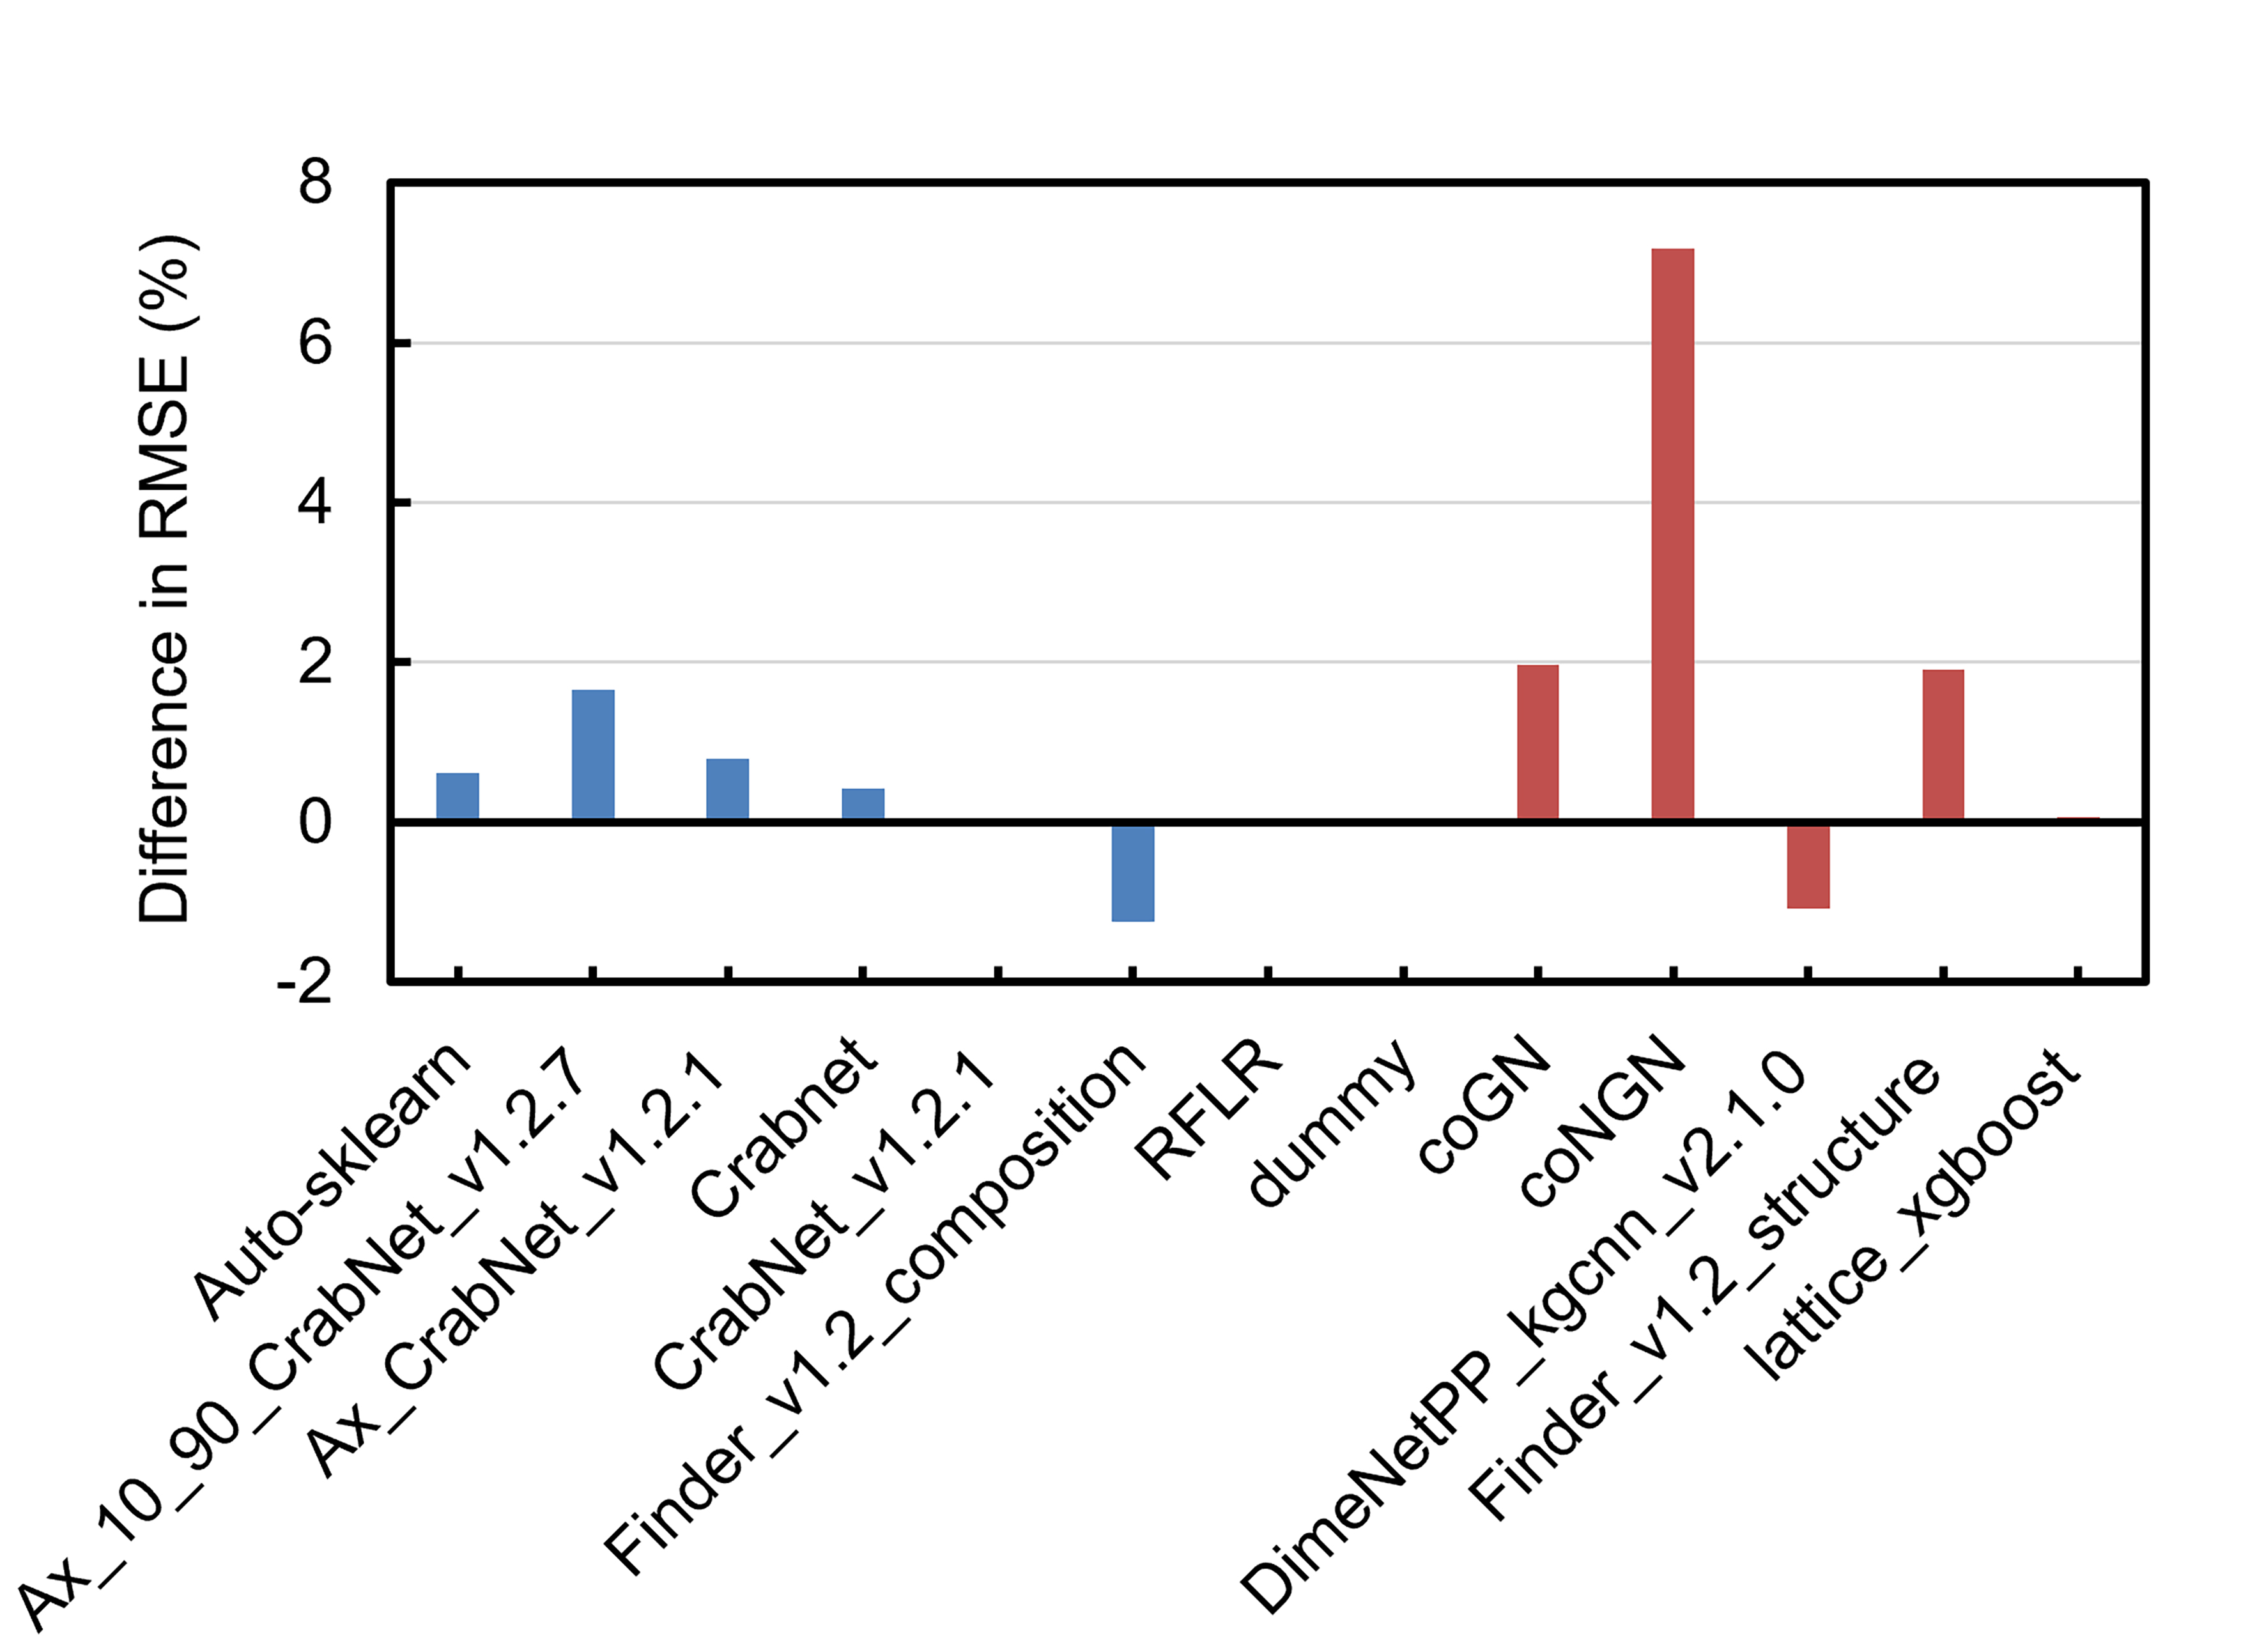
误差差异不超过7.2%,适用于哪些情形?
执行检查采用了较小的代表任务:面向材料成分的算法选用steels,面向晶体结构的算法选用jdft2d。运行平台为Rocky Linux 9.4、NVIDIA A100-SXM4-80GB和CUDA 12.8。它既不是逐项重跑MatBench的全部13个任务,也不是在所有硬件组合上验证。
对成功完成代表任务的13项提交,作者比较了重新运行与原始提交的五折平均均方根误差(RMSE)。论文所用相对差异为“重新运行值减去原报告值,再除以原报告值”,最大绝对相对差异为7.2%。这不是准确率相差7.2个百分点;正负号分别对应误差升高或降低。
因此,这组数值更适合支持一个有边界的判断:当这些特定工作流能够重新运行时,所选任务的报告指标可以得到较接近的数值。它不能证明未跑通的提交结果错误,也不能外推为所有材料AI模型都已通过独立验证。论文还讨论了JARVIS-Leaderboard上的类似困难,但28、26、13这组数量对应的是MatBench检查,不能挪作另一平台的统计。
为什么依赖说明还在,环境却已经变了?
作者遇到的障碍包括缺少依赖、版本约束冲突,以及固定版本无法从标准软件仓库取得。有的历史提交已经过去两三年,代码依赖的软件包接口和安装路径也可能发生变化。即使包能够安装,后续任务执行仍可能被接口或路径问题阻断。
环境重建过程中,团队调整的是软件环境,而不是提交的模型或评估代码。LLM提供排障建议,决定采用哪些修改、实际执行并验证结果的是研究者。这一流程不能被概括为“AI自动修好了24个模型”。两项环境未重建成功,也只表示它们在论文规定的流程下仍未解决,不是证明任何配置都不可能运行。
采用开源模型前,可以多检查哪三件事?
论文建议把环境验证纳入提交时的持续集成,并保存已验证的软件环境。对实际使用者,基于这项研究可以把验收问题具体化,而不是只问“有没有GitHub链接”。以下是本文据此整理的应用检查思路,不是作者新做的实验:
- 环境能否在干净机器上重建?记录安装来源、版本和必要的系统条件。依赖清单描述需要什么,锁文件用于固定更精确的版本与构建;仅有一个requirements文件,不等于软件包将永久可取得。
- 能否完成一个最小端到端任务?不要停在导入成功。明确输入、执行命令和预期输出,先验证小任务,再评估完整训练的成本与可行性。
- 比较的指标是否同口径?保留数据划分、随机性设置、指标定义、软件和硬件信息,分开记录运行失败与数值偏差。环境归档或容器有助于保存用户态软件,但不能自动保存所有GPU驱动、硬件和外部服务条件。
这项研究给开源材料AI提出的,不是“不要相信榜单”,而是把可复现性拆成能够分别核查的交付物:一个可重建的环境、一条确实能走通的工作流,以及在明确条件下可比较的结果。三者都有证据,公开代码才更容易转化为别人真正能使用的工具。
资料来源与核验说明
- Lyu等:When code does not run: reproducibility challenges in materials machine learning benchmarks,《AI Agent》2026,2,23;DOI:10.20517/aiagent.2026.31;原始发表日期:2026年9月28日。本文主要统计、方法和限制来自这项研究。
- NIST作者机构的论文记录:发表日期2026年9月28日,页面更新日期2026年10月8日。该记录用于核对论文身份与日期,不是第二项独立复现实验。
资料核验时间:2026年10月15日09:10(北京时间)。论文仅标示发表日期,未标示具体时分与时区;本文不将机构网页更新时间当作研究首次发表时间。
本文由小花儿AI使用AI辅助整理公开资料。