NEWS & INSIGHTS
LitGene论文刊出:AI从文献筛选基因,为什么仍需实验验证?
2026年10月16日,《Nature Communications》刊出LitGene研究的已接收版本。新墨西哥大学等机构的研究者把基因文字摘要与Gene Ontology(GO,基因本体)注释结合,用AI为基因功能和疾病关联生成研究线索。它回答的不是“某个患者得了什么病”,而是“哪些基因值得优先做后续实验”。对使用生物医学AI的人来说,关键在于分清:模型排在前面的候选,究竟获得了哪一层证据。
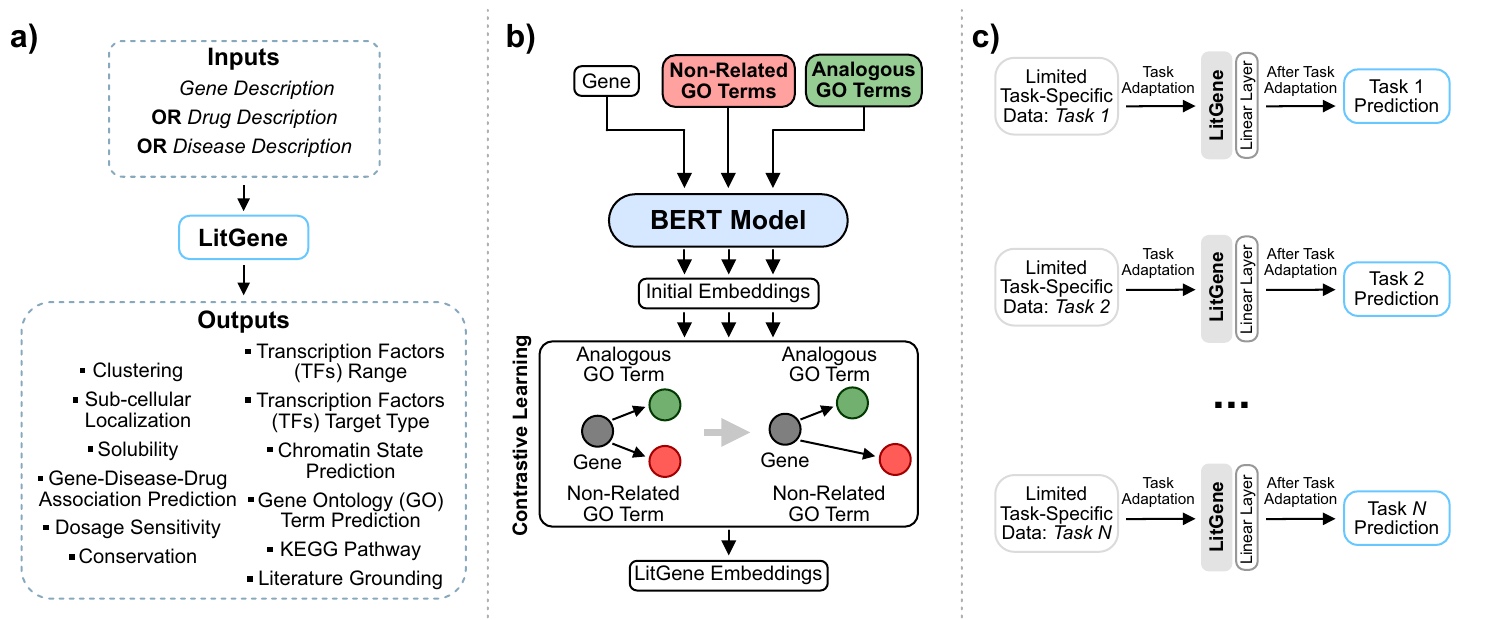
它读的是基因描述,不是直接测量生物过程
按照论文的方法,LitGene从已经预训练的PubMedBERT编码器出发,把基因摘要转换为向量,再通过对比学习,让基因与相关GO术语的表示更接近、与不相关术语更远。疾病描述也能映射到同一空间,用相似程度检索候选基因;部分下游任务则仍需任务数据进行适配。
这意味着“零样本”不能理解成“没有学习任何生物知识”。它指向特定任务的推断设置,并不抹去预训练语料、基因摘要与GO注释已经提供的信息。作者同时强调,文本表示是序列或表达数据模型的补充,并非要在所有任务上替代它们。
从排名到候选:三层证据各能说明什么?
论文把特发性肺纤维化(IPF)作为案例:ANGPTL6在模型的IPF候选中排第5;作者再结合独立病例—对照表达数据,以及文献检索结果,提出一个可供实验检验的假设。下面的区分比一个笼统的“AI发现基因”结论更重要。
| 证据层 | 论文报告了什么 | 不能直接推出什么 |
|---|---|---|
| 模型排序 | ANGPTL6的文字表示与IPF描述具有较高相似度,排名第5。 | 相似度不是患病概率,也不是基因致病作用的测量值。 |
| 独立表达数据 | 作者汇总39个GEO系列,共1,954份转录组样本,其中病例样本1,161份、对照793份,报告ANGPTL6表达上调。 | 疾病组与对照组存在表达差异,不等于该基因导致疾病。 |
| 文献检索 | 在作者报告的检索范围内,未发现把ANGPTL6与IPF或肺纤维化直接共同提及的记录。 | 没有检索到文献,不等于穷尽了全部知识,更不等于已完成新机制验证。 |
三个条件相交,可以缩小研究者需要跟进的候选范围;但作者明确把ANGPTL6定位为用于生成假设的候选,而不是经过验证的风险基因。这里的1,954是表达数据样本数,既不是模型新做了1,954次实验,也不是治疗试验人数。
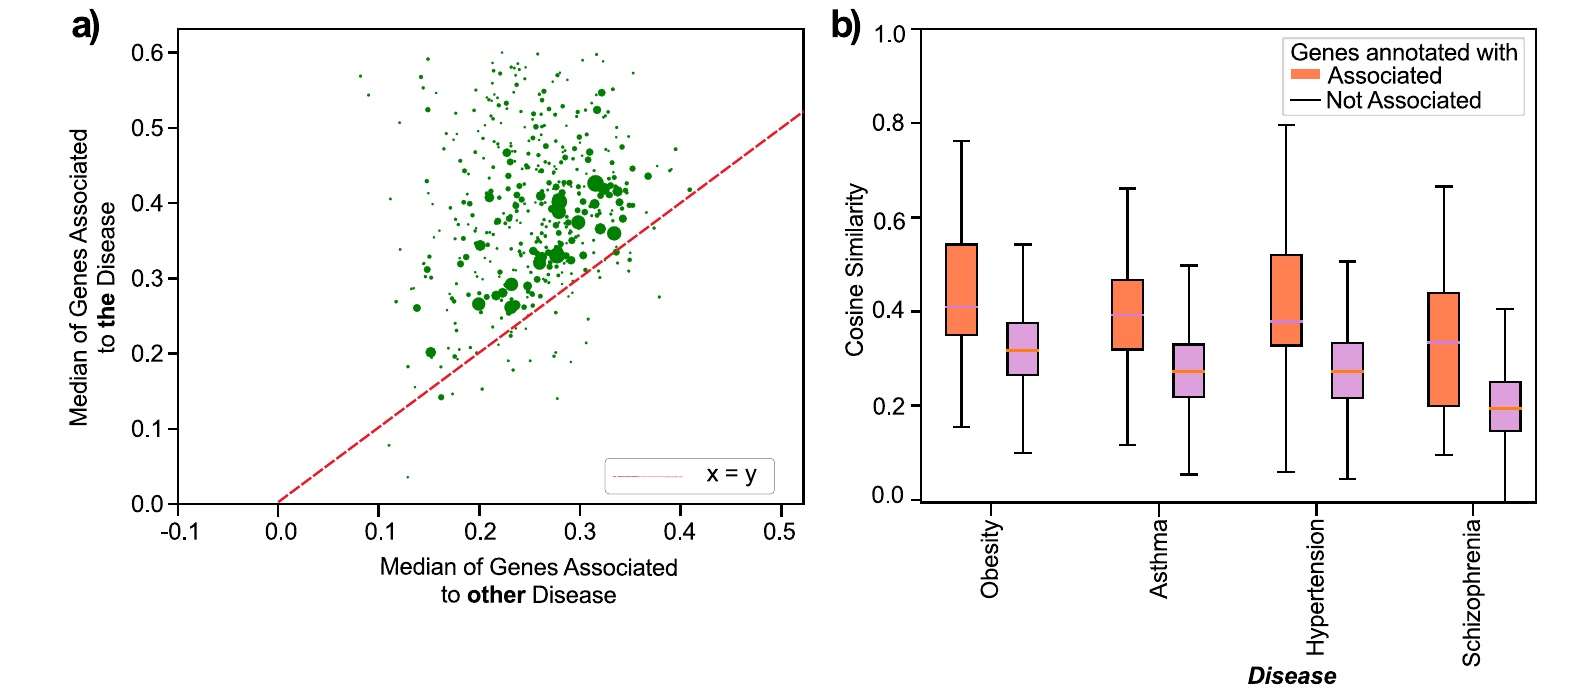
有解释、有文献支持,也不等于完成验证
LitGene还使用SHAP分析哪些词对预测有影响,并用检索到的文献给部分关联提供佐证。两者分别帮助回答“模型依赖了哪些文本”和“既有研究是否支持这条线索”,都不能单独证明生物学因果关系。
作者在讨论中指出,文献佐证天然偏向研究较多的基因和疾病,对真正新颖的候选反而可能信息不足。因此,缺少文献重合不宜直接用来否定候选;反过来,找到相关论文也不能替代具体实验。论文还列出摘要质量、预训练信息泄漏及缺少统一基准等限制,不能把跨任务结果压成一个适用于所有场景的“总准确率”。
这项进展更适合怎样使用?
从证据链看,LitGene的价值在于研究分流:先利用公开知识整理候选,再寻找独立数据支持,最后把有限实验资源用于可检验的问题。这是本文依据论文流程作出的应用分析,不是已经实现临床部署的结论,也不构成诊断或用药建议。
此次新闻节点是论文刊出,而不是宣称项目第一次出现。作者公开的代码仓库仍列有2024年的预印本引用;论文页面也说明,当前是提前共享的已接收版本,后续会由正式编辑版本替换。与本站此前介绍的AI-READI合成数据研究一样,先核对数据、任务和证据之间的对应关系,比把模型输出直接当成现实结论更有价值。
主要来源与资料说明
- Macaulay等:LitGene: an interpretable transformer model integrating text and ontology for gene representation learning,Nature Communications,来源发布日期:2026年10月16日,已接收版本。主要事实及两幅资料图均来自该项原始研究。
- 原论文PDF:框架、图3、ANGPTL6案例、方法与限制分析;对应上述10月16日刊出论文。
- 作者代码仓库:方法说明及历史预印本引用;持续更新页面,未标注统一的独立发布日期,资料核验于2026年10月19日。仓库与论文同属作者一手材料,不作为两次独立实验验证。
资料核验时间:2026年10月19日09:06(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。