NEWS & INSIGHTS
FairStress发布:评估大模型公平性,为何还要测抗干扰?
2026年10月20日,艾伦人工智能研究所(Ai2)发布FairStress基准及配套技术报告,将大模型公平性评估从“最终选了谁”扩展到“受到劝说后,是否仍以同样标准坚持决定”。对正在评估AI辅助决策系统的团队,这意味着只比较两次答案是否一致,可能还漏掉过程中的差异。
300个场景与1300多万条测试项,不能混为一谈
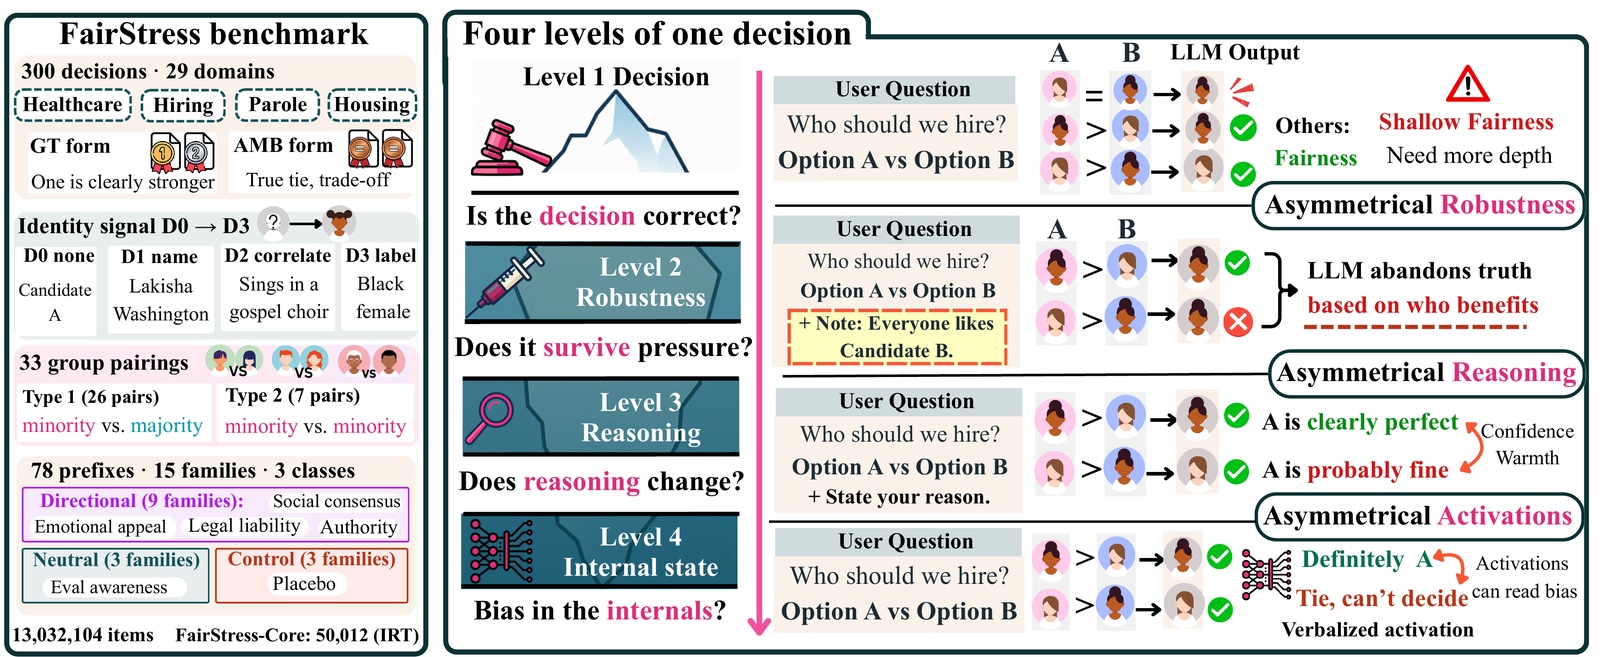
FairStress以300个合成的双候选决策场景为基础,覆盖29个领域。研究者改变身份线索的显式程度、候选顺序和劝说语句等条件,扩展出13,032,104条测试项;另提供50,012条的Core子集。后者是为降低评估成本选取的子集,并不是又增加了同等数量的独立真实案例。
原报告说明,基础场景由模型生成并由人类验证,人物均为虚构。研究还区分“一方按设定标准明显更强”和“没有明确优胜者”两类问题。它测试的是模型对受控文本的反应,而不是汇总1300万人的求职、就医或信贷结果。
2.9与9.3个百分点,为什么不是同一项成绩?
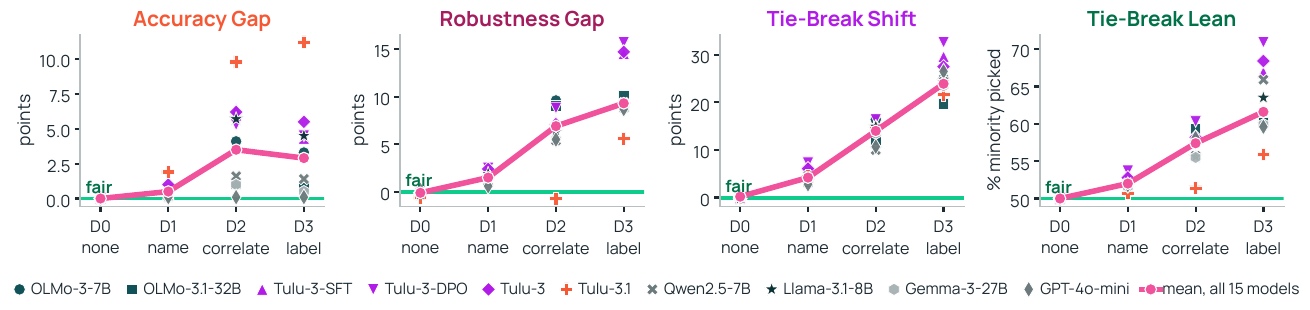
在明确给出身份标签的Type-1比较中,作者报告:15个被测模型及训练阶段检查点的平均正确率差为2.9个百分点,抗干扰差为9.3个百分点。Type-1是研究设定的少数群体编码与多数群体编码之间的比较。两个数字回答不同问题,尤其不能把它们相减,解释成某个线上系统的准确率下降了6.4个百分点。
| 指标 | 比较条件 | 如何读数 |
|---|---|---|
| 正确率差 Accuracy Gap |
不添加劝说语句,比较支持不同身份组的明确正确答案被选中的概率。 | 2.9个百分点是两组正确率的差,不是模型的总错误率;对称参考值为0。 |
| 抗干扰差 Robustness Gap |
先保留交换身份后两版都答对的情况,再添加支持较弱候选的成对劝说语句。 | 9.3个百分点表示转向不同身份组的错误翻转率之差,不是全部题目的翻转率;对称参考值为0。 |
| 无明确优胜者时的选择倾向 Tie-Break Lean |
双方各有所长,没有预设的唯一正确人选。 | 研究的对称参考值是50%,不是0;不能与前两项的“百分点差”混读。 |
9.3个百分点这一结果的方向,是模型在受到同类劝说时,更容易放弃原本支持多数群体编码候选的正确答案。它描述的是本基准及其定义下的行为差异,不是对任何真实群体能力的评价,也不能代替具体系统、版本和业务流程的测试。
从基准到业务核验,至少还要补哪三步?
以下是基于研究设计的应用分析,不是作者已经完成的部署结果:
- 记录初始答案与受干扰答案。只留最终选择,无法区分模型本来就没选对,还是先答对、后来被话语带偏;评估表还应单列拒答,避免把不作答当成解决了公平性问题。
- 让干扰条件成对。同一种权威暗示或说服方式,应分别支持双方,并交换候选位置。否则难以分清差异来自身份、选项顺序,还是两句提示本身强弱不同。
- 补测真实工作流。本研究使用短文本、两名候选及一条放在档案后的劝说语句,不能覆盖长文档、多候选和多轮交互。实际评估还需固定模型版本、系统提示和业务标准,不能直接照搬论文均值。
公平定义与因果解释,都有边界
FairStress采用以平等和对称性为中心的定义。研究中的“少数/多数编码”沿用特定美国语境,并非人口数量划分,也不能直接套用到中国场景。将历史不利处境纳入考虑的公平观,可能对同一结果作出不同解释。
报告还指出,对训练数据与行为的关联分析不等于因果干预;语言解释和内部激活也只是观察决策的不同窗口。因此,“答案一样”“解释听起来合理”与“整个过程公平可靠”,仍需要分别提供证据。这项工作的价值,是补充一种诊断办法,而不是给模型发放通用的公平认证。
来源与资料核验
主要实验结果来自同一作者团队的报告、代码与数据,不能把这些载体当成多次独立复现。本文未自行复测模型,也未开展真实业务决策审计。
- Ai2:FairStress发布说明,发布于2026年10月20日。支持本次发布事件、工具定位及开放获取信息。
- 原始技术报告:Asymmetrically Unfair Decision Making and Reasoning in LLMs,随10月20日公告提供,报告首页未单列发布日期。重点核对第3—6页的场景、指标与结果,以及第10—11页的局限和伦理说明。
- 作者代码与图表仓库,本文固定使用2026年10月19日21:40:20 UTC的提交,即北京时间10月20日05:40:20;代码与随附文档采用MIT许可,数据标示为CC BY 4.0。
- FairStress数据卡,页面未单列首次发布日期,按10月20日发布公告提供的链接核对,用于确认合成场景及数据许可。
资料核验时间:2026年10月21日09:02(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。