NEWS & INSIGHTS
本地AI仿真研究:将失败重试计入每次成功的成本
北京时间2026年11月19日凌晨,阿尔伯塔大学ELITEGrid实验室三位研究者向arXiv提交一项本地AI智能体研究,测量它们操作电力电子仿真时的功率、能量、token和时间。对考虑把工程资料留在本地的团队,论文回答的核心问题是:完成一次合格结果,到底应计算哪些投入?
这是一篇预印本。v1提交于2026年11月18日18:27:40 UTC,折合北京时间11月19日02:27:40;提交记录并不能确定首次公开可读的精确时刻。以下实验均归因于Yuzhuo Li、Pasan Gunawardena和Yunwei Li的作者团队,本文没有运行模型、仿真或独立复现。
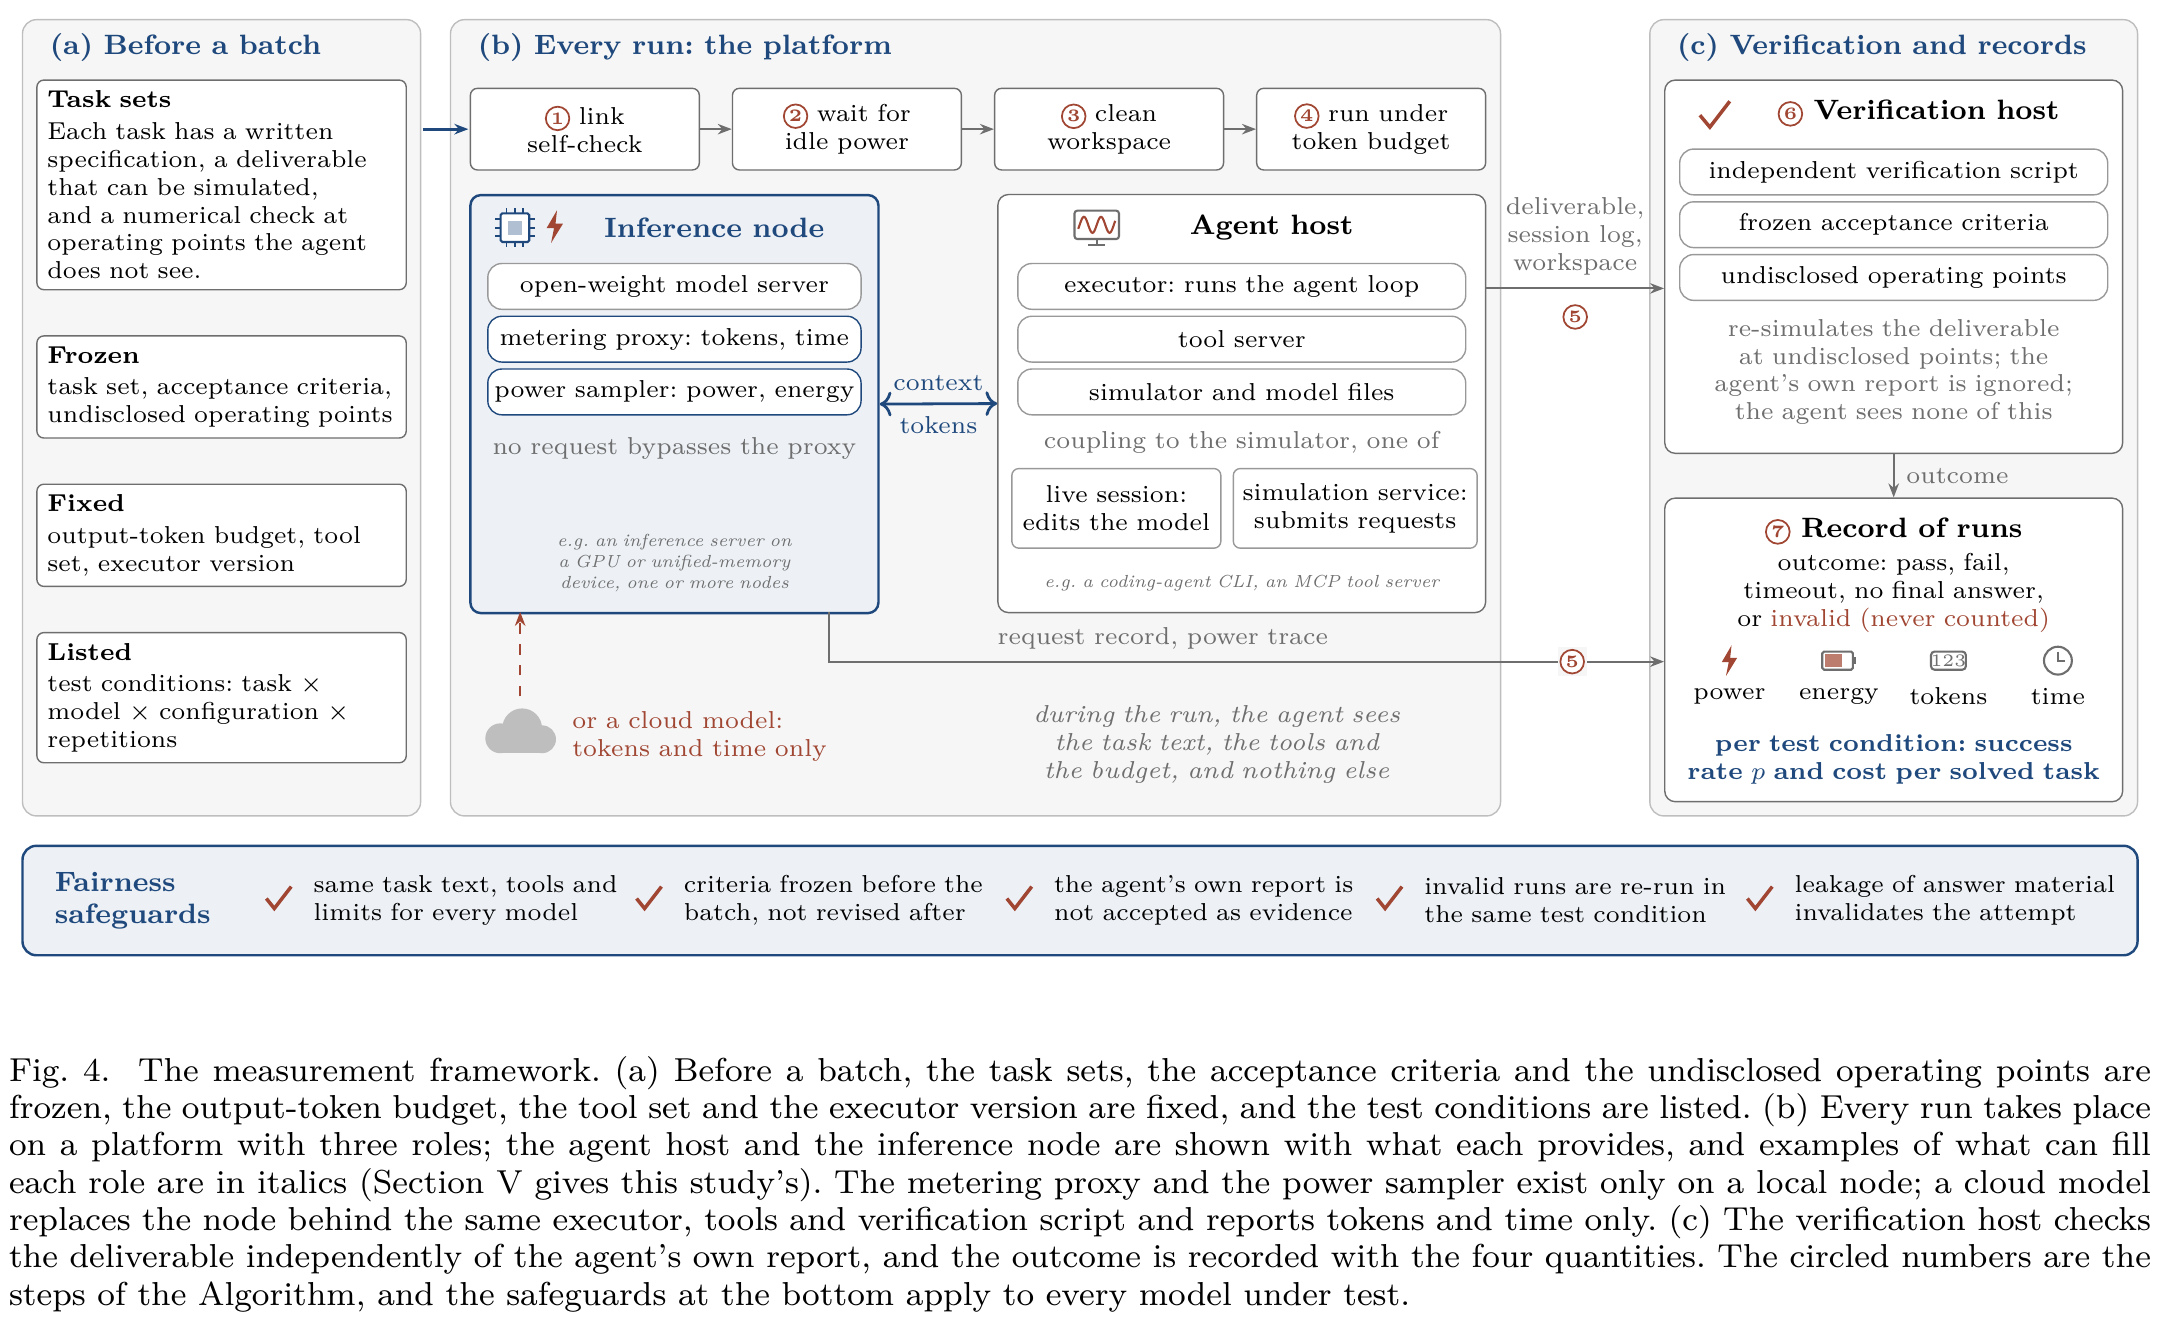
测的是仿真外层智能体,能耗也有边界
智能体通过工具建立或修改模型、提交仿真、读取结果并决定下一步。转换器控制仍在仿真器自己的时间步内执行,AI处于分钟级的实验外层循环;研究没有证明它可直接承担实物电力设备的实时控制。
转换器与数据中心部分共记录2,041次有效评估运行,其中882次有能耗记录;另有13项PSCAD/EMTDC系统级任务,本地各尝试两次、云端各一次。这些运行数量不能全部当作能耗样本。主要本地配置是在单台DGX Spark的GB10上,用vLLM服务NVFP4量化的Qwen3.8-Flash-Next模型(论文简称Flash-Next)。
| 记录 | 单位与含义 | 不能替代什么 |
|---|---|---|
| 功率 | W,设备GPU域遥测;主配置解码平台约33—38W | 不是整机墙插功率,也不是每项任务耗电量 |
| 能量 | kJ或Wh,运行窗口内对上述功率积分 | 不含仿真主机、机箱其余部分及独立验收阶段用能 |
| token | 输出含推理和可见消息;输入还须区分缓存命中 | 输入累计数不等于实际重新计算的量 |
| 墙钟时间 | 模型生成、工具执行及等待占用的实际时间 | 不能直接当成人工工时或仿真计算时间 |
论文还比较了本地与云端的时间和token,但没有测量云端能耗,因此不能据此判断哪一种部署更节电。两边使用的模型不同,执行器版本也不同,分别为Codex 0.153.3与0.159.3;差距不能单独归因于模型运行的位置。
每次通过的成本,要分摊失败运行
作者把同一测试条件下的累计能量除以通过次数,得到“每次成功对应的能耗”。分子包含有效失败运行;智能体自己宣布完成不算通过,交付物须由另外的验证脚本按预先固定的条件检查。
例如,Flash-Next在约11.5万输出token预算的构建条件下,48次运行通过1次。论文报告分摊后的能耗为8,357kJ,换算约2.32kWh;那一次通过运行本身约163kJ,约0.045kWh。两者回答不同问题:一次做对消耗多少,与把有效失败也算进去后每次通过摊到多少。
这里的换算采用1kWh=3,600kJ,仍只适用于论文的GPU域测量范围。它既不是整套设备电费,也不是“同一个成功运行连续用了约70小时”;论文另报的约70小时同样是包含失败的累计时间除以通过次数。
如果用概率表示,作者的期望式为:成功运行平均能耗+(1−成功率)÷成功率×失败运行平均能耗。它要求失败能被识别。将同一批运行均值代回该式,是一种核算一致性检查,不能当成新的独立验证;只有一次通过时,估计也尤其不稳定。
预算翻倍的结果,为什么出现两个成功率
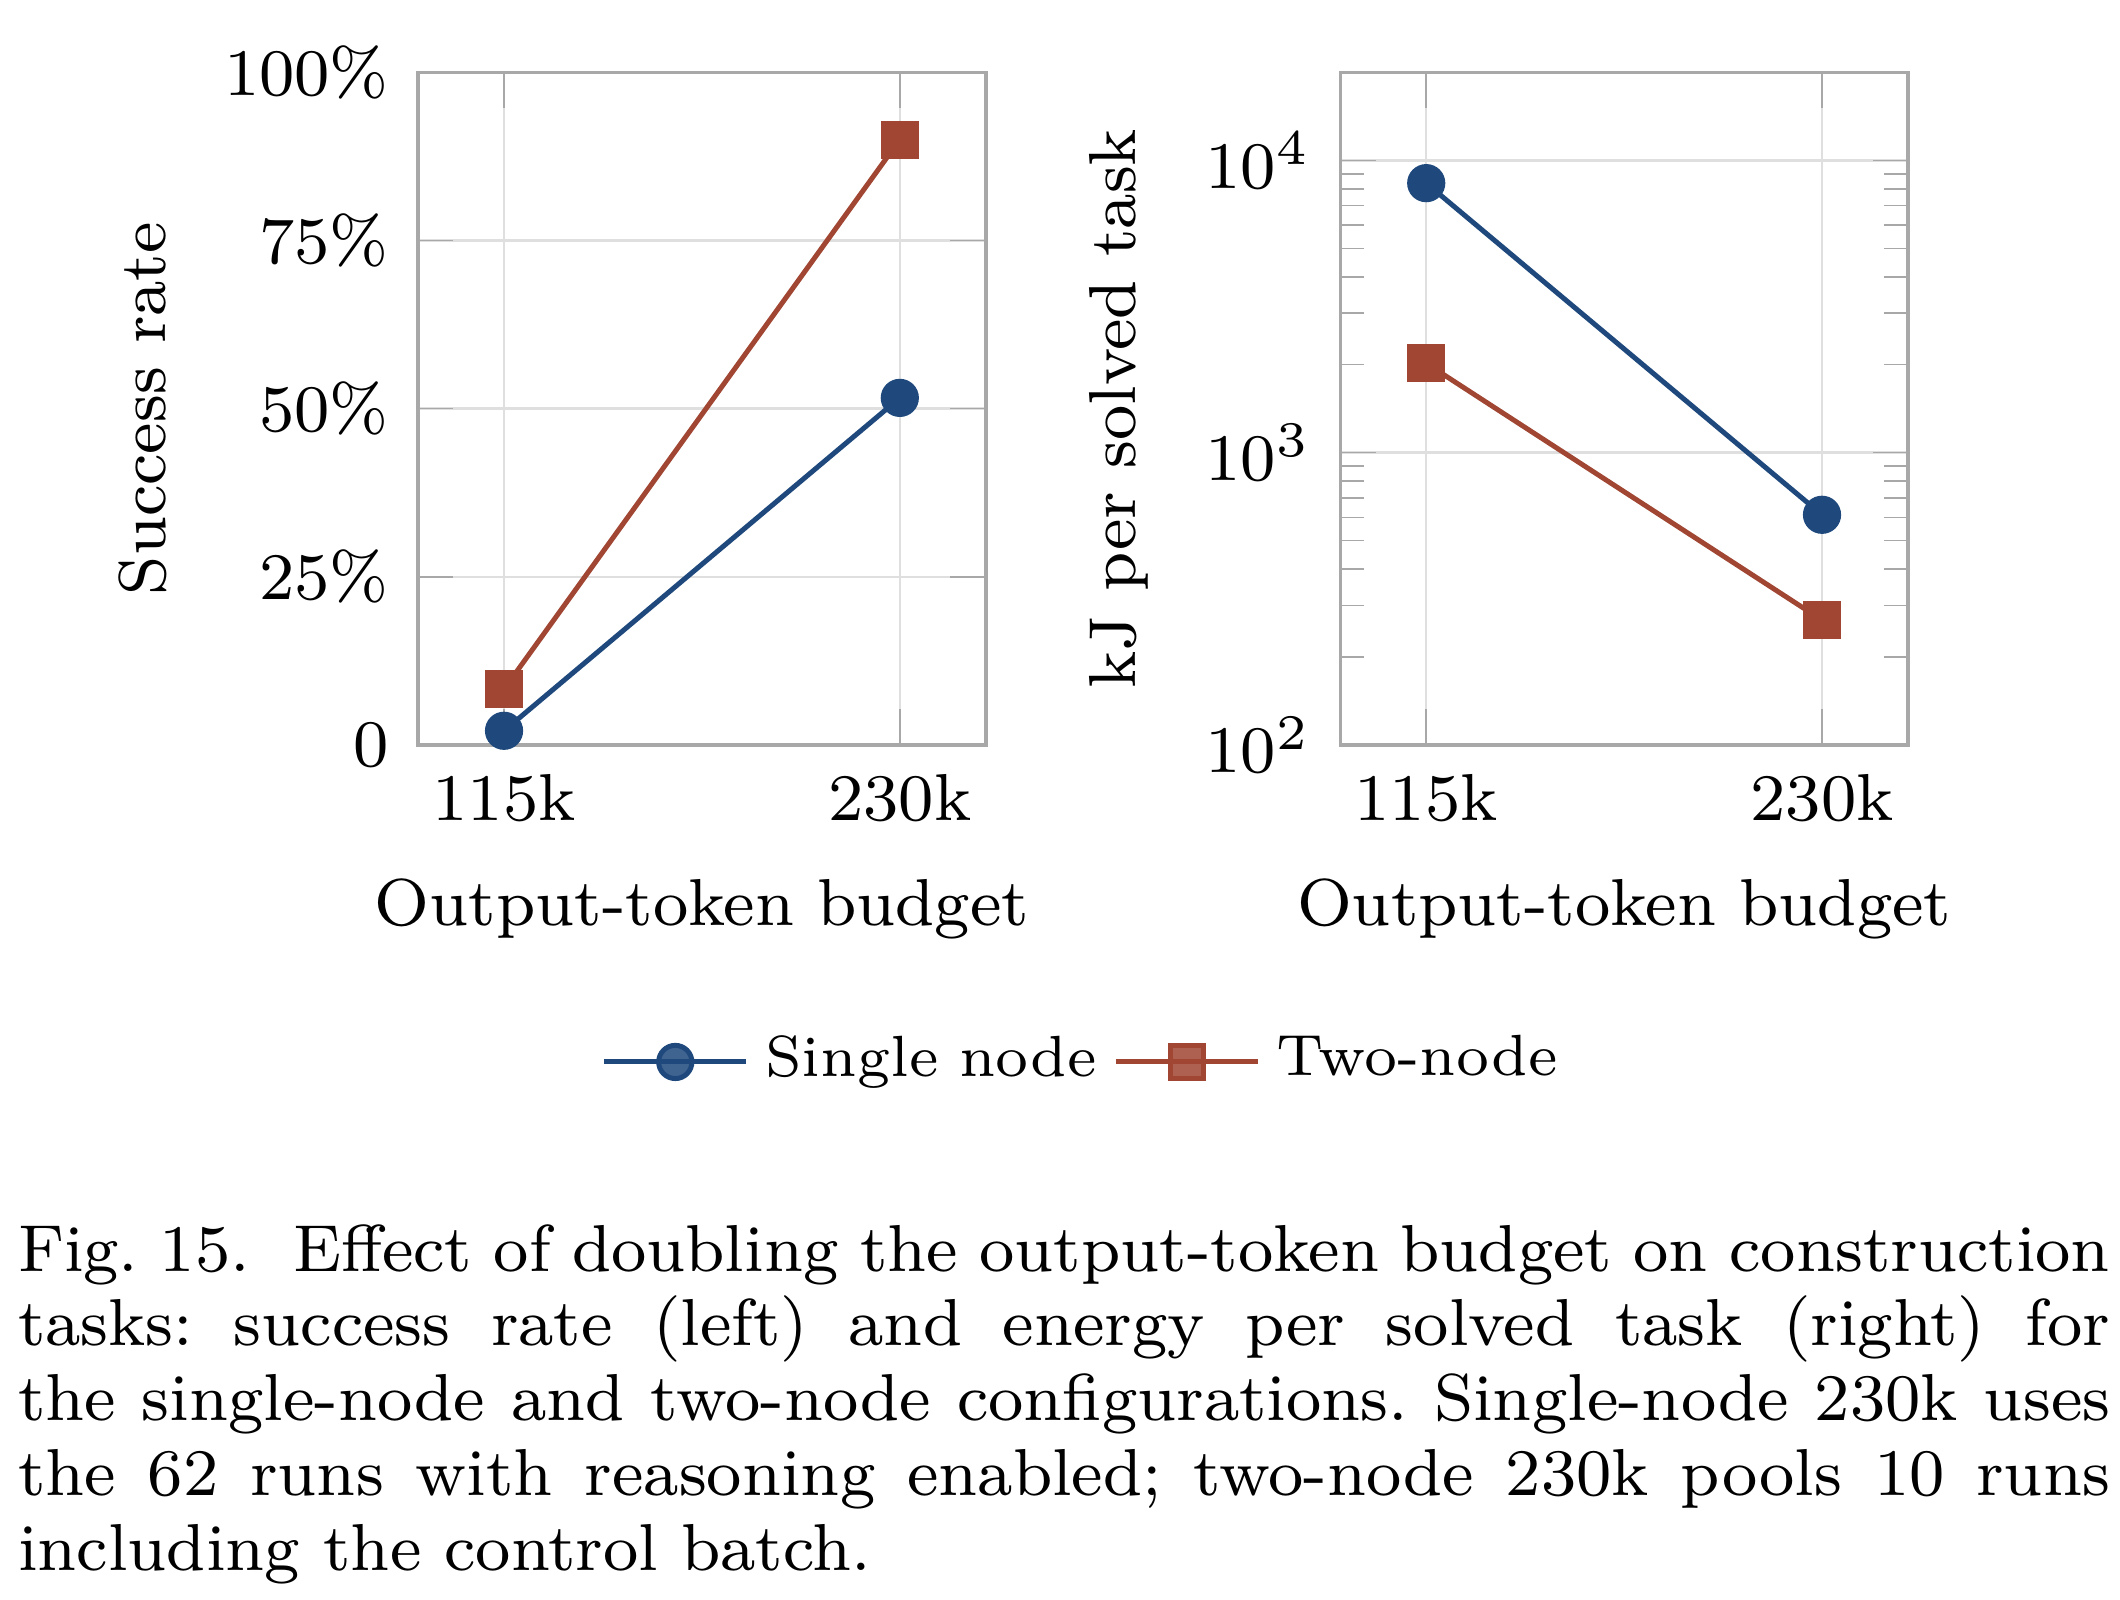
图15显示,输出预算加大后,构建任务通过比例上升,每次成功分摊的能耗下降。阅读它时必须保留运行集合,而不是把所有“23万预算”数字放在一起。
| 单节点构建条件 | 通过/有效运行 | 统计范围 |
|---|---|---|
| 约11.5万输出token | 1/48,约2.1% | 第V-D节的较小预算条件 |
| 约23万输出token,开启推理 | 32/62,约51.6% | 图15的单节点较大预算条件 |
| 约23万输出token,全部运行 | 33/68,约48.5% | 图17、18及附录C说明的汇总集合 |
这些分母是重复运行次数,并非48、62或68个不同工程项目。图18给出的661kJ对应33/68的汇总集合,不能无说明地配到32/62旁边。双节点配置还使用了不同的模型,也不能只看图中的高通过率就归结为“多加一台机器”的作用。
另一项干预是在每次工具返回时告知已用及剩余预算。两个构建任务上的通过次数由14/24变为12/16,但差异未达论文采用的显著性阈值(P=0.33);达到预算上限而停止的次数则从10/24降到2/16。它提供了改善结束时机的证据,还不足以支持“提醒预算必然提高正确率”。
能迁移的是测量方法,部署效果仍需本地验证
本文据此认为,对自己的工程任务做小规模比较时,应同时保留交付物是否通过、失败运行消耗、执行器与模型配置、输出预算、缓存比例和测量边界。只比较额定功率、一次成功用时或token单价,都无法得到同一含义的“每次成功成本”。
这项研究的大部分本地运行由一个主要模型和一种设备承担;部分能耗记录缺失,部分干预发生在不同批次,解码功率也会漂移。研究中的无人值守仿真结果,不等于已部署产线成果;硬件在环、实验台和有工程师参与的流程仍列为后续方向。
验证脚本本身也有覆盖边界。附录B记录,一项调压任务的云端交付物和本地第二次交付物通过了未公开测试,却仍存在符合任务条件的反例;作者按预先规则保留结果,并为后续使用修订任务。因此,“通过次数”应连同验收范围阅读,不能视为工程保证。
相关的仿真验证边界,可参阅本站MechFoundry结构仿真研究分析。本研究增加的是本地推理设备的实测成本及失败分摊方法,不能据此直接作跨硬件、跨任务的模型排名。
来源与资料说明
- 原论文v1:Local AI Agents in Power Electronics Simulation: Deployment, Measurements and Costs;HTML全文、PDF全文。来源提交日期:2026年11月18日18:27:40 UTC(北京时间11月19日02:27:40);首次公开可读的精确时刻未据此确认。主要依据第III-D、IV-D、V-B、V-D、V-F、V-G节,表VI、VII及附录B、C。三个页面属于同一项目的一手来源,不是独立证据或复现。本文不据论文提供框架的表述宣称完整数据、任务或代码已公开可下载。
资料核验时间:2026年11月20日09:17(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。