过去的语音助手经常让人经历三个割裂步骤:先听完、再沉默处理、最后给出答案。Google在2026年9月15日发布Gemini 3.8 Live与Gemini 3.8 Live Extended Thinking,试图把这三步折叠成一段不断线的对话——模型可以继续说话、接收视觉画面,同时在后台调用工具执行任务。
这次更新真正值得关注的,不是声音更像真人,而是语音接口开始获得“行动链”。按照Google官方发布,基础版3.8 Live面向低延迟和规模化使用,Extended Thinking则为复杂、多步骤任务增加更强推理能力。两者都能处理连续语音,后者还会在任务执行期间用简短提示和进度播报维持交流。
“边说边做”比单纯降低延迟多了一层
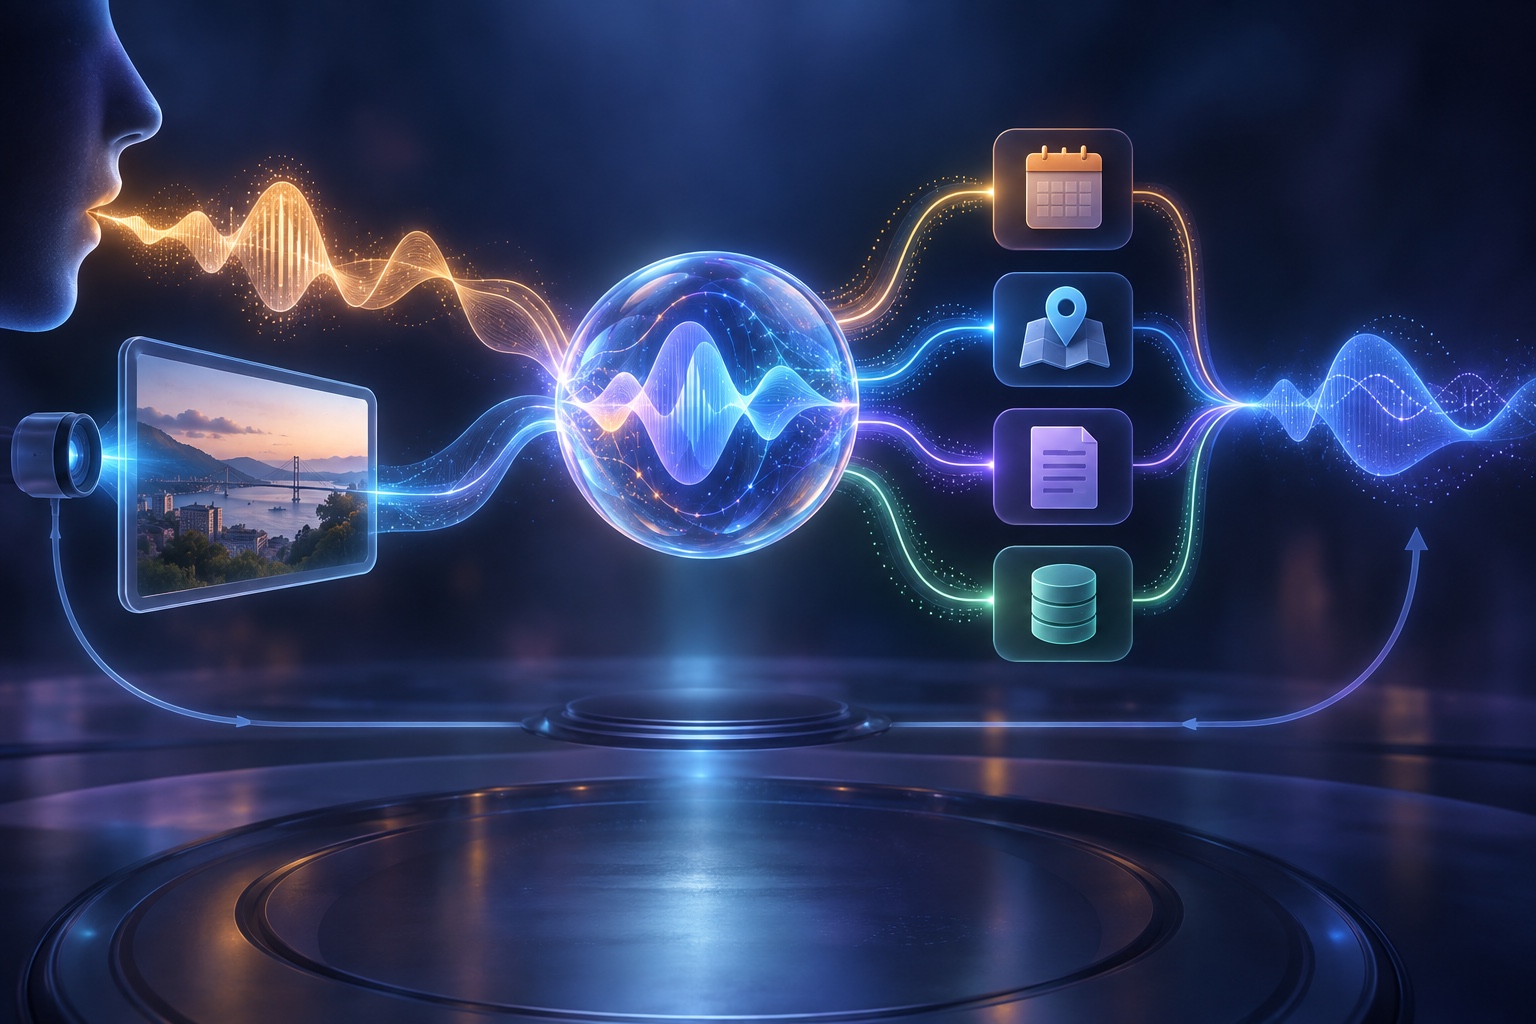
传统串行语音系统通常要经过语音转文字、语言模型推理、工具调用、文字转语音。任何一步等待,都会形成令人不确定的沉默。Gemini 3.8 Live把工具和API调用放到后台后,模型可以先确认请求、继续澄清条件,再等待日历、数据库或业务系统返回结果。这种并行性不会让外部系统本身变快,却能改善人与系统共同完成任务的节奏。
Google还称,新模型能够近实时处理摄像头或屏幕画面,并在对话中自动识别、切换97种支持语言。这里的“视觉理解”并不是模型获得了无误的现实感知:镜头盲区、模糊画面、屏幕遮挡和上下文歧义仍会影响判断。它更准确的意义,是语音代理可以把“你看这里”所指向的画面,与正在进行的操作放进同一轮上下文。
从草图到界面,官方演示证明了什么?
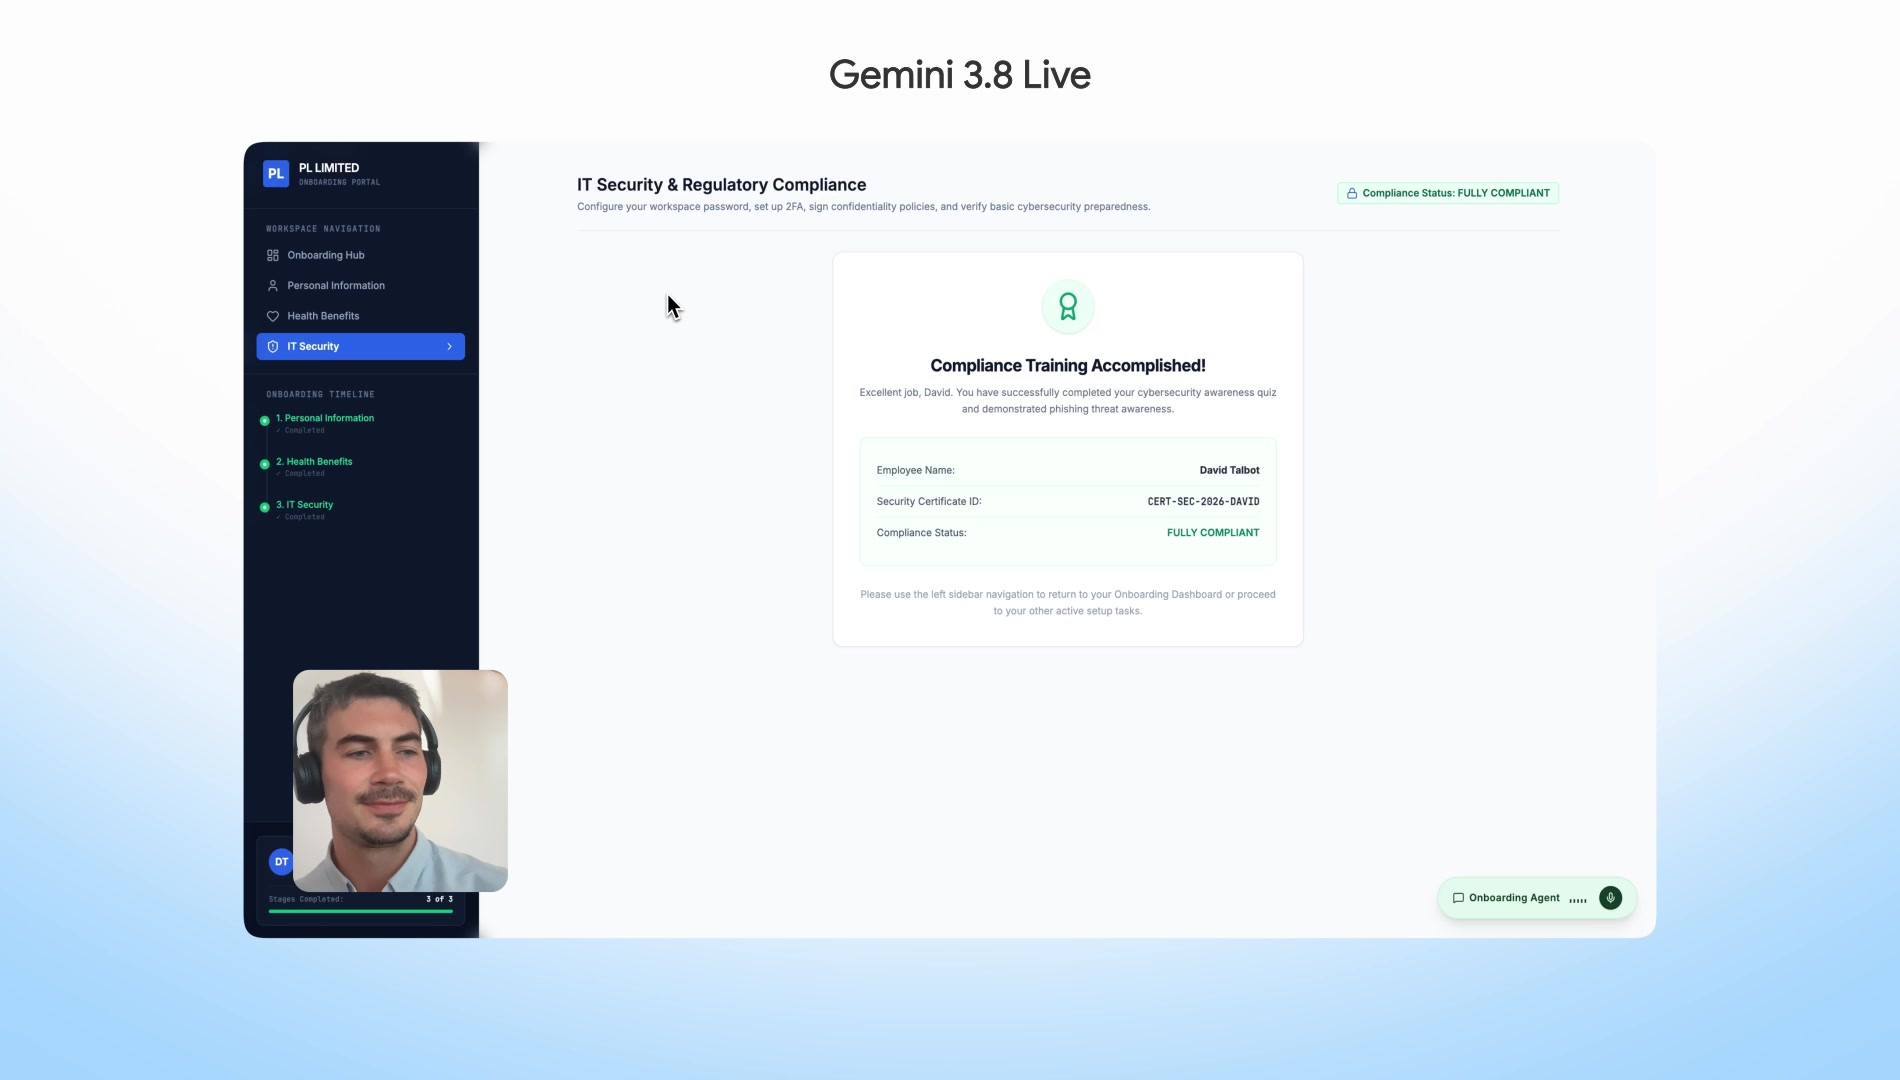
发布视频展示了多个场景:模型边看棋盘边对弈,带领新员工完成入职流程,根据纸上草图和连续语音反馈生成React界面,以及协调多步骤预订。它们说明模型具备组合视觉输入、语音指令与函数调用的产品形态,但不能直接当作真实客户环境中的成功率数据。
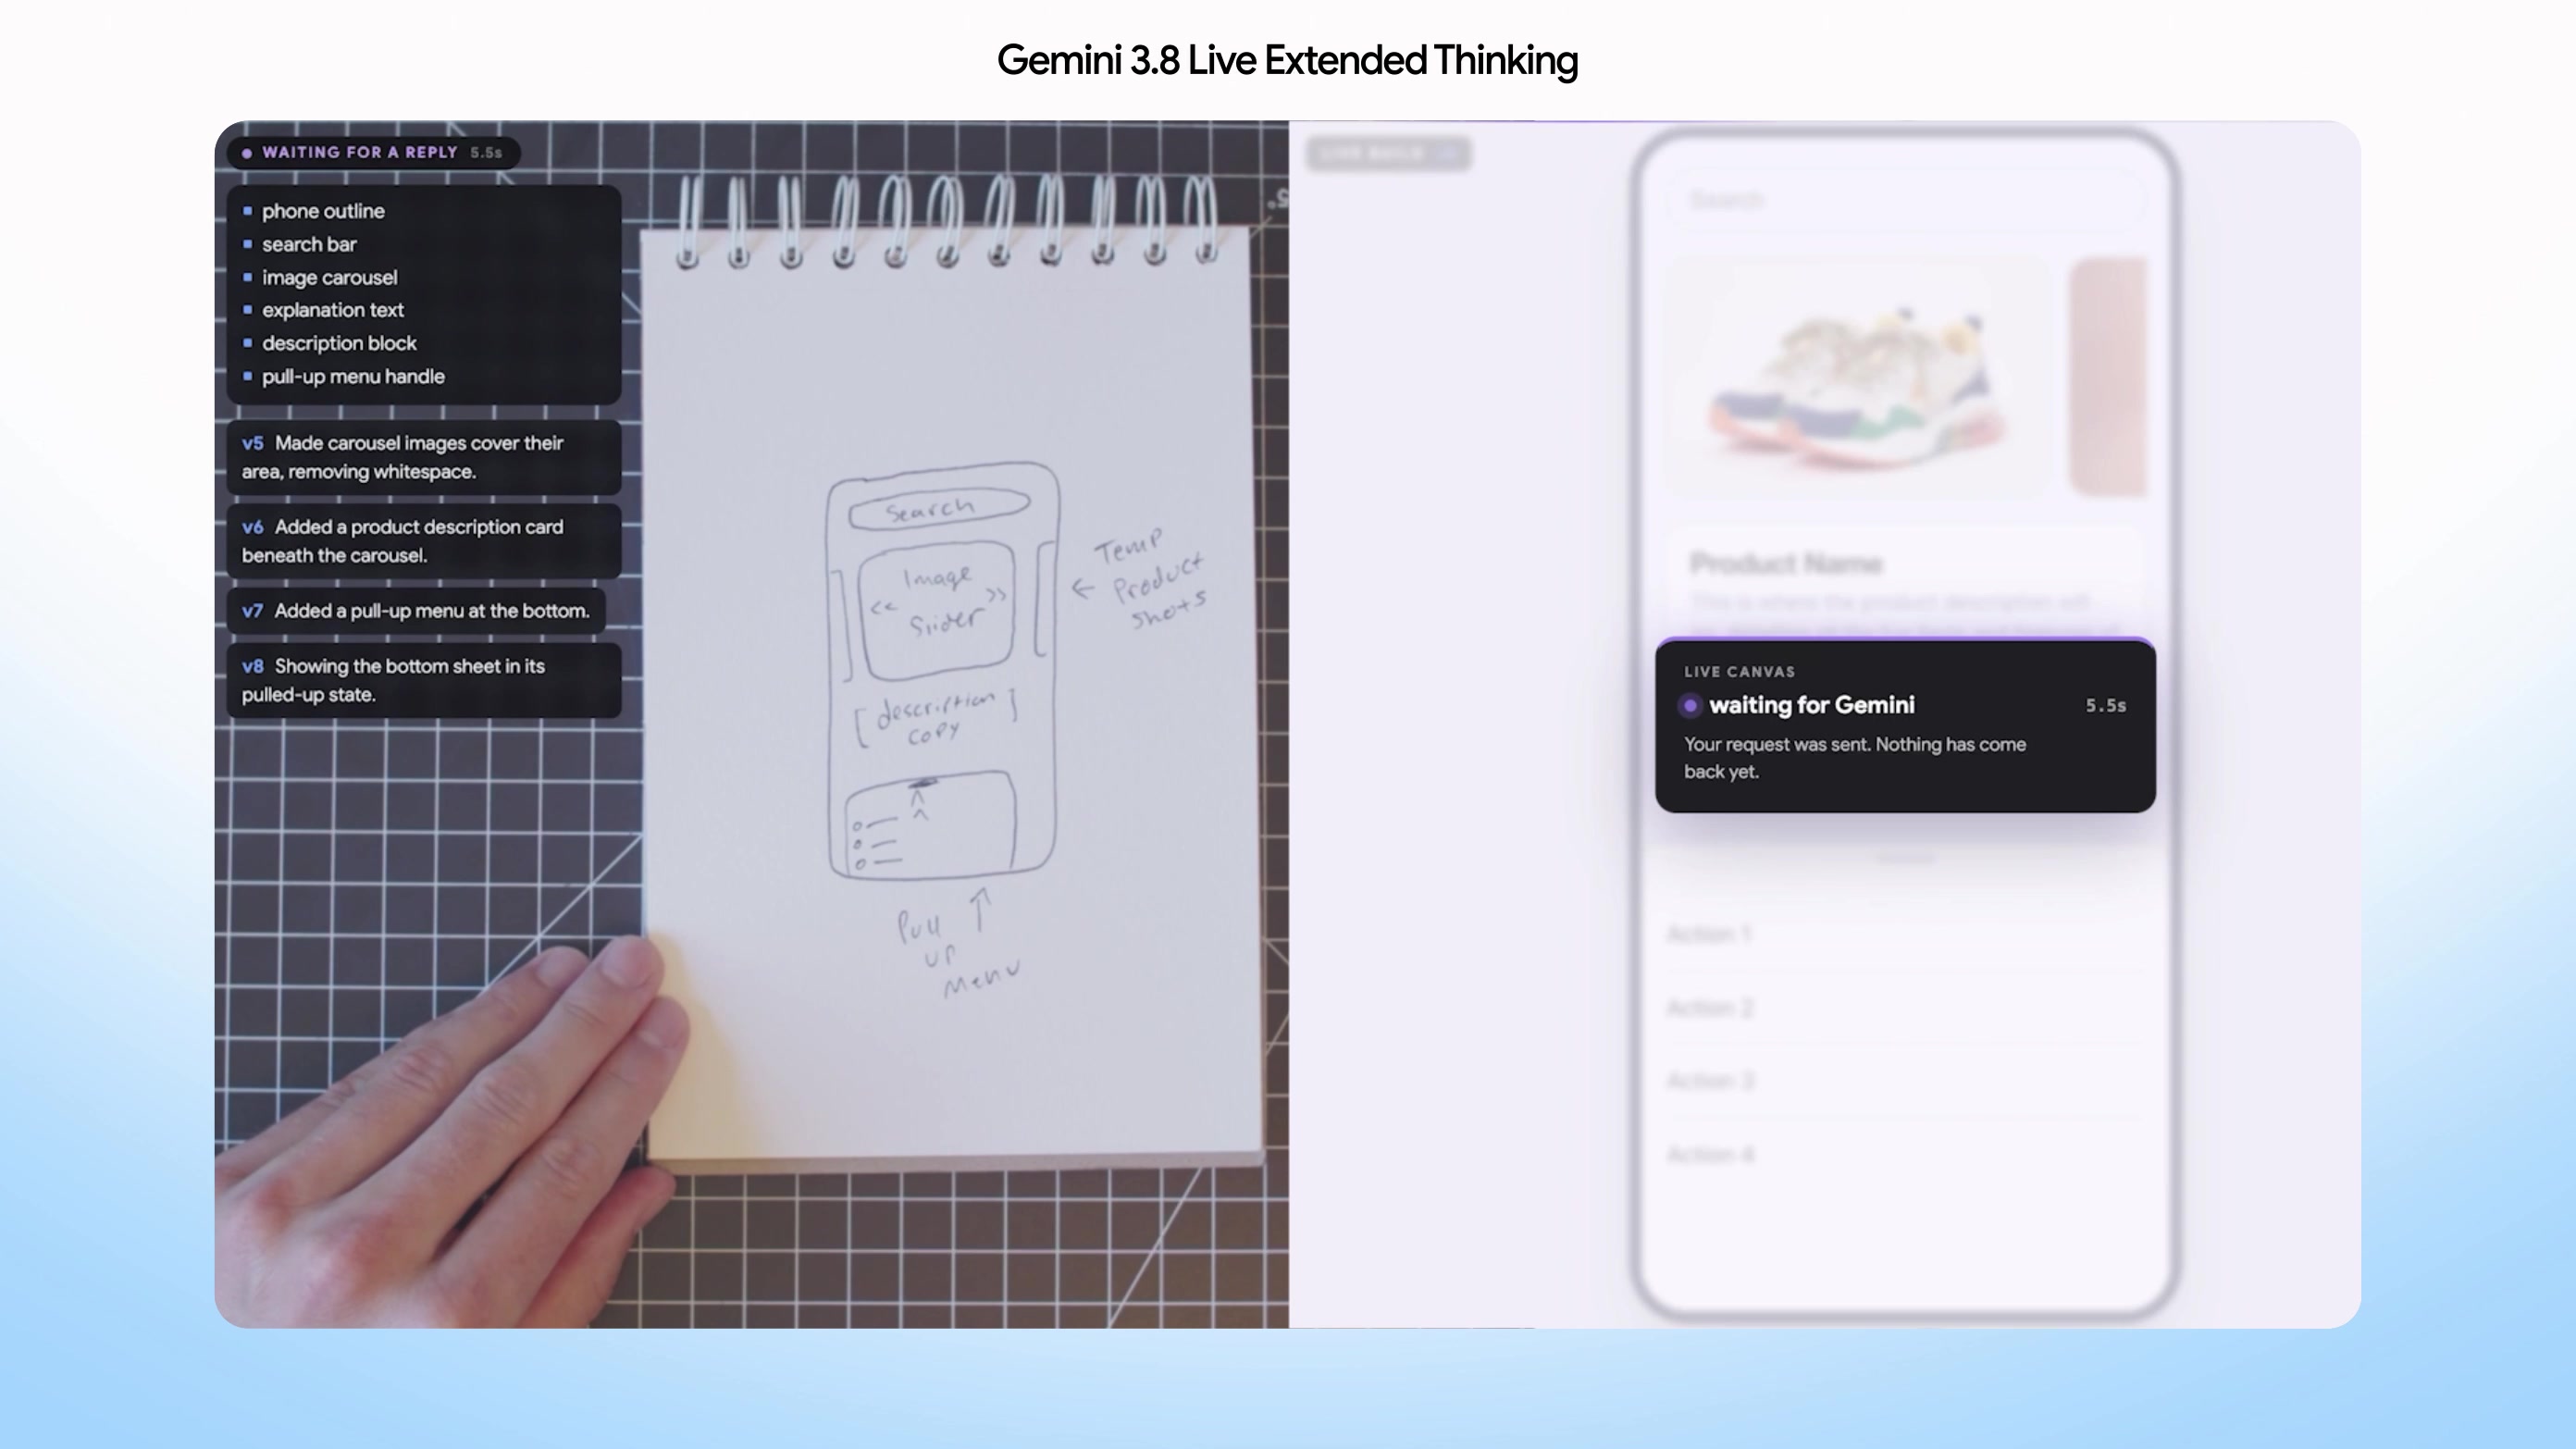
这种区分很重要。实验演示可以选择合适输入、缩短等待并控制外部工具,生产环境却要面对噪声、打断、口音、权限失败、接口超时和用户临时改口。如果语音代理能修改订单、发送邮件或操作企业系统,真正的产品门槛就从“能否听懂”升级为“能否在正确授权下做对事,并留下可复核记录”。
82.6分并不是通用智能的成绩单
Google披露,Extended Thinking在发布时的Artificial Analysis Speech-to-Speech Quality Index得到82.6分;在τ-Voice任务上为68.6%,在更窄的银行场景基准上为35.1%,Big Bench Audio为97.7%。这些数字覆盖语音推理、代理任务和对话体验,但不同基准的题目、工具和评分方式差异很大,不能合并理解成“现实任务正确率”。
Artificial Analysis公开的方法说明显示,其综合指数等权结合语音推理、代理表现、匿名偏好和任务成功率;τ-Voice则让模型在仿真的航空、零售和电信客服环境中调用工具,并检查数据库最终状态。它比只听音色更接近真实代理任务,但依旧是受控测试,不包含每家企业自己的权限结构、脏数据和异常流程。
模型卡里的限制,比发布会更接近使用边界
Google DeepMind模型卡显示,两款模型基于Gemini 3 Pro,可接收音频、图片、视频和文本,输入上下文上限为128K tokens,输出支持音频和文本、上限64K tokens。模型卡同时明确列出基础模型常见的幻觉问题,以及偶发变慢或超时;知识截止时间为2025年1月。
因此,“边推理边说话”也不应被误解为用户能看到完整、可验证的内部推理链。产品展示的是早期确认和进度播报,这有助于减少沉默,却不保证播报内容等同于系统实际执行路径。关键操作仍需要明确的二次确认、最小权限、幂等处理、失败回滚与日志审计。
SynthID解决来源标记,却不是万能鉴伪
Google表示,旗下AI产品生成的音频会嵌入不可感知的SynthID水印,帮助识别合成内容。这是必要的来源信号,但水印检测并不等于对整段录音真实性做法律级证明:转码、剪辑、混音和跨平台传播都会让实际检测环境更复杂。企业仍需结合账号身份、操作签名、会话日志和人工复核。
发布时,3.8 Live已开始进入Gemini API、Google AI Studio与Search Live,企业版处于私有预览;Extended Thinking也开始向API、Gemini Live及部分Workspace订阅用户推出。具体功能、地区和账号可用性仍可能不同,开发者不应只根据演示视频设计生产流程。
Gemini 3.8 Live代表的变化可以概括为一句话:语音AI正在从“回答问题的声音”变成“持续交流中的执行入口”。它跨过了交互架构的一道门槛,但距离可靠代理还有另一段更难的路——不仅要听懂人说什么,还要知道什么时候可以行动、什么时候必须停下确认,以及失败后如何把系统安全地带回原位。