NEWS & INSIGHTS
Google公布教育生成式UI实验:10轮自改进将通过率从3.5%升至69.3%
Google Research在2026年9月17日公布了一项面向教师的教育生成式UI实验:教师输入学科、年级和学习目标,系统用Gemini生成可操作的互动模拟,再经过自动评测、自我修正和教师确认。Google同时开放了一个包含30多个英文STEM互动项目的样例库,覆盖物理、化学、生物、数学等中学主题。
这项工作的价值不只在于“AI能做课件”,而在于技术报告公开了一个常被演示视频掩盖的事实:未经迭代的生成式UI很难直接用于课堂。研究团队称,单次生成后同时通过全部检查的比例只有3.5%;经过最多10轮“生成—评测—修正”,通过比例升至69.3%。这仍是Google团队自己的实验结果,而不是独立第三方复现,也不能直接证明学生学得更好。
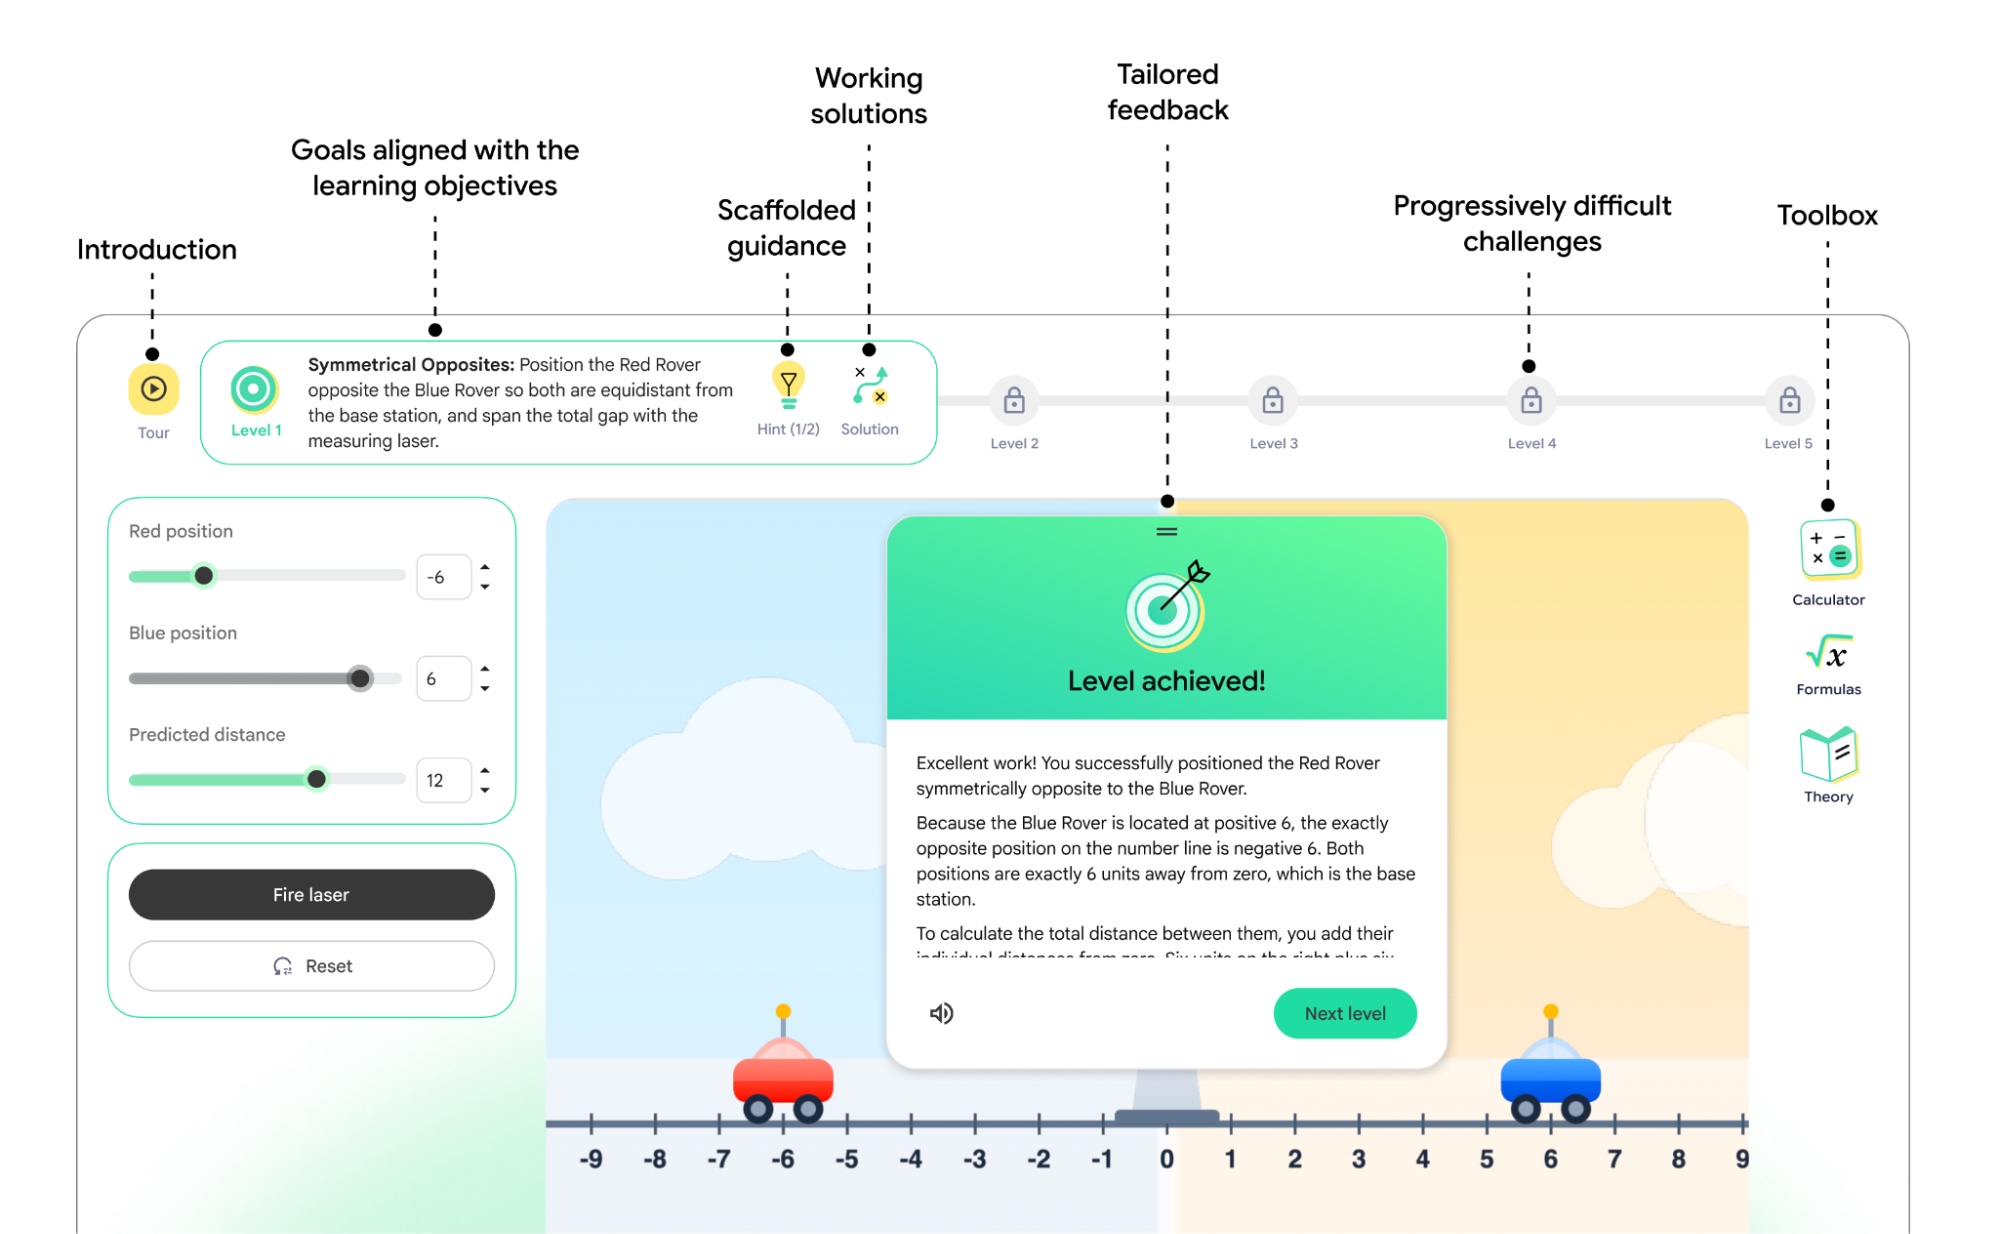
它生成的不是一张图,而是一段可操作的学习流程
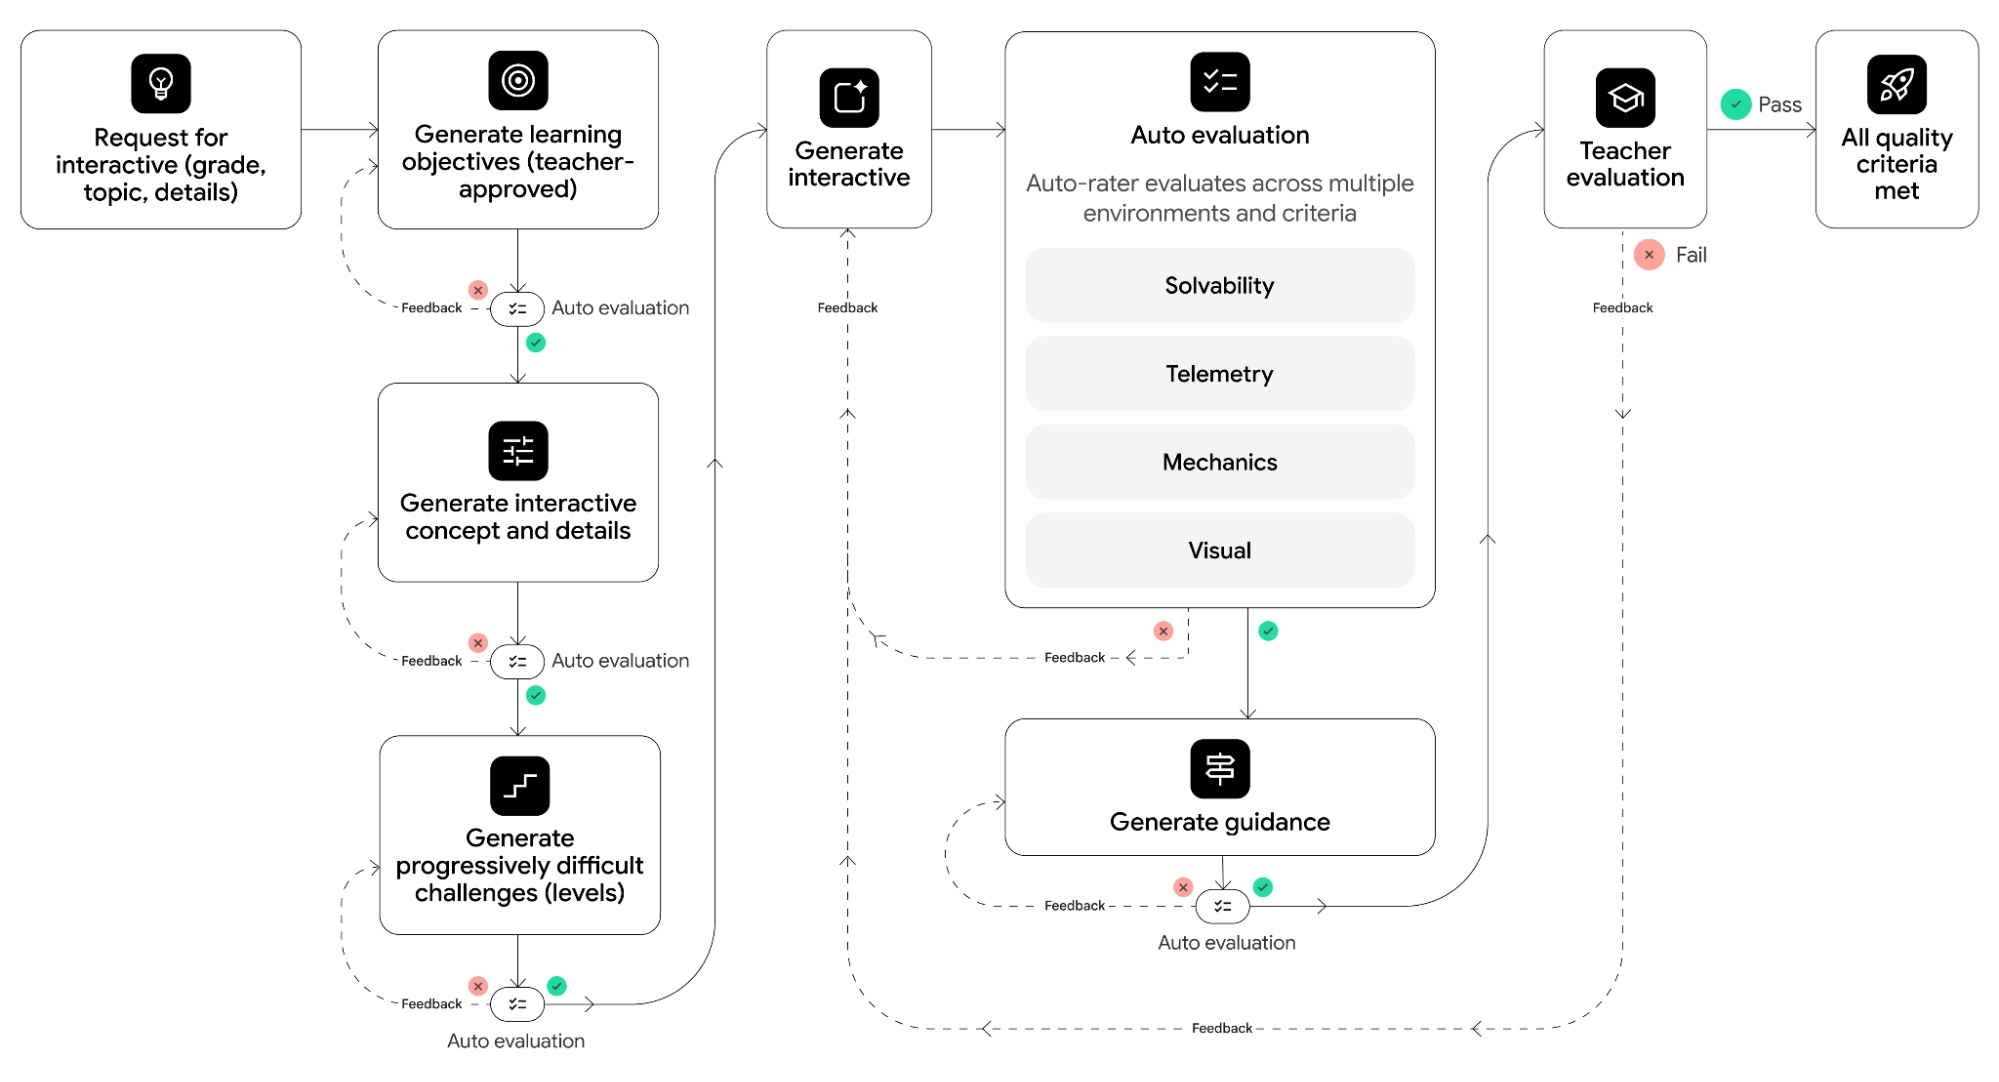
技术报告把系统称为“Learning Interactives”。它并非让模型一次性写出一个网页后立刻交给学生,而是把生成过程拆成四段:先从教师请求提炼学习目标,再规划模拟内容和逐级任务,接着生成可以运行的HTML/JavaScript界面,最后补充引导、提示、解题过程和针对答案的反馈。
| 阶段 | 系统产物 | 关键控制点 |
|---|---|---|
| 规划 | 学习目标与模拟设想 | 教师可审核、修改目标 |
| 支架 | 5个逐步变难的任务关卡 | 逐关检查具体性、清晰度与难度增长 |
| 生成式UI | 可运行的互动模拟 | 检查视觉、可解性、遥测与交互机制 |
| 引导 | 导览、提示、答案与反馈 | 帮助学生思考,而不是直接泄露答案 |
生成目标也不是“越自由越好”。报告强调,学生直接与无约束的生成式AI互动可能造成认知外包,因此系统需要保留适度的思考阻力:学习目标由教师批准,复杂概念被拆成逐级挑战,提示按层次开放,完成后再展示推导和解释。这里的AI主要负责降低制作互动模拟的技术门槛,而不是替代教师决定教什么、何时使用以及结果是否可以进入课堂。
为什么单轮通过率只有3.5%?
研究团队发现,即便模拟设想和学习目标已经验证,单次提示生成的界面仍可能出现四类问题:元素遮挡或越界等视觉错误;任务没有正确答案或无法完成;记录学习过程的遥测数据错误;按钮、滑块和关卡状态等机制失效。一个看起来像成品的页面,可能在学生真正操作时立即暴露问题。
因此系统会同时分析生成的代码和浏览器中的实际运行结果。报告举例称,可解性评测会打开Chrome并像学生一样操作模拟,还会把旋钮拖到极端值,寻找普通演示未必覆盖的失败路径。未通过的版本会带着批评意见重新生成;10轮后,通过所有检查的比例从3.5%提高到69.3%。各项指标并非轮轮单调上升,因为修复一个组件也可能破坏另一个组件。
教师评价说明了什么,又没有说明什么?
第一项可用性研究招募了12名美国STEM教师,男女各6名,覆盖数学、生物、物理、环境科学、天文学和化学。每位教师提出3个模拟请求,共36个。系统为每个请求生成5个候选,由内部评审选择最好的一版;其中3个请求的候选质量仍不足以交给教师。其余互动项目的可用性评分均不低于7分,平均超过8.1分。
第二项评测由教学专家选出40个跨学科请求,每个请求仍尝试生成5个版本;通过自动检查的版本再交给对应STEM领域的两名教师评分。报告给出的总体接受率是86%,多数评分落在“良好”或“优秀”。物理和化学更接近“优秀”,而生物项目在美观和用户体验上相对较弱。研究者的解释是,不少生物主题更依赖对细节的记忆,较难转化成可操控方程或变量的模拟。
这些结果支持“教师认为工具有用”的初步结论,但证据仍有三重限制:样本小;教师看到的是经过自动筛选和内部择优的版本;评测主要关注可用性和教学设计,没有报告学生前后测、长期保持率或与传统教学的随机对照。技术报告明确把真实学校中的学习效果和学生参与度列为下一步研究。因此,现阶段不能写成“AI互动课已经被证明能提高成绩”。
教师审核为何是产品机制,而不是一句免责声明?
Google的流程把教师放在三个明确位置:批准学习目标、从候选模拟中选择最合适的版本、验证后决定是否进入公共样例库。公开库中的项目据称都经过教师审核;参加后续试点的学校也只能在教师确认之后,把新生成的内容加入库中。
这与把“请人工复核”写在页面底部不同。人工判断被嵌入了发布权限,但并没有消除责任:教师仍需要核对事实、课程标准、年龄适配、无障碍需求和错误反馈;学校还要评估学生数据、账号权限、生成成本以及失败时的替代方案。自动评测可以筛掉已知机械错误,却不能证明系统不会出现未覆盖的学科性错误。
对教育AI和生成式应用的三个现实启示
1. 可运行不等于可用
生成式UI把模型输出从文字推进到可执行软件,错误也从“回答不准确”扩展到按钮失效、状态不同步、任务无解和反馈误导。上线指标应包含端到端可解性与极端输入测试,而不能只看代码是否编译、页面是否打开。
2. 质量来自整条评测流水线
3.5%到69.3%的差距说明,模型能力只是系统的一部分;任务分解、自动批评、浏览器交互测试、候选择优和人工审批共同决定最终质量。类似地,我们此前分析Anthropic用指标衡量AI参与研发时也看到,“AI主导”必须连同监督和发布权限一起理解,不能只统计生成了多少内容。
3. 先找适配任务,再谈全面替代
物理、化学中可操控参数和可观察结果较多,天然适合互动模拟;需要记忆大量细节、涉及开放价值判断或无法快速验证答案的课程,生成式UI的优势可能更弱。合理路线是从容易验证、可回退的局部场景开始,而不是把一套界面生成流程直接包装成通用教师。
Google这次公开的不是一个已经完成大规模课堂验证的教育产品,而是一套仍在试点的研究框架。它最值得关注的信号,是团队把模型的低单轮成功率、自动修正收益、教师选择权和尚未验证的学习效果同时摆在了桌面上。对任何准备把生成式AI接入真实业务的人来说,这种边界比“又能生成一种内容”更有参考价值。
资料来源
- Google Research:The future of practice: Enabling teachers to create learning interactives with generative UI,2026年9月17日。
- Google Research技术报告:Harnessing Generative UI for Education: Tailored Learning Interactives,2026年9月16日。
- Google Research:Learning Interactives公共样例库,资料核验时可访问。
- Google for Education Pilot Program,资料核验时可访问。
资料核验时间:2026年9月20日09:10(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。