NEWS & INSIGHTS
Google详解MilleMiglia:不公开企业数据,怎样生成可复现的物流算例?
Google Research在2026年9月18日发布文章,系统介绍开源项目MilleMiglia:它不直接替物流企业排出一张“最优运输表”,而是先生成可重复、可调难度的中程物流测试算例,让不同优化算法和机器学习方法能在相同条件下比较。
这个区别很重要。真实物流公司的仓网拓扑、货量、班次和中转能力往往属于敏感经营数据;如果研究者只能使用过度简化的随机图,算法在论文算例上有效,也未必能应对真实网络的时刻表、转运衔接和处理能力限制。MilleMiglia试图填补的是“缺少可信测试场”的空白,而不是宣告中程物流已经被AI解决。
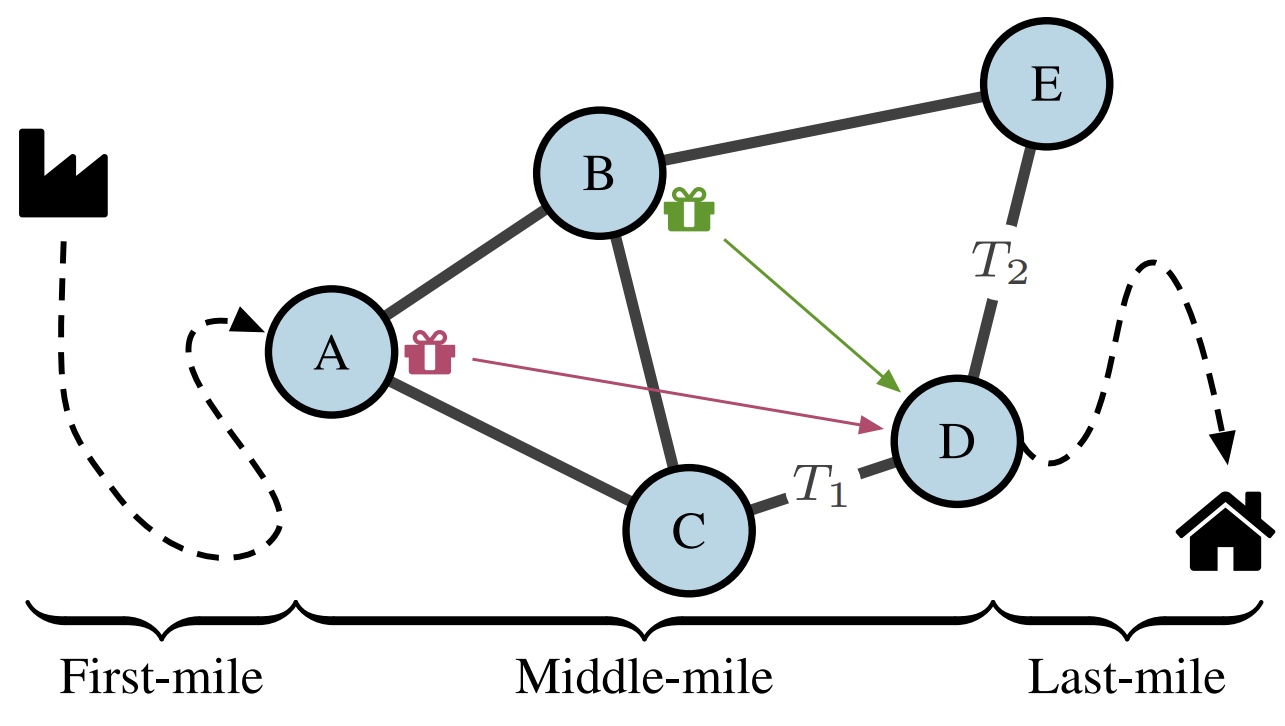
中程物流为什么不是“把末端路线放大”?
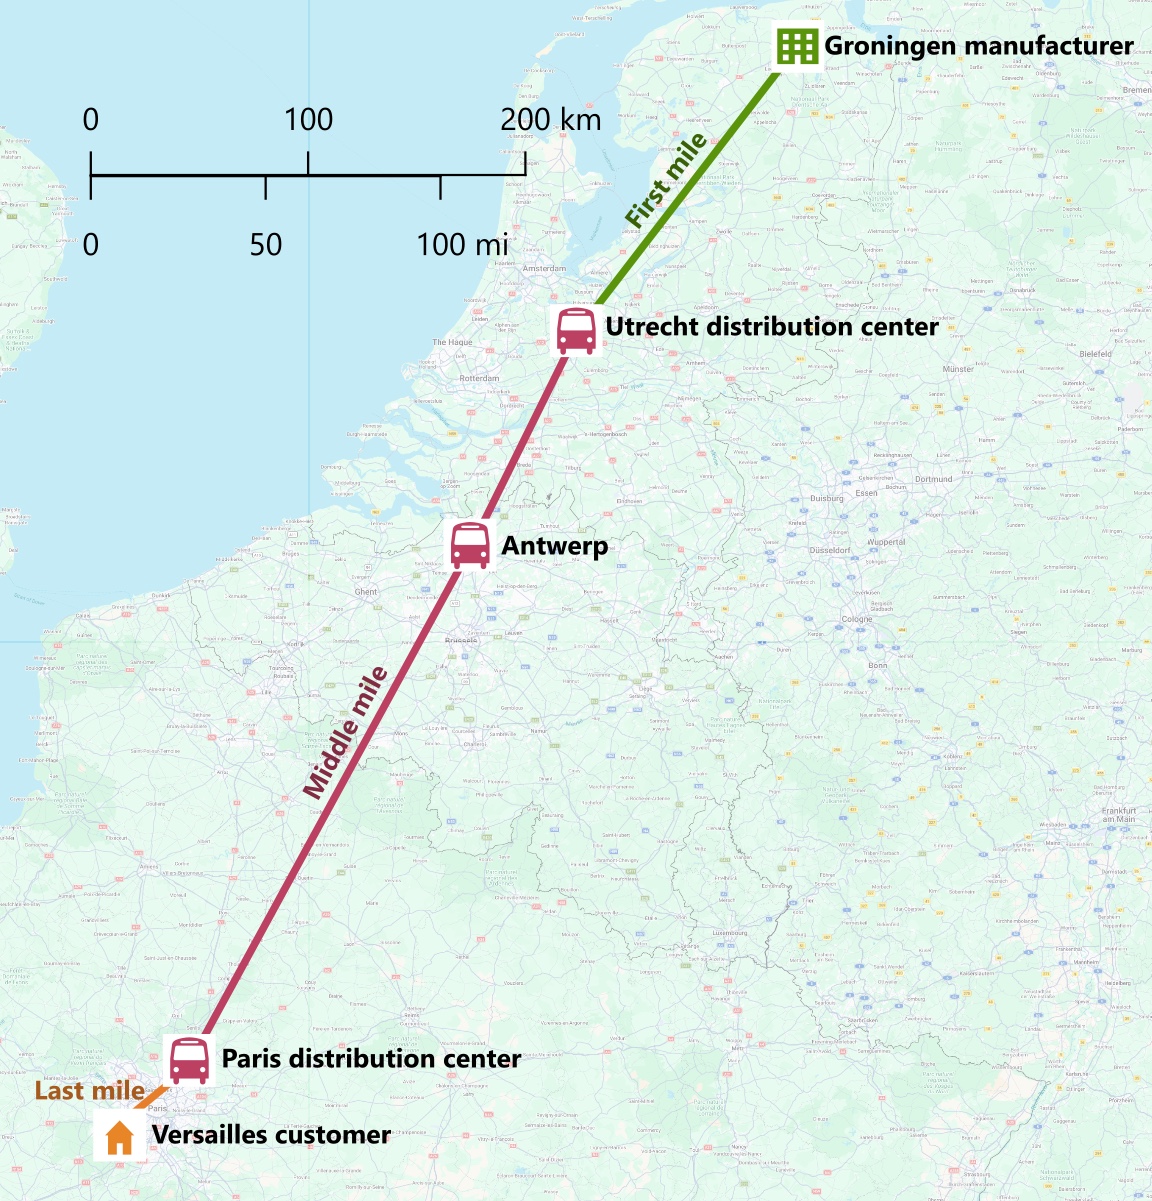
末端配送通常关心一辆车依次访问哪些客户,核心是车辆分配和站点排序。中程物流更像接力赛:同一票货物可能在多个配送中心卸载、分拣、合并,再换到另一辆车,整个过程跨越多天。到达晚一步,货物就可能错过下一班固定班次,只能等待新的连接。
| 对比项 | 典型首程/末程 | 中程物流 |
|---|---|---|
| 货物与车辆 | 一段运输通常留在同一辆车 | 一票货可在多辆车之间转运 |
| 时间范围 | 常以单日路线为主 | 可能跨多日和多个班次 |
| 核心问题 | 车辆分配与访问顺序 | 路径、班次、转运与等待的同步 |
| 设施约束 | 常简化为站点和车辆容量 | 还要考虑中心每小时分拣或越库能力 |
Google团队把问题表示为时空图上的多商品流:一个节点不是单纯的“某个配送中心”,而是“某个配送中心在某个时间段”;一条边可以代表车辆在两个中心之间移动,也可以代表货物留在中心等待。固定班次、中心吞吐上限和前后车辆的衔接关系因此都能进入同一个模型。
MilleMiglia究竟生成什么?
2024年在第33届欧洲运筹学会议展示的工作说明,一个算例包含物流网络、枢纽、车辆、路线、线路、班次以及待运输货物。使用者可以调整枢纽数量、空间图密度、货物重量分布和最大车辆数等参数,生成从小型教学问题到大陆级工业规模问题之间的不同难度。
Google最新介绍进一步列出三类分布:用引力模型或空间聚类放置配送中心,使其接近人口和产业密度;按照起点—终点组合、体积和重量分布生成需求;按照“大型中心互联”或“大型中心连接周边小中心”的结构生成车辆班次,而不是在节点间随意连线。
项目用C++实现,并用Protocol Buffers保存数据。统一格式的意义是,同一个算例可以被不同语言编写的求解器读取,研究者也能保存随机种子和参数,复现实验,而不是每篇论文各自构造一套不可比的测试题。
“合成数据”为什么能保护商业信息,又不能自动等于匿名?
Google把MilleMiglia生成的数据描述为保护隐私的合成算例。其思路不是公开某家公司的真实中心位置、货量和班次,而是从公开行业信息与企业私下提供的数据中归纳统计分布,再生成一张新的网络。研究者得到的是具备相似结构和约束的测试问题,而不是原始运营表。
但官方博客和2024年论文摘要没有宣称采用差分隐私,也没有给出针对成员推断、稀有线路复现或极端货量泄露的定量测试。因此,“没有逐条复制真实记录”与“具有形式化隐私保证”应分开理解。真正用于企业合作时,仍需检查分布尾部、稀有组合和参数配置是否可能暴露独特经营模式。
另一个边界是代表性。合成网络如果只匹配平均枢纽度数和平均货量,却没有保留节假日峰值、天气扰动、临时停运或区域性不平衡,求解器可能在基准上表现很好,进入实际运营后仍然失效。合成数据的质量要靠下游任务验证,而不是只靠“看起来像真数据”。
它与AI有什么关系?
MilleMiglia本身主要是统计分布和图结构驱动的C++算例生成器,不是大语言模型,也不是一个已经部署的AI调度系统。它与AI的直接连接在于:生成器可以大规模产生统一格式的数据,用于训练和评估预测模型、图神经网络、强化学习策略或其他智能优化方法。
这也解释了为什么基准基础设施值得单独报道。没有稳定、覆盖真实约束的测试集,研究者很难判断一个新模型是在解决中程物流,还是只记住了某种玩具图的规律。我们此前分析Google教育生成式UI的自动评测流程时也看到,可运行的演示不等于可用系统;物流优化同样需要把数据生成、求解、压力测试和真实运营验证拆开。
采用这类基准前,至少应检查五件事
1. 约束是否与业务一致
企业应逐项核对固定班次、中心吞吐、装卸时间、车辆容量和转运规则。缺少关键约束的“大规模数据”仍可能只是更大的玩具问题。
2. 合成分布是否覆盖极端情况
平均场景之外,还要测试需求暴涨、中心故障、交通中断、班次延误和多处同时受限的情况。算法鲁棒性往往在分布尾部暴露。
3. 隐私声明采用什么标准
需要区分数据未直接公开、经验性难以还原与形式化隐私保证。若参数来自少数企业,生成前后的泄露评估仍不可省略。
4. 比较指标是否完整
只看运输成本可能掩盖延迟、错过衔接、中心过载和求解时间。基准应同时报告可行率、成本、时效、计算资源和随机种子。
5. 是否在真实网络上做最终验证
合成基准适合筛选算法和复现实验,不能替代受控的真实数据回放与上线前试点。Google也明确表示,专门的中程物流求解器和API仍在开发中,目前公开的是生成器和数据格式这一基础层。
MilleMiglia的现实意义,是让一个长期受商业数据限制的问题拥有更统一的实验入口。它能否成为像CVRPLIB那样被广泛采用的公共基准,还取决于外部团队能否复现结果、贡献多样化算例、建立共同指标,并证明合成网络与真实运营之间存在稳定联系。
资料来源
- Google Research:MilleMiglia: A realistic instance generator for middle-mile logistics,2026年9月18日。
- Google Research Publications:A Novel Instance Generator for Simulating Middle-Mile Logistics Networks,2024年。
- or-tools/millemiglia开源代码仓库,Apache-2.0许可证,资料核验时可访问。
- EURO 2024会议日程与论文摘要,2024年。
资料核验时间:2026年9月21日09:08(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。