NEWS & INSIGHTS
OpenAI称模型解决百余道数学难题:独立顾问组能验证什么?
OpenAI在2026年9月21日宣布,一个由九位数学家组成的“数学与人工智能顾问组”已经成立。OpenAI同时声称,其8月28日开始训练的内部模型除给出纳维—斯托克斯问题的一个解答外,已“解决100多道”分布在多个数学领域的长期开放问题。
最需要读者区分的是:顾问组成立是可以核验的事实;“100多道难题已解决”目前仍是OpenAI的报告,独立顾问组官网也采用“OpenAI报告称”这一表述。公开页面没有列出全部问题、完整证明与逐项外部审查结论,因此不能把这个数字直接等同于数学界已经确认的一百多项新定理。
这个顾问组为什么现在出现?
时间线很关键。9月8日,OpenAI发布了一份由内部系统生成、并用Lean形式化的纳维—斯托克斯问题解答,称该证明给出了三维流体方程在有限时间形成奇点的构造。9月11日,27位菲尔兹奖得主联合发布《A Severe Misalignment of AI in Mathematics》,承认AI可能加速数学研究,同时警告把“攻克著名难题”当作模型竞赛指标,可能挤压解释、归因、教学和同行消化新方法所需的时间。
9月21日的公告正面回应了这种担忧。OpenAI称,内部模型推进速度已超过公司数学研究人员的预期,因此需要讨论如何让数学界获知进展并有时间适应。独立顾问组则写得更具体:当前任务是就“如何协调发布OpenAI报告由内部模型产生的大量重要数学结果”提出建议。
这意味着争议已经从“AI能不能做数学”推进到“当机器产出速度超过人类评审速度时,谁来决定何时公布、怎样归因、什么才算理解”。
顾问组能做什么,不能做什么?
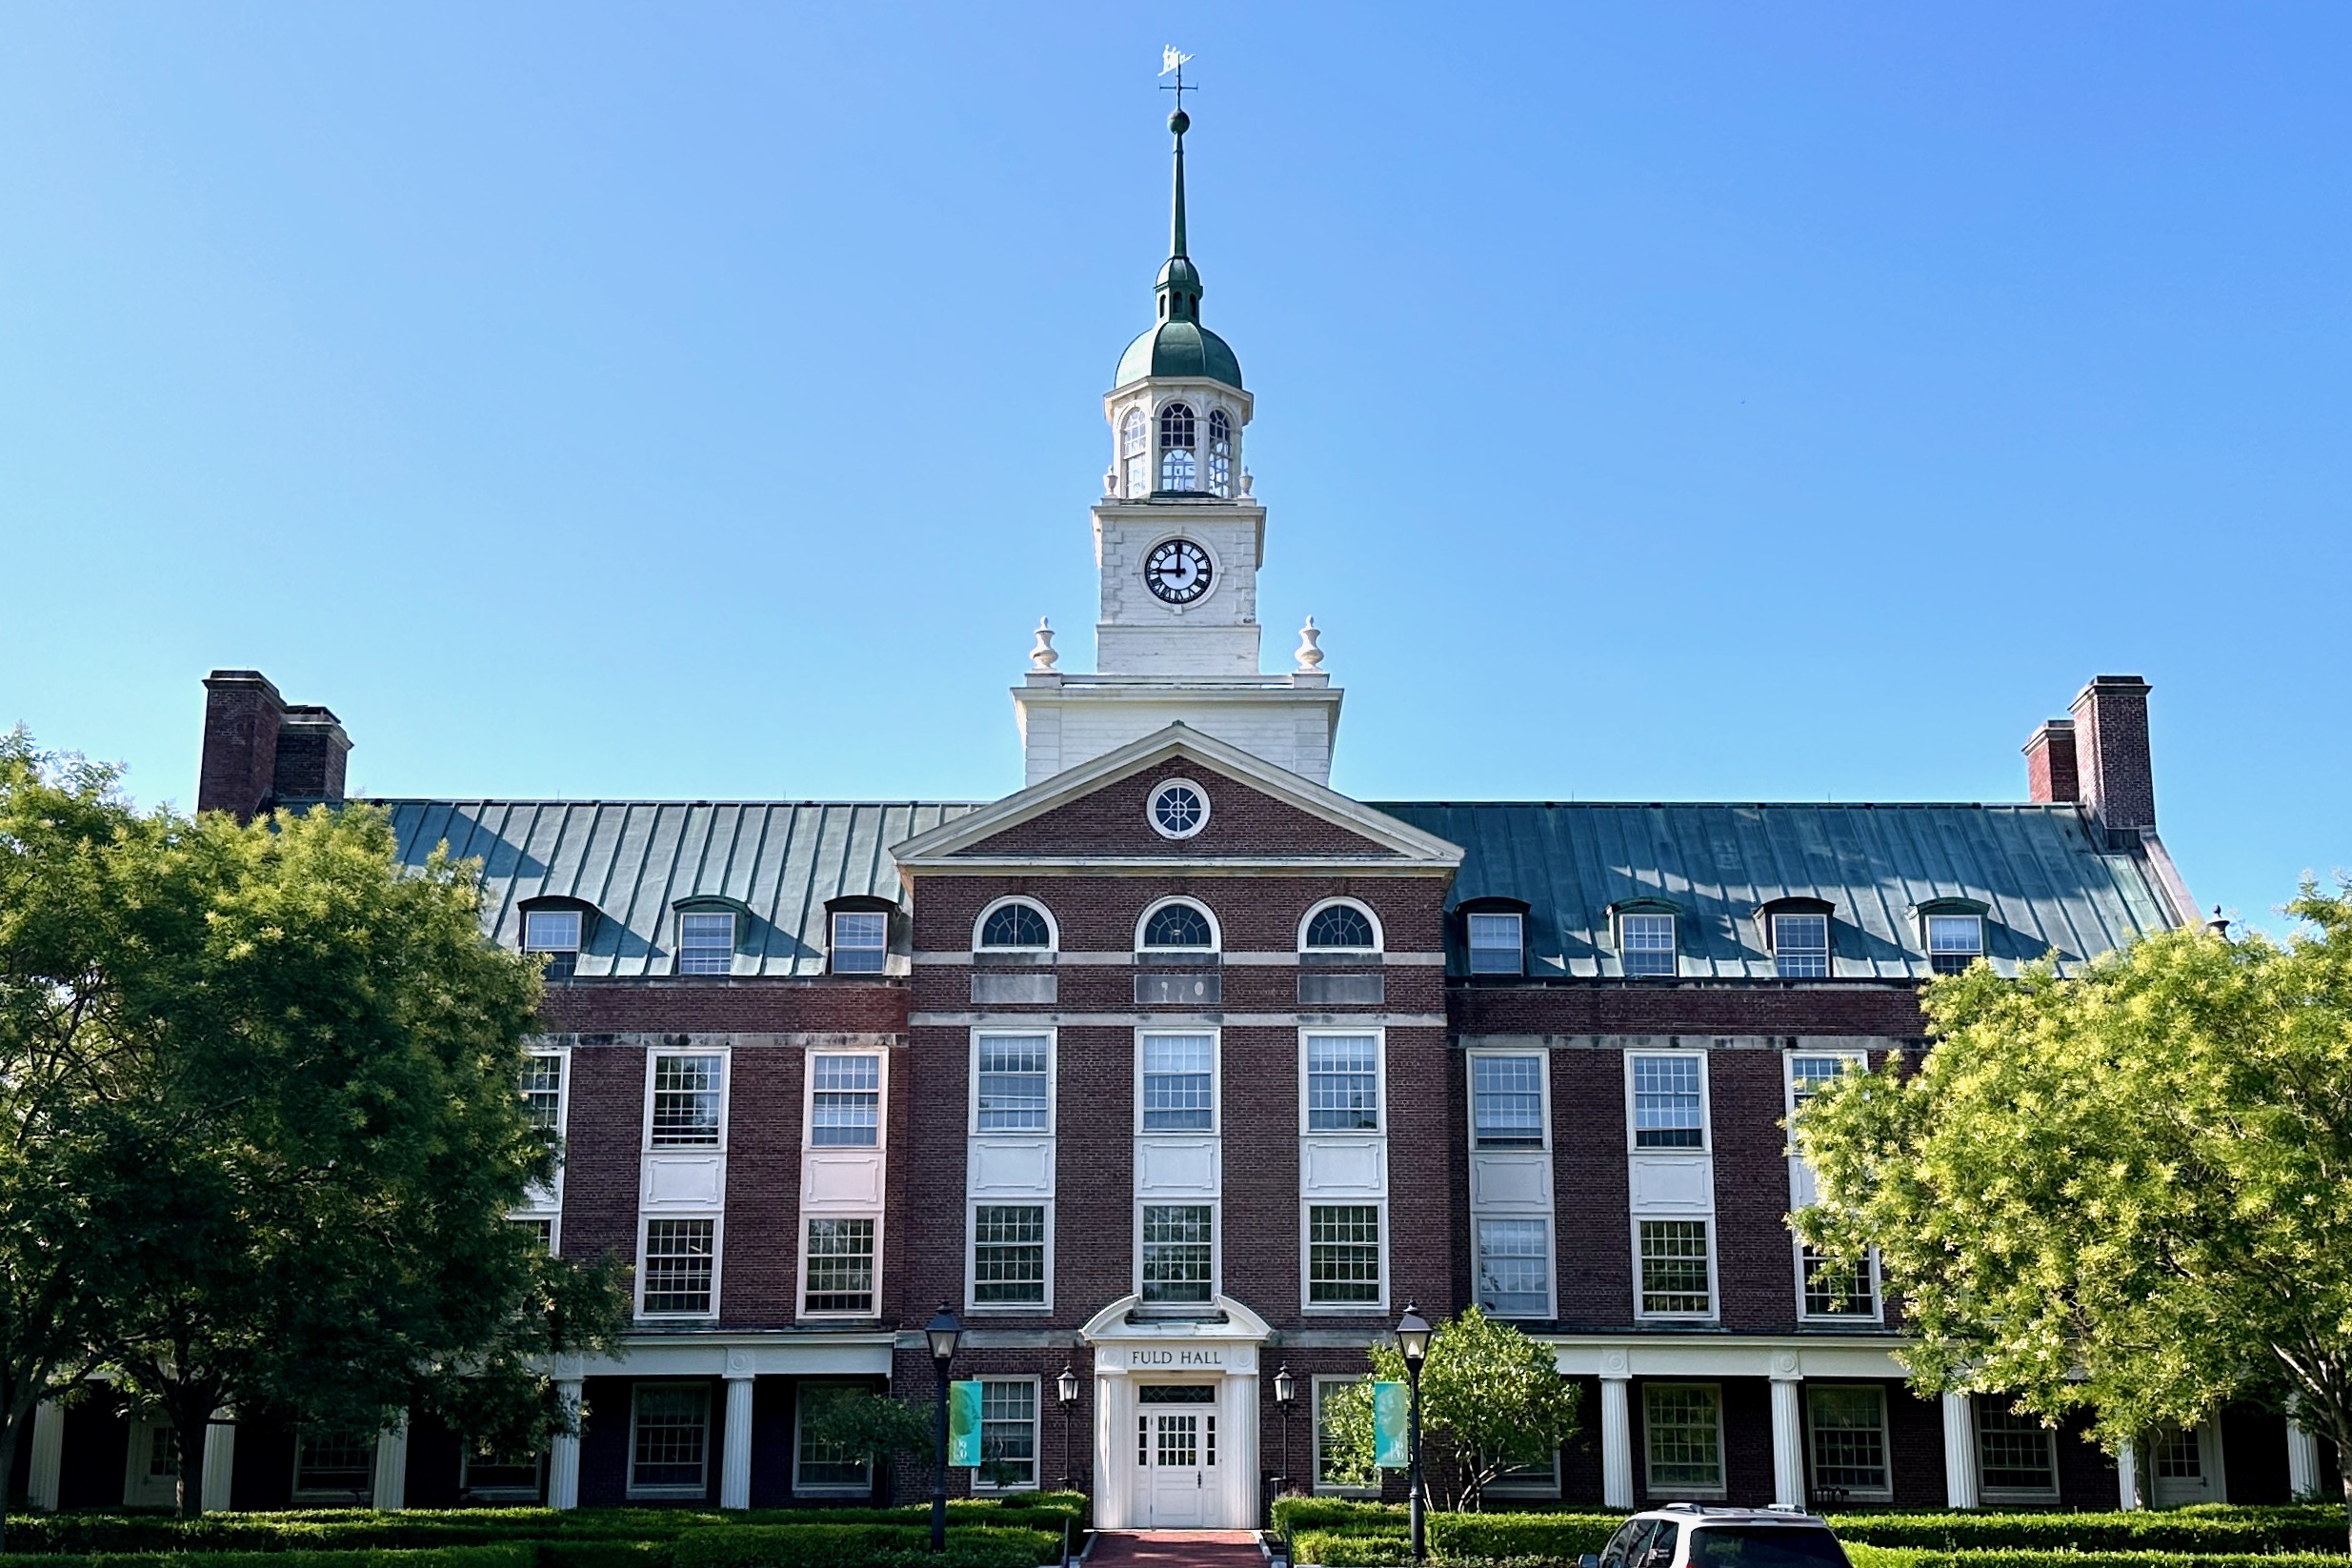
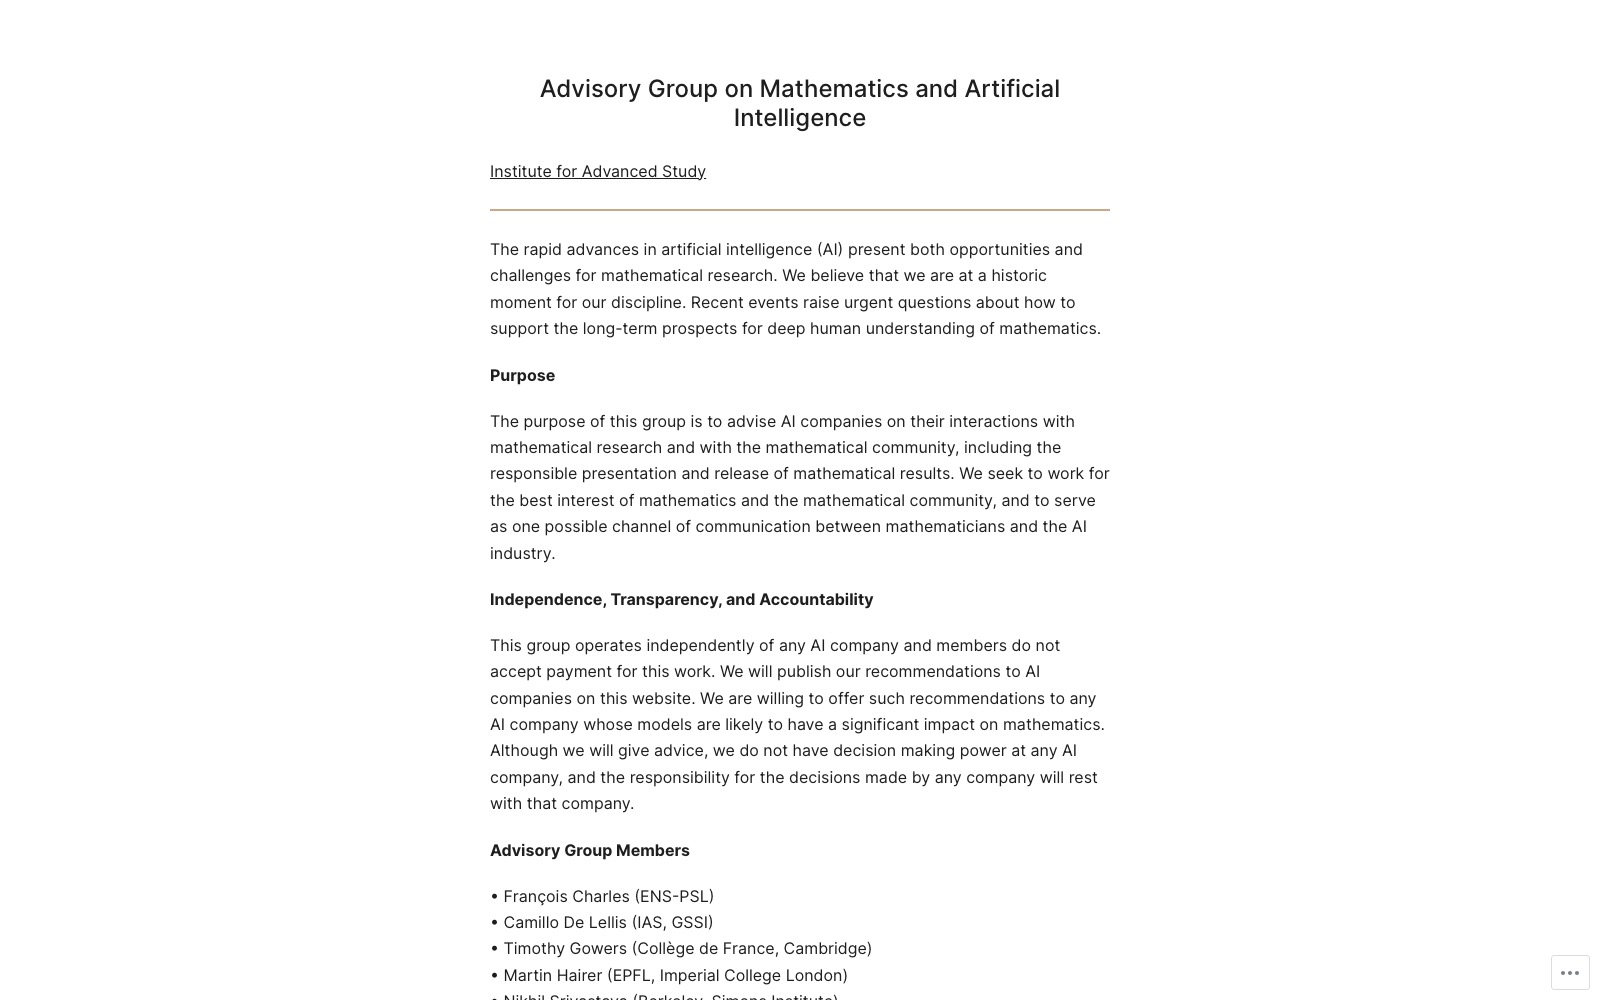
顾问组初始成员来自高等研究院、剑桥、牛津、斯坦福、哈佛、伯克利等机构,包括François Charles、Camillo De Lellis、Timothy Gowers、Martin Hairer、Nikhil Srivastava、Ulrike Tillmann、Ravi Vakil、Edward Witten和Melanie Matchett Wood。
| 事项 | 公开说明中的职责 | 不应误读为 |
|---|---|---|
| 结果审查 | 评估新结果的重要性,建议审查与发布方式 | 已替所有“百余项结果”背书 |
| 传播协调 | 为论文、证明、解释和社区沟通的节奏提供建议 | 拥有阻止OpenAI发布的决定权 |
| 学术标准 | 就归因、研究规范和专业标准提出意见 | 替代期刊同行评审或学术共同体 |
| 工具与学习 | 建议AI工具如何支持数学研究和教学 | 决定OpenAI内部模型训练速度 |
独立性设计有四个可核对的边界:成员不接受OpenAI付费;可主动提出公司未要求的意见;可公开建议;成员构成由小组自行调整。与此同时,小组明确没有任何AI公司的决策权,最终决定仍由公司承担责任;OpenAI也明确排除了一项职责——顾问组不负责建议公司放慢或加快内部数学进展。
形式化证明为什么仍然需要人类评审?
Lean等证明助手能把每一步推理转换成机器可检查的形式,并由较小、可审计的内核验证结论是否从给定定义、公理和前提推出。这比只让大模型生成一篇自然语言证明多了一层强约束,也有助于发现跳步和隐含假设。
但“内核接受”并不能一次回答所有学术问题。评审者仍需确认形式化定理是否与原始开放问题完全一致,定义和边界条件有没有被悄悄改变,所依赖的库与公理是否合适,证明是否真正带来可理解、可推广的方法,以及对已有工作的归因是否充分。
因此,技术验算、数学意义和学术治理是三个不同层次:
- 技术层:形式化代码是否通过证明内核,依赖是否完整、可复现。
- 数学层:命题是否对应原问题,方法是否正确、重要并能被专家理解。
- 共同体层:如何排序大量结果,怎样给出归因,谁承担审查劳动,何时公开才不会造成信息洪水。
OpenAI已经公开纳维—斯托克斯论文与Lean证明链接,但9月21日所称的“100多道”结果尚未按同样粒度公开。顾问组眼下最现实的工作,不是替一个总数盖章,而是建立一套能逐项落地的发布门槛。
接下来应观察哪些可核验信号?
1. 是否公布完整结果清单
至少需要问题的准确表述、首次完成时间、作者与模型贡献、自然语言证明、形式化代码、依赖版本以及外部评审状态。只公布数量,外界无法判断这些问题的难度分布、是否存在重复,也无法复核“解决”的标准。
2. 顾问建议是否真正公开
顾问组承诺在官网发布给AI公司的建议。这些公开文件将比成员名单更能说明独立性是否有效:建议里是否包含可操作的发布顺序、归因规范、撤回与更正机制,以及公司是否采纳或解释未采纳原因。
3. 人类评审资源如何分配
如果AI持续产生大量候选结果,稀缺资源会从“找证明”转移到“理解、核验和传播证明”。需要看到公司是否提供可复现材料、审查时间和基础设施,而不是把确认责任无偿转移给少数专家。
4. 形式化结论与数学解释能否同步
数学界公开声明强调,解题只是获得理解的一种代理指标。真正有长期价值的发布,应说明新方法与既有理论的关系、能解决哪些相邻问题、又在哪里失效。机器可验与人类可学并不是二选一,两者缺一都难形成稳固的新知识。
我们此前分析OpenAI自动化研究工具以及Anthropic对AI研发提速指标的披露时,都遇到同一条边界:企业数据可以证明内部流程发生变化,却不能自动替代第三方复现。数学顾问组的价值,最终也要由公开材料、可重复审查和对异议的处理方式来衡量。
结论
这次事件最重要的信号,不是“AI已经一次性终结一百多道数学难题”,而是AI公司和数学界开始搭建结果洪流到公共知识之间的治理层。顾问组拥有公开发声与独立判断空间,却没有公司决策权,也不介入内部研发节奏;它能否发挥作用,取决于OpenAI是否提供足够材料、接受公开建议,并让验证速度而不是宣传速度决定结论何时成立。
资料来源
- OpenAI:Advisory Group on Mathematics and Artificial Intelligence,2026年9月21日。
- Advisory Group on Mathematics and Artificial Intelligence:Purpose, Independence and Current Task,资料核验时可访问。
- Math and AI:A Severe Misalignment of AI in Mathematics,2026年9月11日,DOI 10.5281/zenodo.22737750。
- OpenAI:On the Navier–Stokes Millennium Prize Problem,2026年9月8日。
- Wikimedia Commons:Fuld Hall, Institute for Advanced Study,作者Zeete,CC BY-SA 4.0。
资料核验时间:2026年9月22日09:16(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。