NEWS & INSIGHTS
Claude Opus 5.5称典型任务降本40%:价格表到底降了多少?
Anthropic于2026年9月22日发布Claude Opus 5.5,称它在多数工作中达到Claude Fable 5.1的水平,同时比Opus 5运行成本低约40%。对开发者来说,最该问的是:这个“降本40%”是每个token的标价都降了40%,还是完成一项任务的总账发生了变化?两者并不相同。
官方公布的API标准价是每百万输入token 4美元、输出token 20美元,均比Opus 5低20%;缓存读取为每百万token 0.20美元,比Opus 5低60%。约40%的典型任务成本降幅是Anthropic根据默认设置下的工作负载测算,包含模型完成任务时使用的token数量变化,不能直接套到每个项目的账单上。
40%的差额究竟从哪里来?
公布的单价分成输入、输出、缓存读取和缓存写入四项。相同用量下,输入和输出各省20%,缓存读取省60%,缓存写入从6.25美元降至5美元,同样省20%。只有在一项任务的token结构和总量确定后,才能算出实际节省比例。
| API标准价(每百万token) | Opus 5 | Opus 5.5 | 单价变化 |
|---|---|---|---|
| 输入 | 5美元 | 4美元 | 下降20% |
| 输出 | 25美元 | 20美元 | 下降20% |
| 缓存读取 | 0.50美元 | 0.20美元 | 下降60% |
| 缓存写入 | 6.25美元 | 5美元 | 下降20% |
举例说,某次任务恰好使用100万输入token、20万输出token和200万缓存读取token,按上述标准价且不计其他费用,Opus 5的费用为11美元,Opus 5.5为8.4美元,降幅约23.6%。这是用相同token量算出的示例账单,不是Anthropic的典型任务测算。若新模型完成同一目标时还能减少调用轮次和输出token,任务级降幅才可能进一步扩大;若几乎不用缓存、任务步骤也没减少,就不能期待每次都省40%。
Anthropic还称,Opus 5.5的输出速度比Opus 5快30%以上。速度、token使用量与计费不是同一个指标:更快返回可以缩短等待,未必自动降低单次API费用。Fast mode标价则为每百万输入8美元、输出40美元,不能与标准模式混算。
性能分数能说明什么?
Anthropic公布的Terminal-Bench 4.0结果为Opus 5.5得66.4%、Opus 5得52.3%,并给出Opus 5.5约±2.6个百分点的标准误差。这个基准衡量命令行环境中的多步骤任务表现,说明在特定测试设置下存在明显进展,但不等于所有真实仓库、成本约束和安全配置都能复现相同差距。
官方说明还指出,主要基准结果通常使用自适应思考的最高努力档位,Terminal-Bench 4.0中Opus 5.5使用xhigh档。某些高风险领域任务触发保护措施时,会转由其他Claude型号完成。读者比较模型时,需要把努力档位、测试工具、回退机制、标准误差和每任务成本一起看,而不是把一行百分比当作普遍排名。
独立评估给出了什么边界?
非营利评估机构METR于同日公开预部署评估摘要。它获得约10个工作日的API访问,使用五类任务,并结合Anthropic提供的问卷、访谈及一项尚未公开细节的内部研发加速评估。METR判断,Opus 5.5在AI研发能力上较Fable 5.1有小幅提升,可能提高研究人员效率并自动化部分环节,但现有证据不支持“它已能完全自动化AI研发”。
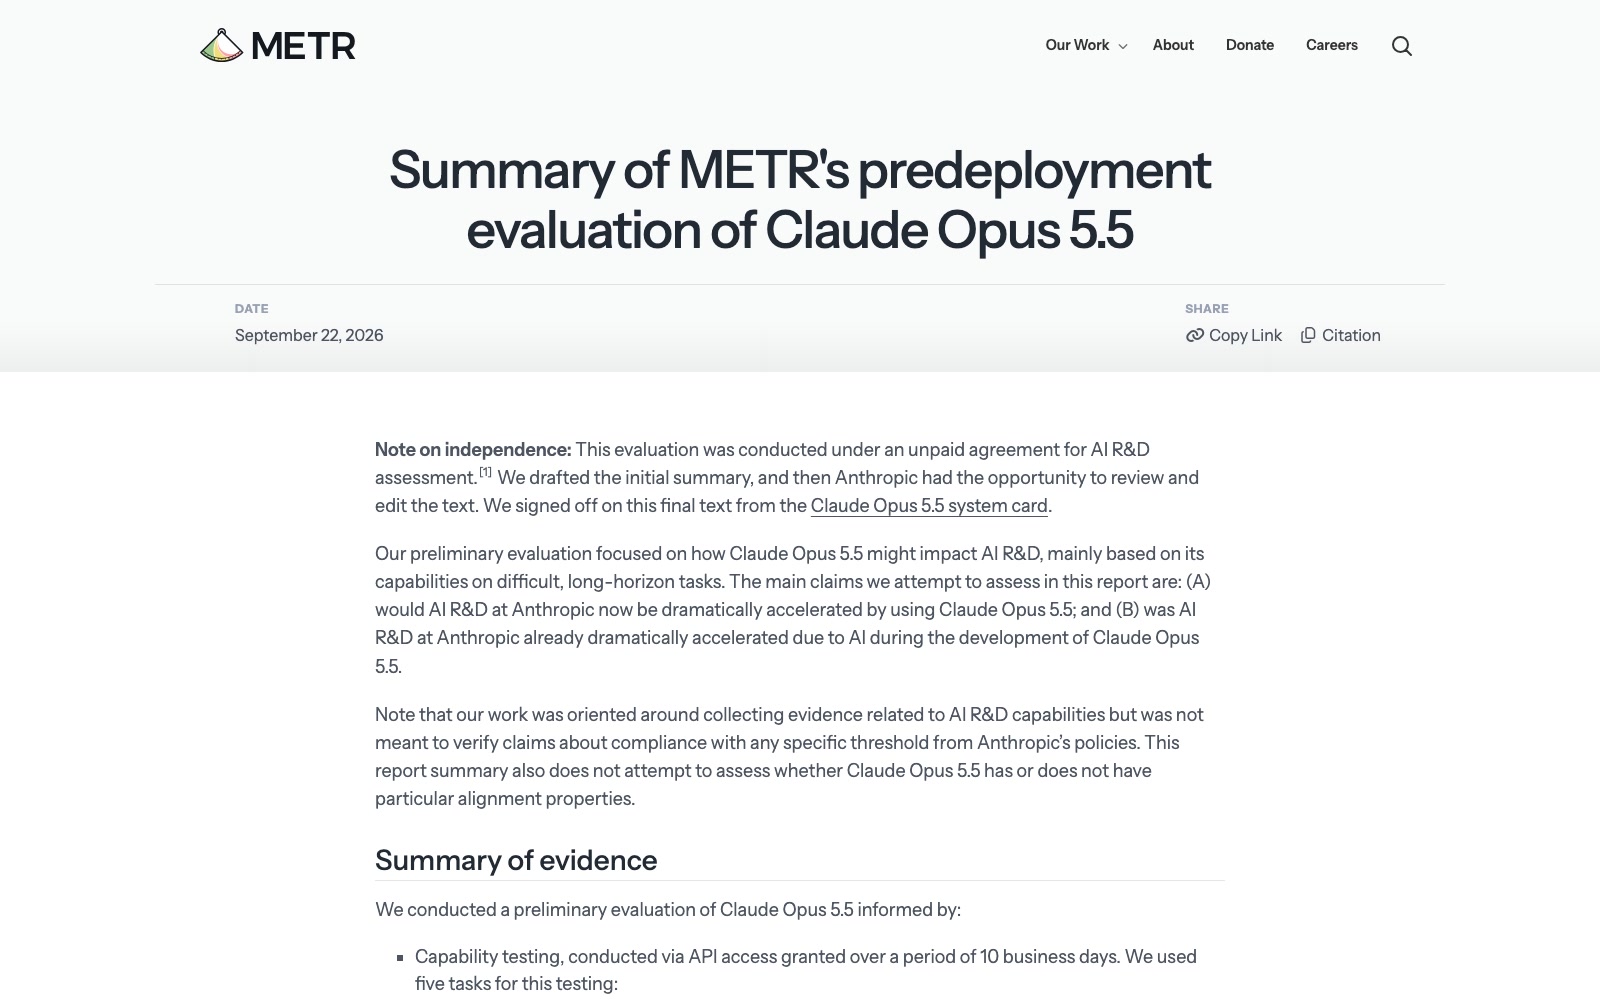
独立性也有可核对的限定:METR称这项AI研发评估基于不收费协议,初稿由METR撰写,Anthropic有机会审阅和编辑,最终文字由METR签署。METR同时说明,这份摘要并不验证Anthropic安全政策的阈值合规,也不评估Opus 5.5是否具备特定的对齐属性。因此,Anthropic关于“最强自动行为审计成绩”的陈述应归因于企业自测,不能借METR的名字包装成已经获得同范围的独立认证。
什么团队最值得试用?
缓存命中率高、会反复读取同一仓库上下文的编码代理,最有机会享受60%的缓存读取降价;多步骤任务若新模型确实减少往返调用,也可能进一步压低总成本。短问答、很少使用缓存的流程,更接近输入和输出单价下降20%的情形。
上线前可以用同一批真实任务做小规模对照:固定成功标准,分别记录最终通过率、总输入与输出token、缓存读写、调用次数、耗时、人工复核和回退次数。必要时还要单独统计Fast mode。我们此前分析Anthropic内部AI研发自动化指标时也指出,单一比例若缺少分母和任务边界,很难转化为团队自己的收益估算。
这次发布的可核验变化是价格表、可用渠道与公开测试结果;“典型任务降本40%”仍取决于工作负载。METR报告为AI研发能力提供了一个独立但范围有限的视角。真正影响采购和部署决策的,是同一任务在本地流程中的质量、用量和复核成本。
资料来源
- Anthropic:Introducing Claude Opus 5.5,2026年9月22日。
- METR:Summary of METR's predeployment evaluation of Claude Opus 5.5,2026年9月22日。
- Anthropic:System Card: Claude Opus 5.5,2026年9月22日。
资料核验时间:2026年9月23日09:14(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。