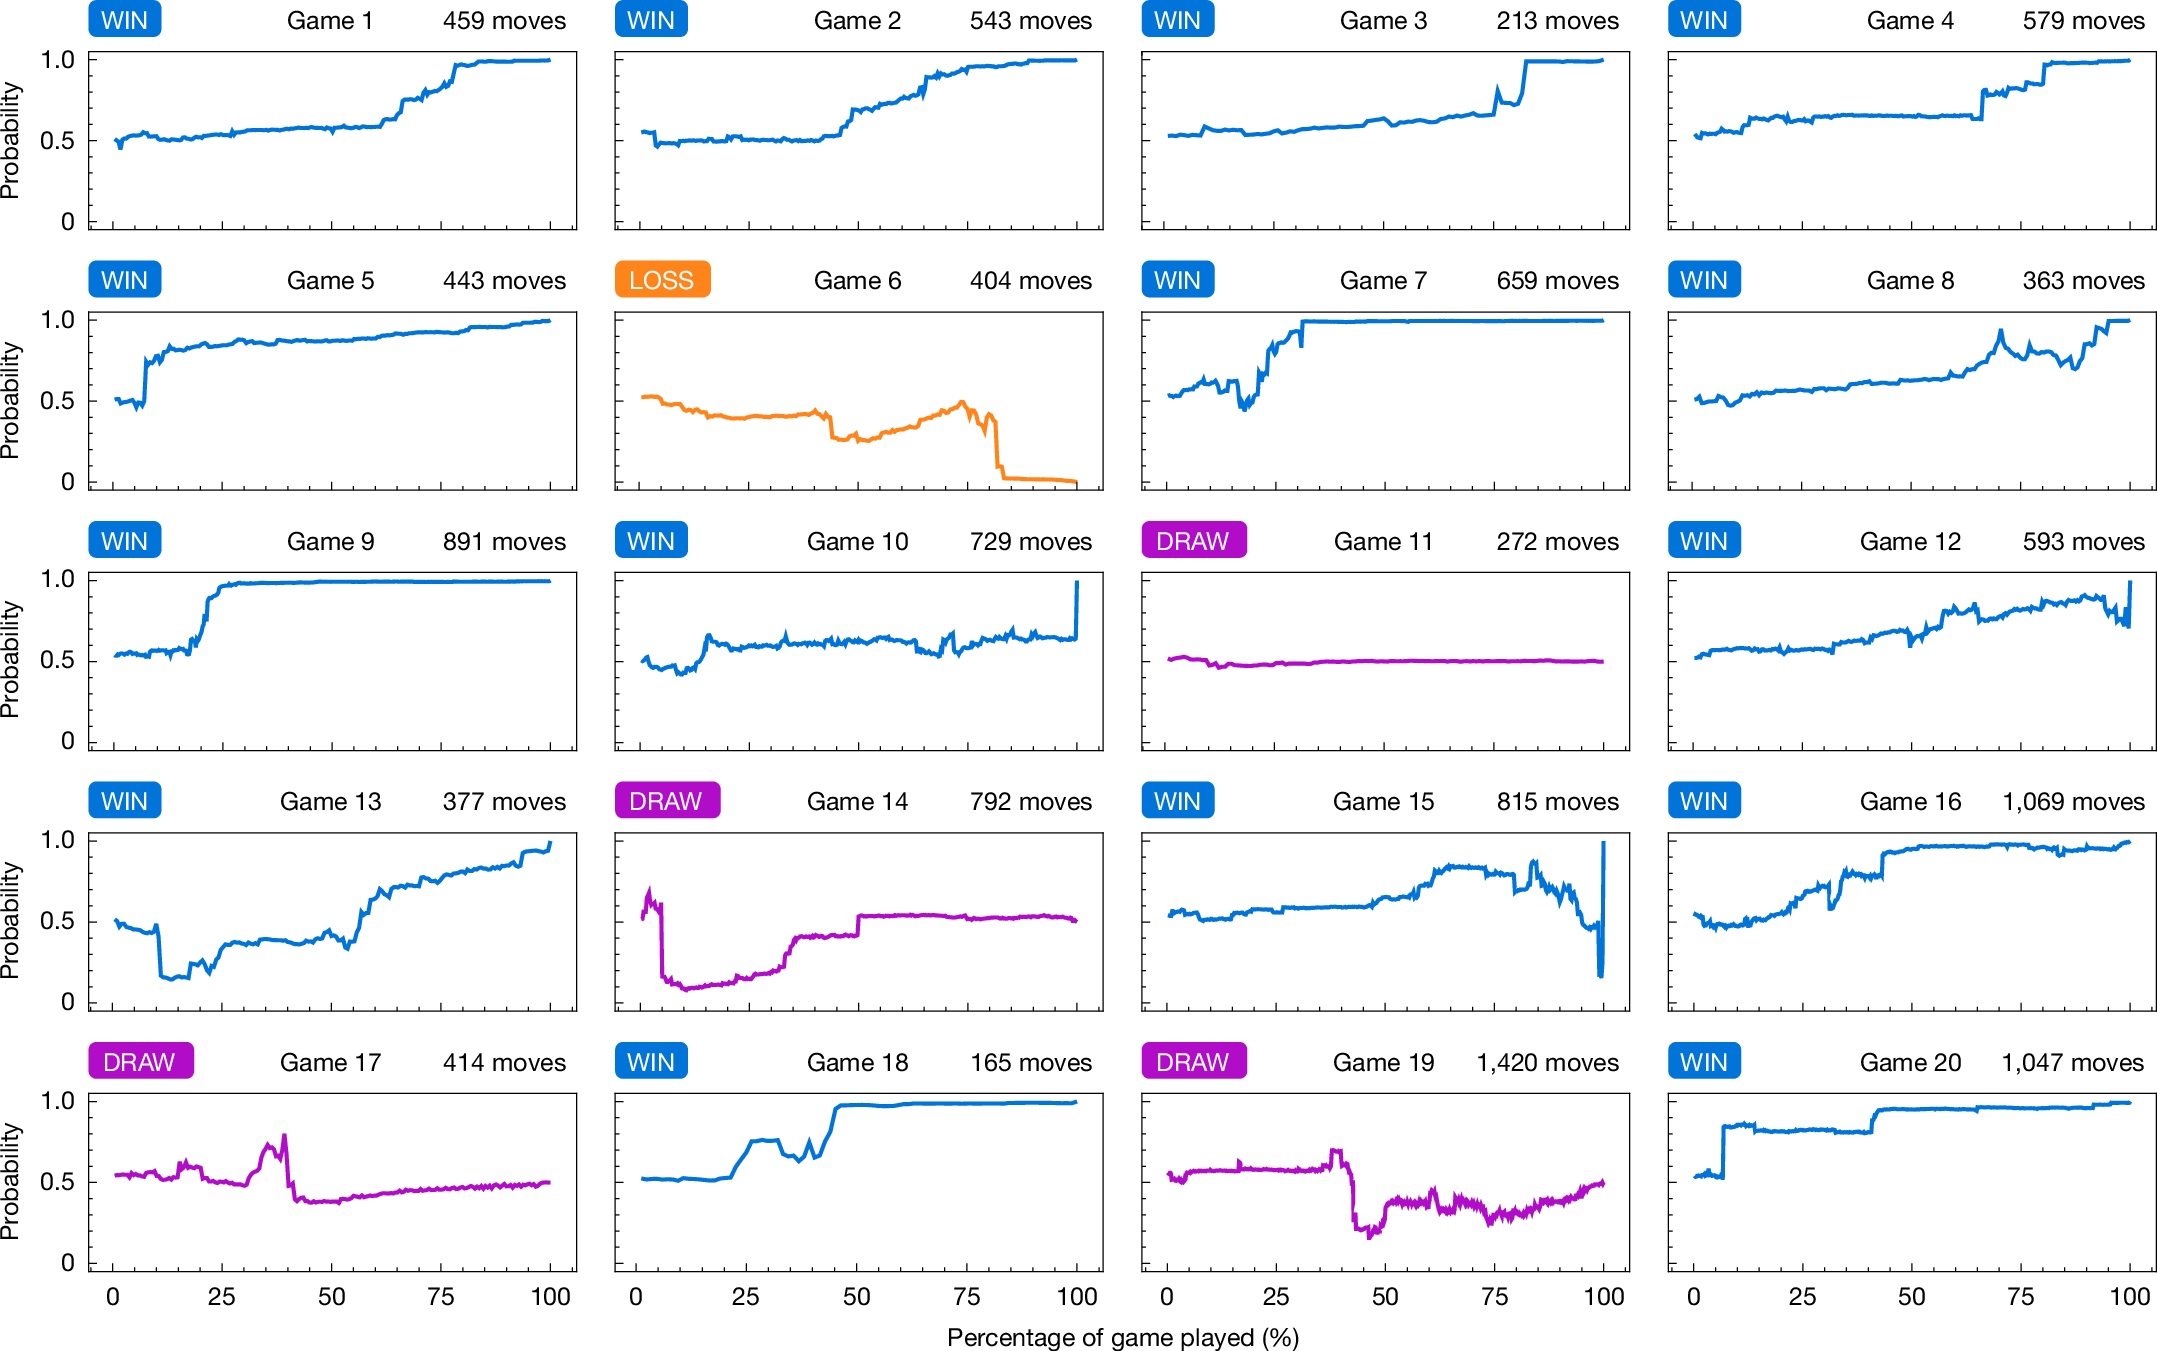
2026年9月30日,《Nature》发表Ataraxos研究,报告这个AI在与顶尖Stratego棋手Pim Niemeijer的20局系列对战中取得15胜、1负、4平。MIT同日介绍了这项由多所高校参与的工作。这里的新消息是研究成果的正式发表,不是说20局比赛刚在9月30日举行。
这项进展关注一个比“AI又赢了棋”更具体的问题:看不到对手全部信息时,怎样作出决策?理解成果,首先要分清85%有效胜率的计算口径,再看它使用了什么信息、接受了什么测试。
85%有效胜率不等于85%的棋局直接获胜
论文把胜局计为1、平局计为0.5、负局计为0。按这一定义,20局取得17个胜局等价分,故有效胜率为85%;如果只统计直接获胜的棋局,则是15÷20=75%。两种口径描述的是同一组结果,并不矛盾。
| 结果 | 局数 | 计入有效胜率的分数 |
|---|---|---|
| 胜 | 15 | 15×1=15 |
| 平 | 4 | 4×0.5=2 |
| 负 | 1 | 1×0=0 |
作者称系列对战分布在三周内,给棋手留出休息和准备时间;AI则不会针对这位对手继续适应学习。这是明确测试条件下的强表现,不是面向所有棋手、所有规则的固定获胜概率。论文也提醒,人类策略会逐局变化,不能简单假设这些比赛独立同分布。
它不是“看穿”棋子,而是比较可能的局面
Stratego双方各有40枚棋子,开局时对手的棋子身份不可见,交战会揭示相关身份。下面的论文示意图说明了这种信息边界:隐藏信息不是画面不清晰,而是规则本身不让玩家知道。
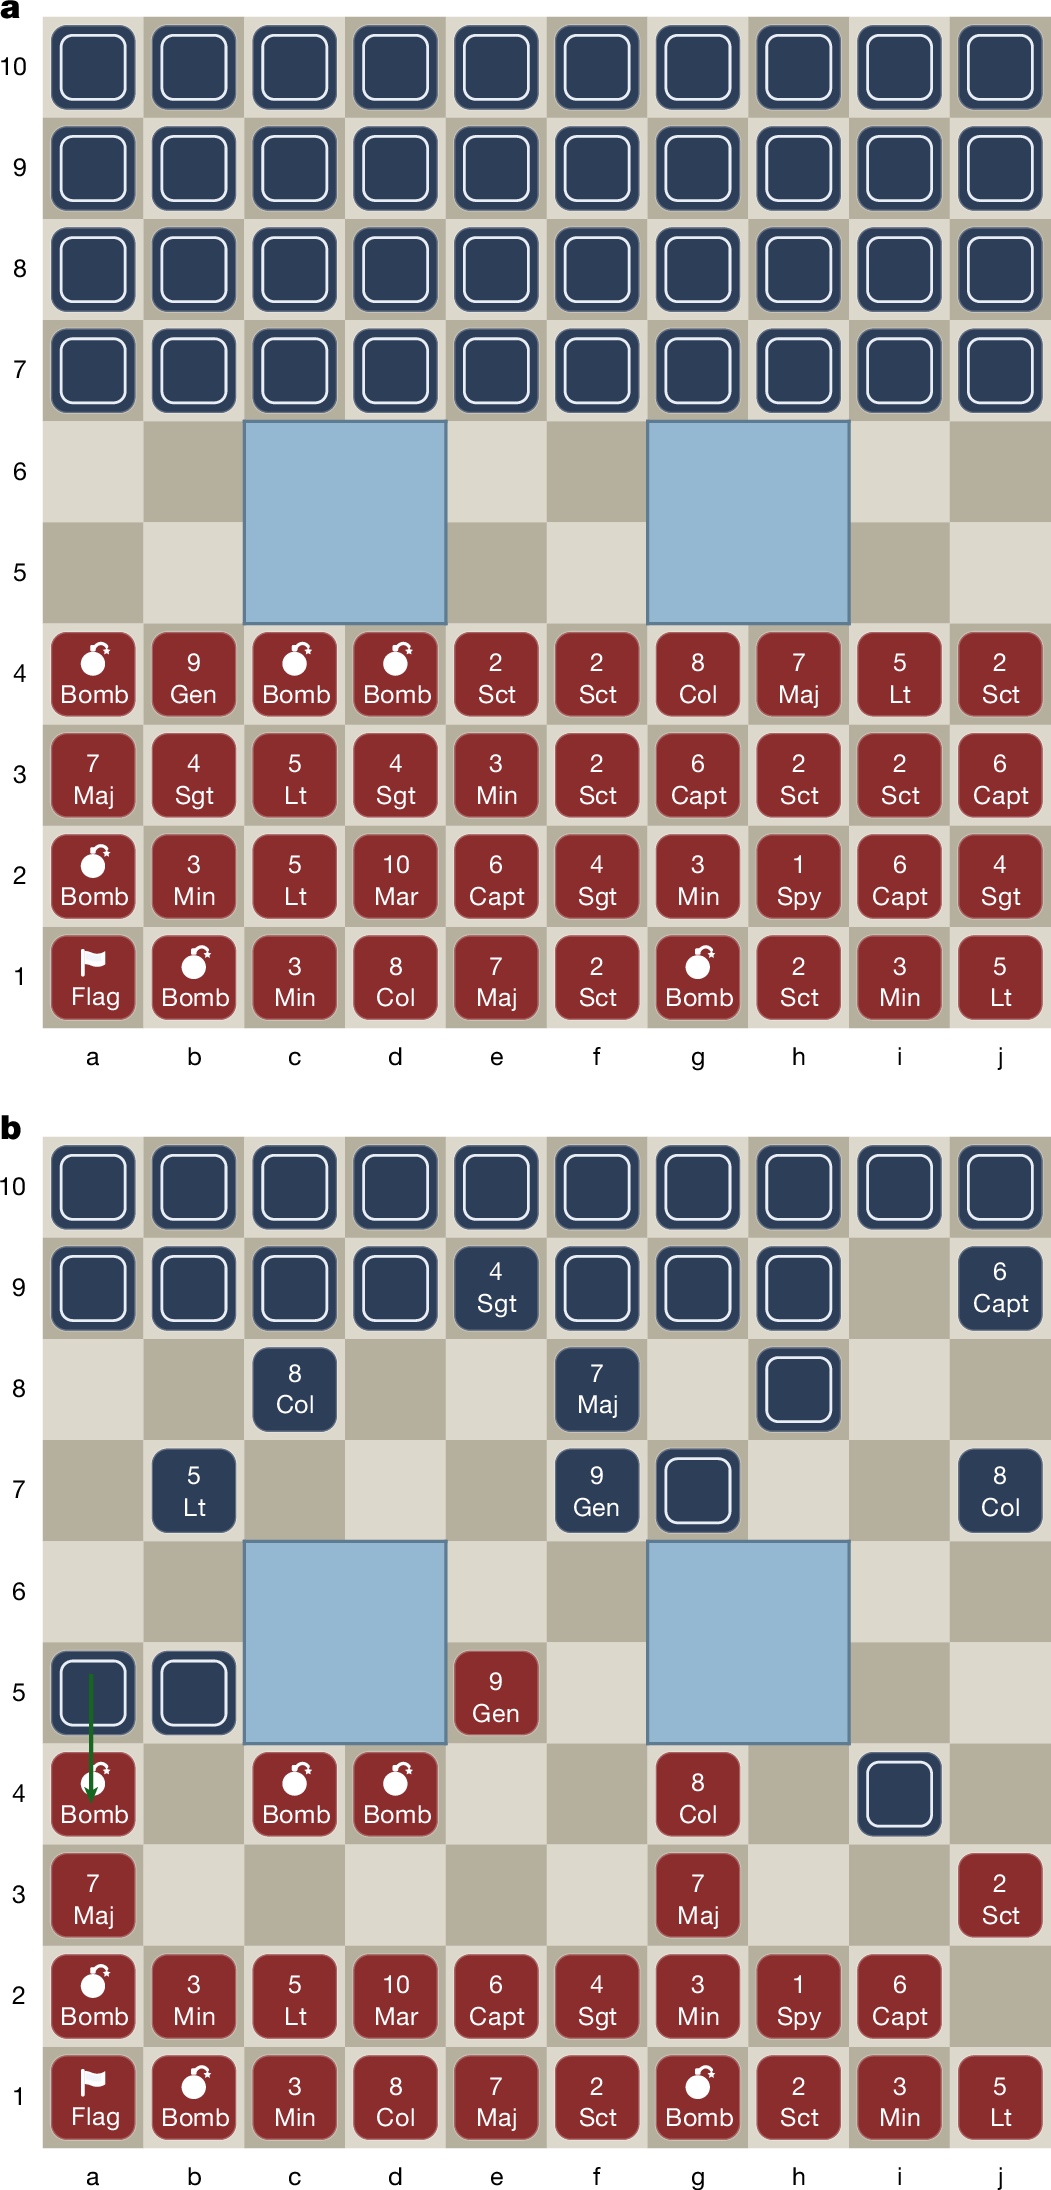
Ataraxos先通过自我对弈学习布局与行动策略,再训练一个“信念网络”,根据当前可见信息估计隐藏棋子的可能身份。决策时,它抽样出可能的完整局面,模拟候选行动的后续结果,综合价值估计后调整当前行动的选择。
因此,信念网络输出的是假设,不是对对手秘密信息的读取。也不能把这里的“生成模型”直接等同于聊天大模型:它的目标是建模游戏中的隐藏状态,服务于搜索与行动选择。
训练效率的进展,也有具体计算条件
论文报告,自我对弈强化学习阶段使用16张NVIDIA H100训练一周,信念网络使用4张H100训练四天。作者估计训练费用为数千美元,并把效率改善归因于算法和GPU加速模拟器;这些是该研究的训练条件与成本口径,不是完整研发预算,也不是当前可购买服务的报价。
对比更值得看清的是:训练时的自我对弈、实战时的局面搜索,以及实际比赛结果,是三类不同证据。训练所需资源下降,不会自动证明每步推理没有成本;更高的棋局成绩,也不等于解释性或安全性同时达标。
离现实决策,还缺什么证据?
论文的结论将应用前提落在能构建快速、准确模拟器的战略决策问题上。本文分析:棋盘有固定规则和明确胜负,现实任务还可能出现目标变化、信息缺失方式变化,以及无法反复试错的代价。因此,迁移时至少需要另行核验模拟器是否可信、目标是否适当、失败如何受控;不能仅凭棋局表现声称它已经能可靠处理现实谈判或其他高风险决策。
这也有助于区分两类AI进展:Ataraxos研究的是隐藏状态下的博弈与搜索;本站此前介绍的Mu Zero视频学习研究处理的是机器人运动表示与硬件执行。模型名称、演示效果和实际应用验证不能混为一谈。
资料来源与说明
- Samuel Sokota等:Scalable decision-making for games of imperfect information,正式发表于2026年9月30日,页面未提供具体发布时刻与时区。本文以原论文的Evaluation、Methods与Conclusion为主要依据。
- MIT News:This game-playing AI is the new champ at Stratego,报道日期2026年9月30日,页面未提供具体发布时刻与时区。它是参与机构的新闻说明,不是独立复现实验。
主要性能数字来自同一研究团队的论文;本文未开展对局、复现训练或采访。资料核验时间:2026年10月6日09:08(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。