2026年10月5日,《Nature Communications》发表了ProFormer研究:研究者用Transformer模型读取质谱中的肽离子特征,对单细胞和血浆蛋白组样本进行分类。这项工作的价值,是探索如何把大量测量信号转成可解释的样本判断;它展示的是研究测试结果,不能直接等同于已投入临床的诊断能力。
最容易被误读的数字是“100%敏感度”。它是否意味着模型完全不会判断错?答案是否定的。理解这篇论文,需要同时看分类任务、判定阈值和特异度,也需要分清模型输入与上游数据处理。
它读取的是肽离子特征,而不是一张蛋白名称清单
传统蛋白组分析常先利用二级质谱信息识别肽段,再汇总到蛋白层面。ProFormer的分类器则把一级质谱(MS1)肽离子特征作为表格输入:例如保留时间、质荷比和强度,还可加入离子淌度。一个样本包含许多信号,模型先通过可学习的聚合模块把它们压缩成数据单元,再交给Transformer学习关系。
这不是把质谱图“拍照后交给AI”。论文提出保留单个信号的多维特征,减少把相邻信号合并成固定图像网格时的信息混杂。血浆任务中,作者还把质荷比分拆为质量和电荷特征,说明输入如何表示,本身就是模型设计的一部分。
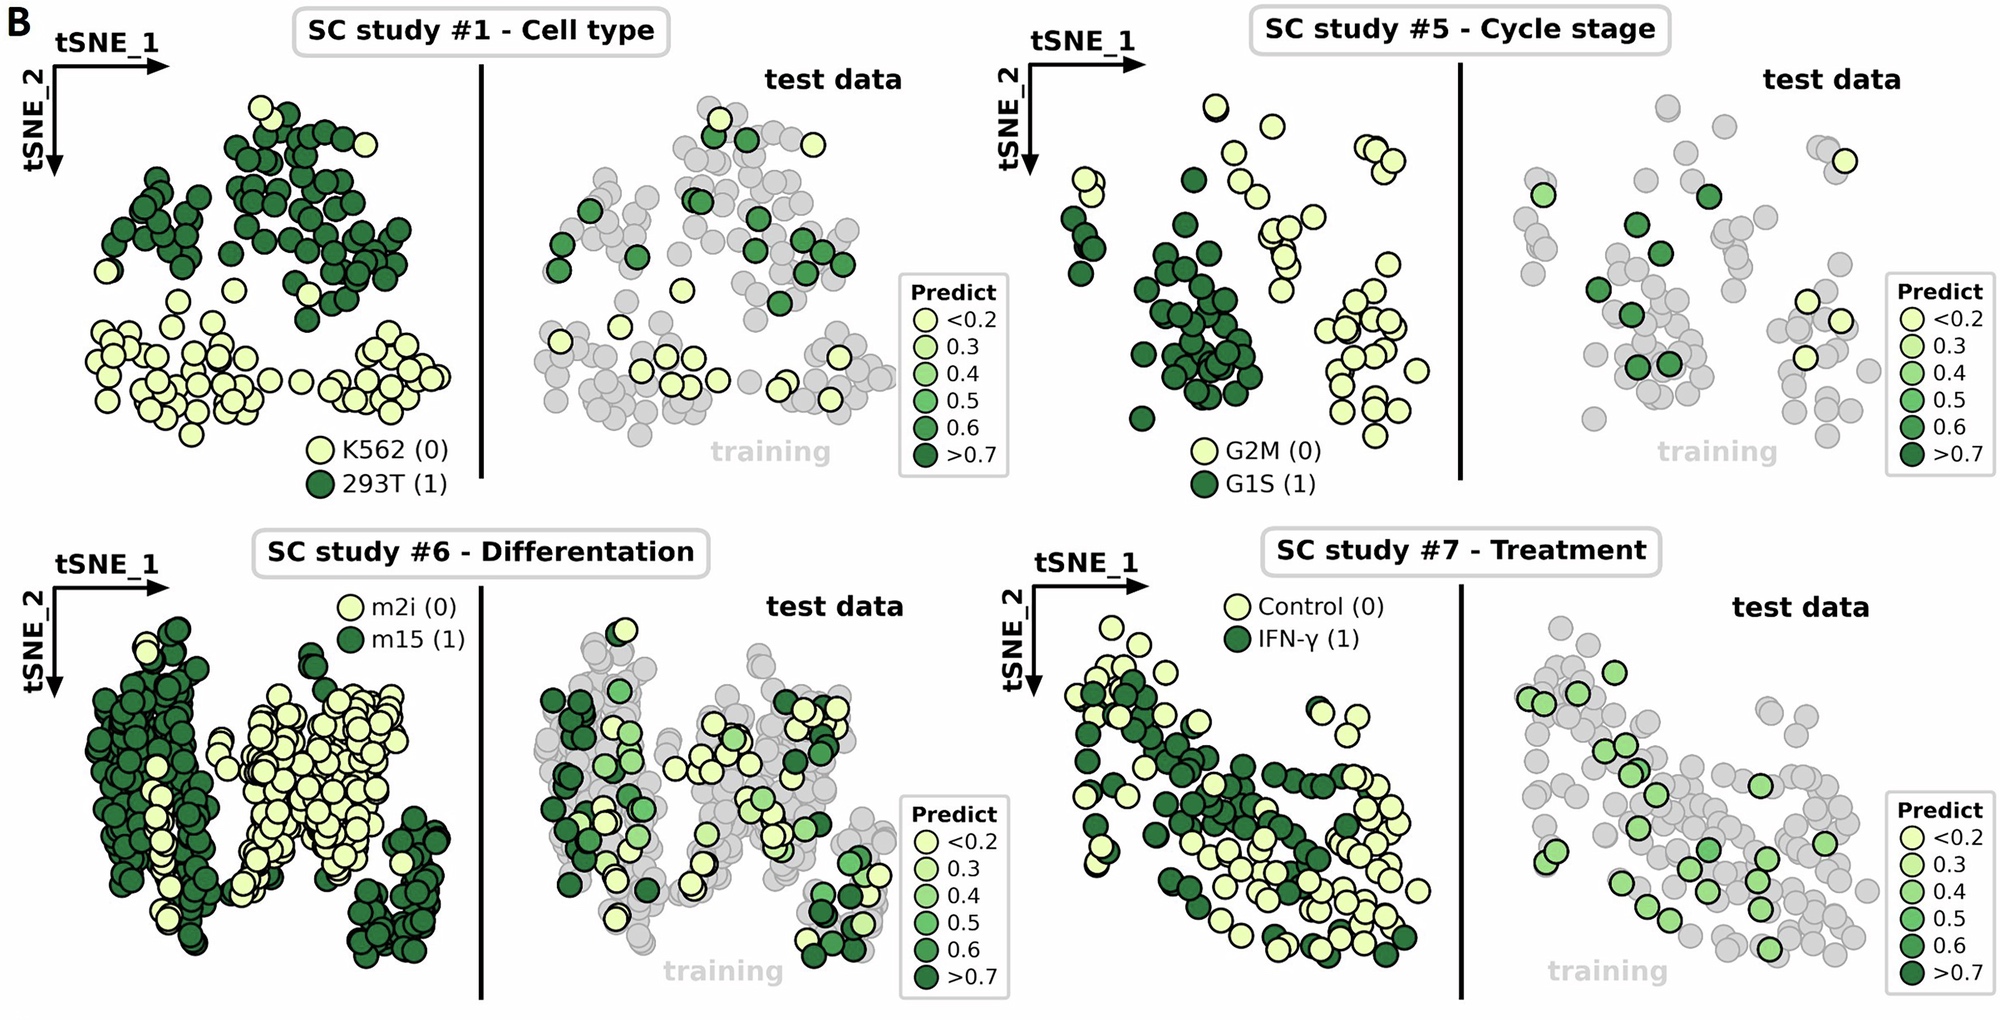
单细胞结果也提醒读者:不同分类任务的难度并不相同。图4B中,细胞类型、周期阶段的分布较清晰;分化状态、处理条件之间的重叠更明显。一个任务接近满分,不能推导出另一个任务也会接近满分。
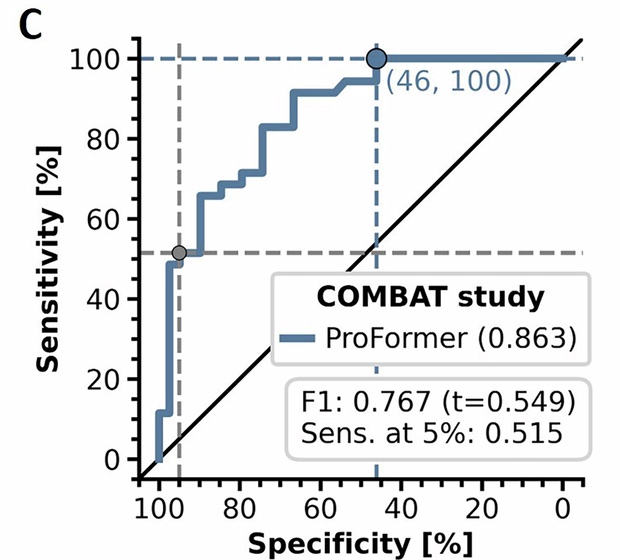
100%敏感度和46%特异度,可以同时成立
血浆案例使用既有COMBAT研究数据。论文描述的原始研究包含490名参与者,但ProFormer此处解决的是一个特定二分类问题:区分重症COVID-19样本与其余样本,后者包括轻症COVID-19、脓毒症、其他严重感染和健康组。它不是一次检验识别所有疾病,也不是针对普通人群的前瞻性筛查。
| 论文报告的指标 | 在这个测试中意味着什么 | 不能据此声称什么 |
|---|---|---|
| 测试集AUROC:0.863 | 反映模型在不同阈值下区分两类样本的能力。 | 不等于“86.3%的人判断正确”。 |
| 某判定阈值下敏感度:100% | 该测试集中的目标阳性样本在这一阈值下均被识别。 | 不保证未来任何人、任何机构都不会漏判。 |
| 同一工作点特异度:46% | 非目标类样本中约46%被正确排除。 | 不代表没有误报;对应的假阳性比例约为54%。 |
最后一行的54%是“1减去特异度”的指标换算,不是另一项实验结果。也就是说,降低漏判并不自动消除误报。论文图5C还列出了F1指标及其阈值;不能把不同工作点的数字拼成一套同时成立的性能承诺。
测试规模同样重要:按图5D各组标注的样本数相加,这一血浆测试集为74个样本,其中35个属于重症COVID-19目标类。这个加总是对图中N值的核对,不能把原始研究的490名参与者全部说成此次独立测试对象。
分类器不需要蛋白名称,不等于整个流程不需要MS2
这是论文讨论部分明确写出的限制。ProFormer采用不依赖肽段或蛋白身份名称的分类器设计,但这项概念验证中的MS1特征提取,仍受MS2肽段鉴定信息辅助。上游处理与下游模型输入,是两个层次。
作者把完全不依赖数据库检索、独立于MS2甚至不采集MS2的运行方式,列为未来方法开发方向,需要进一步发展原始质谱数据处理算法。因此,“只用MS1特征分类”可以描述模型输入,“整条流程已经不需要MS2”则超出了现有证据。
作者提供了代码仓库,便于研究者查看流程和训练配置;但仓库演示使用模拟数据,不能把演示运行当成临床验证。本文所述性能来自原论文,代码仓库也不是一次独立团队复现实验。
从研究成绩到应用,还要跨过哪些边界?
本文分析:如果要进入实际使用场景,至少还要回答三个问题。首先,更换机构、仪器和采样条件后,性能能否保持?论文中的部分外部数据采用训练与测试划分,人工噪声测试也不能代替所有真实环境的验证。其次,目标人群和病例组成改变后,误报数量与后续复核成本如何变化?最后,在部署前确定的阈值下,能否通过前瞻性、多机构验证,而不是事后挑选最有利的指标?
这些问题不否定ProFormer在数据表示、样本分类和解释性方面的研究价值,而是决定它能在什么条件下被使用。正如AI流感预测相关研究需要先明确预测对象,蛋白组AI也需要先明确标签、数据来源和测试方式;群体趋势预测与样本分类并非同一种任务。
这次发表更准确的意义是:研究者给出了一个可继续验证的蛋白组AI分类方案。阅读它时,既要看模型做对了什么,也要看阈值、误报和上游处理条件。本文介绍科研进展,不作为个人诊断或治疗建议。
来源与资料说明
- Krull等:ProFormer: generalizable classification of single-cell and plasma proteomes using deep learning,《Nature Communications》,正式发表日期2026年10月5日;支持方法、实验指标、图4/图5及MS2依赖限制。论文页面未提供精确发表时刻或时区,本文不作推定。
- 作者ProFormer代码仓库,支持实现说明与模拟数据演示;README未标注统一发布日期,按本次访问内容核验。它不是独立的性能复核来源。
资料核验时间:2026年10月7日09:08(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。