2026年10月7日,《Nature》发表Byteification研究,Ai2同日发布机构公告,介绍Bolmo背后的方法及扩展到其他模型家族的权重。这项方法保留已有大模型的主体,通过两阶段增训,把输入输出改成字节级表示;研究中的Bwen 8B与Blama 8B分别来自Qwen3 8B Base和Llama 3 8B。
Bolmo并不是这一天才首次出现,Ai2此前已于2025年12月介绍该模型家族。本次值得关注的是正式论文、跨模型家族实验,以及阶段一检查点等研究产物。对关心代码、拼写和少见字符串处理的读者,它回答了一个具体问题:能否复用已经训练好的模型,而不为字节输入再从头训练一套大模型?
字节输入更细,但字节并不等于字符
多数语言模型先把文本切成固定词表中的词块或词片段,再交给模型。Byteification使用文本的UTF-8字节表示:一个字节有256种取值,同一个字符则可能由多个字节组成。因而,“按字节处理”不能简单说成“每个中文字符对应一个模型单元”。
它也不是把全部字节直接送进原来的深层Transformer。浅层局部编码器先处理字节,边界预测器将其组合成长度可变的片段,再把每个片段的表示送给原模型主体;局部解码器最终恢复字节级输出。这样既保留较细粒度的信息,也避免让最昂贵的主体对每个字节都独立执行一次完整计算。
“不用外部固定子词分词作为输入接口”,也不等于彻底删除了所有子词知识。论文的方法仍利用源模型的嵌入信息和训练时边界监督。它改变的是表示与处理方式,而不是凭空丢弃既有模型的积累。
两阶段改造,分别复用什么、重新学什么?
| 阶段 | 模型主体与新增组件 | 论文报告的训练量 |
|---|---|---|
| 阶段一:蒸馏 | 冻结原模型主体参数,训练局部编码器、解码器、边界预测器和输出头,尽快接近源模型行为。 | 9.8B token,约43B字节。 |
| 阶段二:端到端增训 | 更新整个模型,使主体适应字节信息,也可调整平均每个片段包含的字节数。 | 39.3B token,约173B字节。 |
49.1B训练token,不等于49.1B字节
两阶段合计49.1B token,也就是491亿token;这里的训练数量按Dolma2分词器统计。论文分别给出的字节数合计约216B,即2160亿字节。这些是同一批文本在不同单位下的计数,不应混用。
论文把该附加训练量描述为低于典型预训练预算的1%。它比较的是在已有模型基础上的改造投入,而不是证明一个同等能力模型从零训练只需原成本的1%。此前训练主体所用的数据与计算已经发生;阶段一和阶段二的反向传播范围也不同,token数量本身不是完整算力账单,更不是API价格表。
Ai2公开阶段一检查点的意义,是让研究者更快测试新的字节级组件,而不是每次都重新完成整段训练。本文核验的作者模型合集也列出了Bwen、Blama及相应阶段一版本;合集的文件更新日期与机构公告日期属于不同信息,不能据此推定每个文件的首次公开时刻。
更大片段可以省计算,但并非越大越好
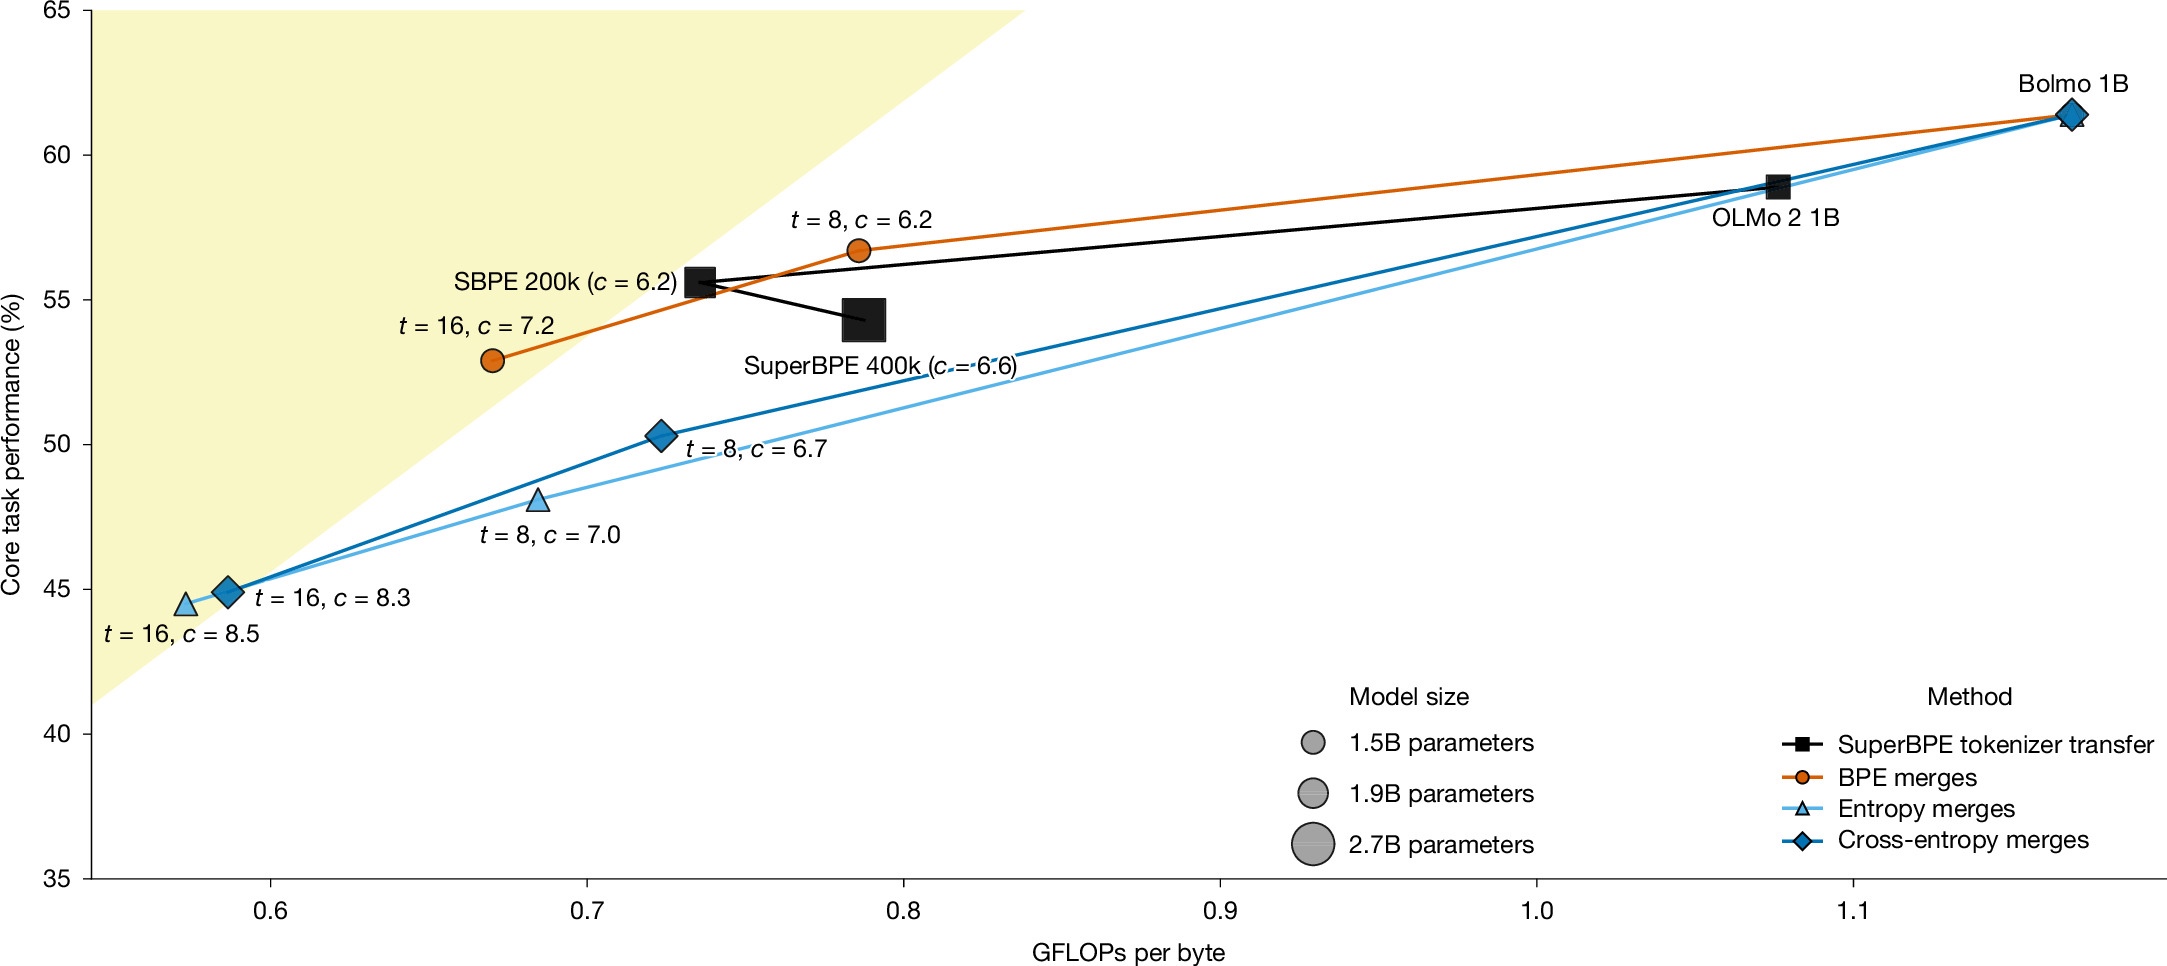
片段包含更多字节,通常能减少模型主体需要处理的片段数。论文图2在1B模型设置中比较了这种策略与扩大子词词表的策略:后者到一定规模后,输出分布计算变得更贵;字节模型则能调整片段粒度,形成另一条性能与计算量的权衡曲线。
这不是“压缩率翻倍,速度必然翻倍”的公式。目标压缩率与实际压缩率可能不同,增加压缩也可能降低任务成绩;图2的横轴是理论运算量指标,不能直接换算成每台显卡上的实际延迟。论文的总体结论是接近源模型的能力与推理速度,而非所有任务全面领先。
字符任务的改善也不宜只归因于输入变成字节。论文加入了约75M token的合成字符训练数据,包含拼写、倒序和替换等任务,并用同一数据混合继续训练原模型作为对照。研究观察到的是架构、训练目标与数据共同作用的结果;某些代码测试的多次尝试指标更高,单次尝试指标却更低,不能合并成“写代码必然更准”。
“免额外后训练”,不等于整个改造不用训练
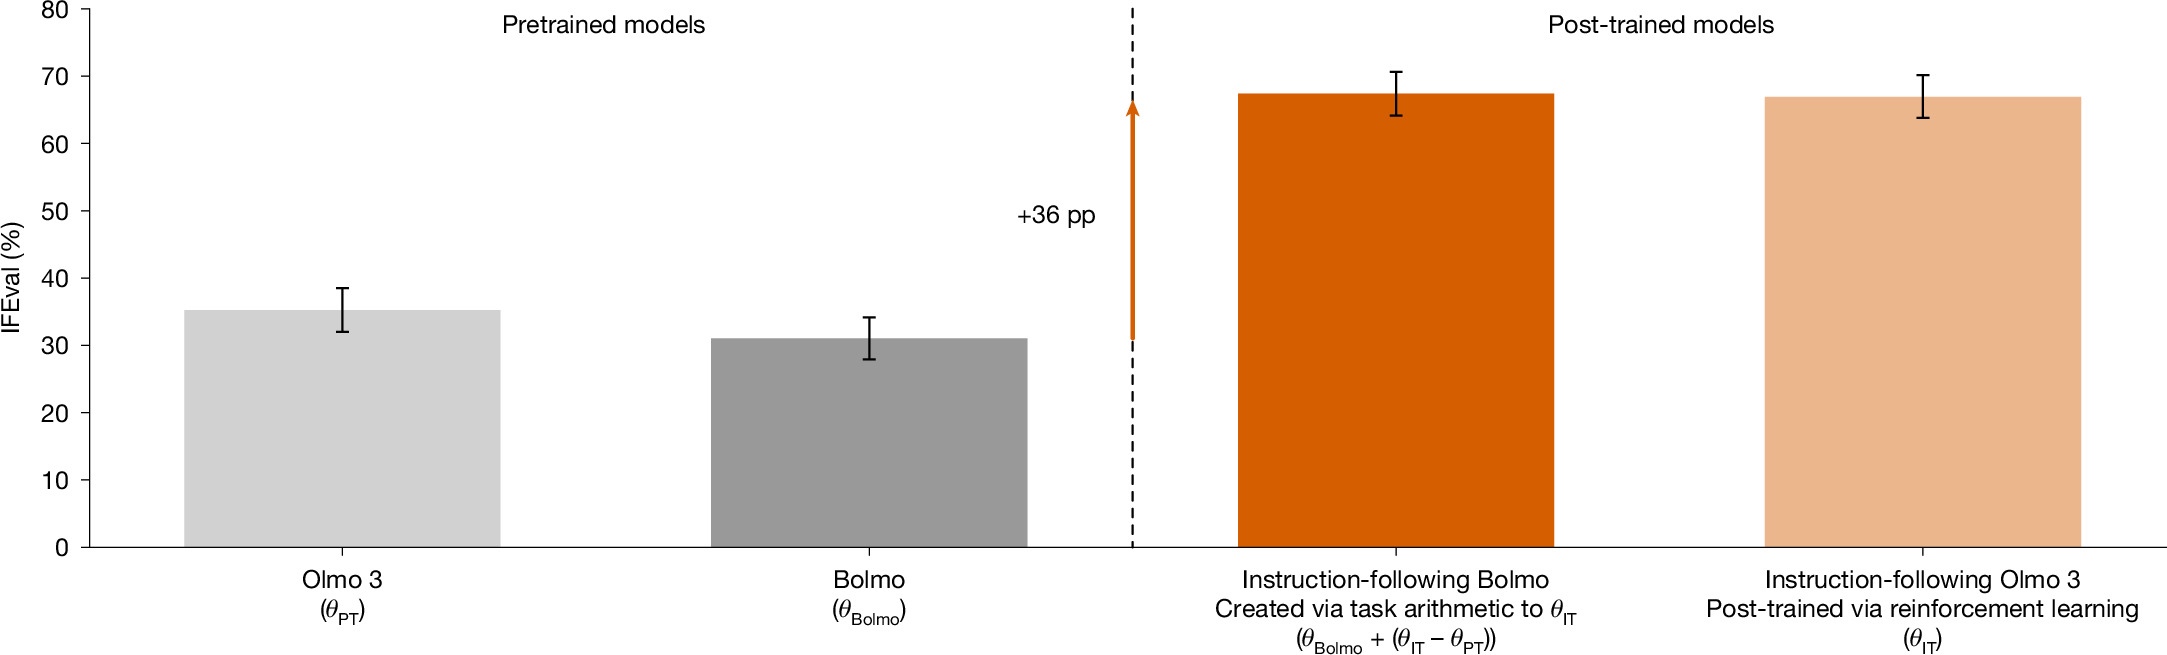
论文另一个实验是任务算术:把源模型后训练前后的Transformer权重差,加入对应的字节模型主体。图3显示,这种方式可以把已有的指令遵循能力迁移到Bolmo,而无需为这一步再跑一轮训练。
但前提是已经有完成改造的基础字节模型和相应源模型的后训练检查点,原有后训练本身也不是免费的。作者还指出,嵌入参数需要能恢复为基础模型的值而不造成较大性能损失,这通常可行,却不总成立。因此,它是一种有条件的复用途径,不是把任意模型直接相加都能成功的通用保证。
这次进展更适合怎样理解?
本文分析:它为研究者提供了一个更便于试验的入口,让字节级架构不必总从随机初始化起步。对于代码、罕见字符串和逐字符操作,细粒度表示值得关注;对于普通聊天和生产部署,仍需比较目标任务、延迟、资源占用与可靠性,公开基准成绩不能替代现场验证。
此前数字与光学混合深伪检测研究也说明了共同开销和局部改造之间的区别:复用原组件能降低试验门槛,但节省某个环节,不意味着全部投入消失。Byteification的意义是增加模型表示方式的选择,而不是宣布子词模型已被淘汰。
Ai2公告提出字节表示未来可能延伸到其他数据类型,但本文核验的主要实验是语言与文本任务。字节是通用的数据载体,并不意味着这些权重已经具备图片或音频理解能力。本文所述性能来自作者研究,未将代码公开或权重可访问当作独立团队复现。
来源与资料说明
- Retrofitting language models to operate over bytes,Minixhofer等,《Nature》,正式发表日期2026年10月7日;支持架构、训练数量、图2/图3、性能对照与适用限制。
- Ai2:Now in Nature: Retrofitting language models to operate over bytes,公告日期2026年10月7日;支持本次机构发布内容与研究产物说明。
- 作者Bolmo模型合集与bolmo-core代码仓库,核验公开产物及复现入口;动态页面不设一个统一发布日期,也不作为独立性能证据。
论文及公告页面未给出精确发表时刻或时区,本文不作推定。资料核验时间:2026年10月9日09:03(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。