10月8日,《npj Artificial Intelligence》正式发表Reinforcement Failing研究。研究团队没有只挑选训练得分最高的AI策略,而是比较一组策略在简化模型和更细致仿真中的表现差异,再由研究人员分析失败轨迹、补充模型机制。这项研究提出的问题很实际:训练环境中的好成绩,究竟来自有效策略,还是来自模型遗漏的约束?
论文以肿瘤治疗决策的计算模型为案例,但核心验证发生在仿真中,不是让AI给患者开药,也没有报告新的临床试验。对关心AI可靠性的读者而言,它的价值在于提供一种检查训练环境的方法,而不是一份可以照搬的治疗方案。
先区分三种模型,才能读懂“失败”
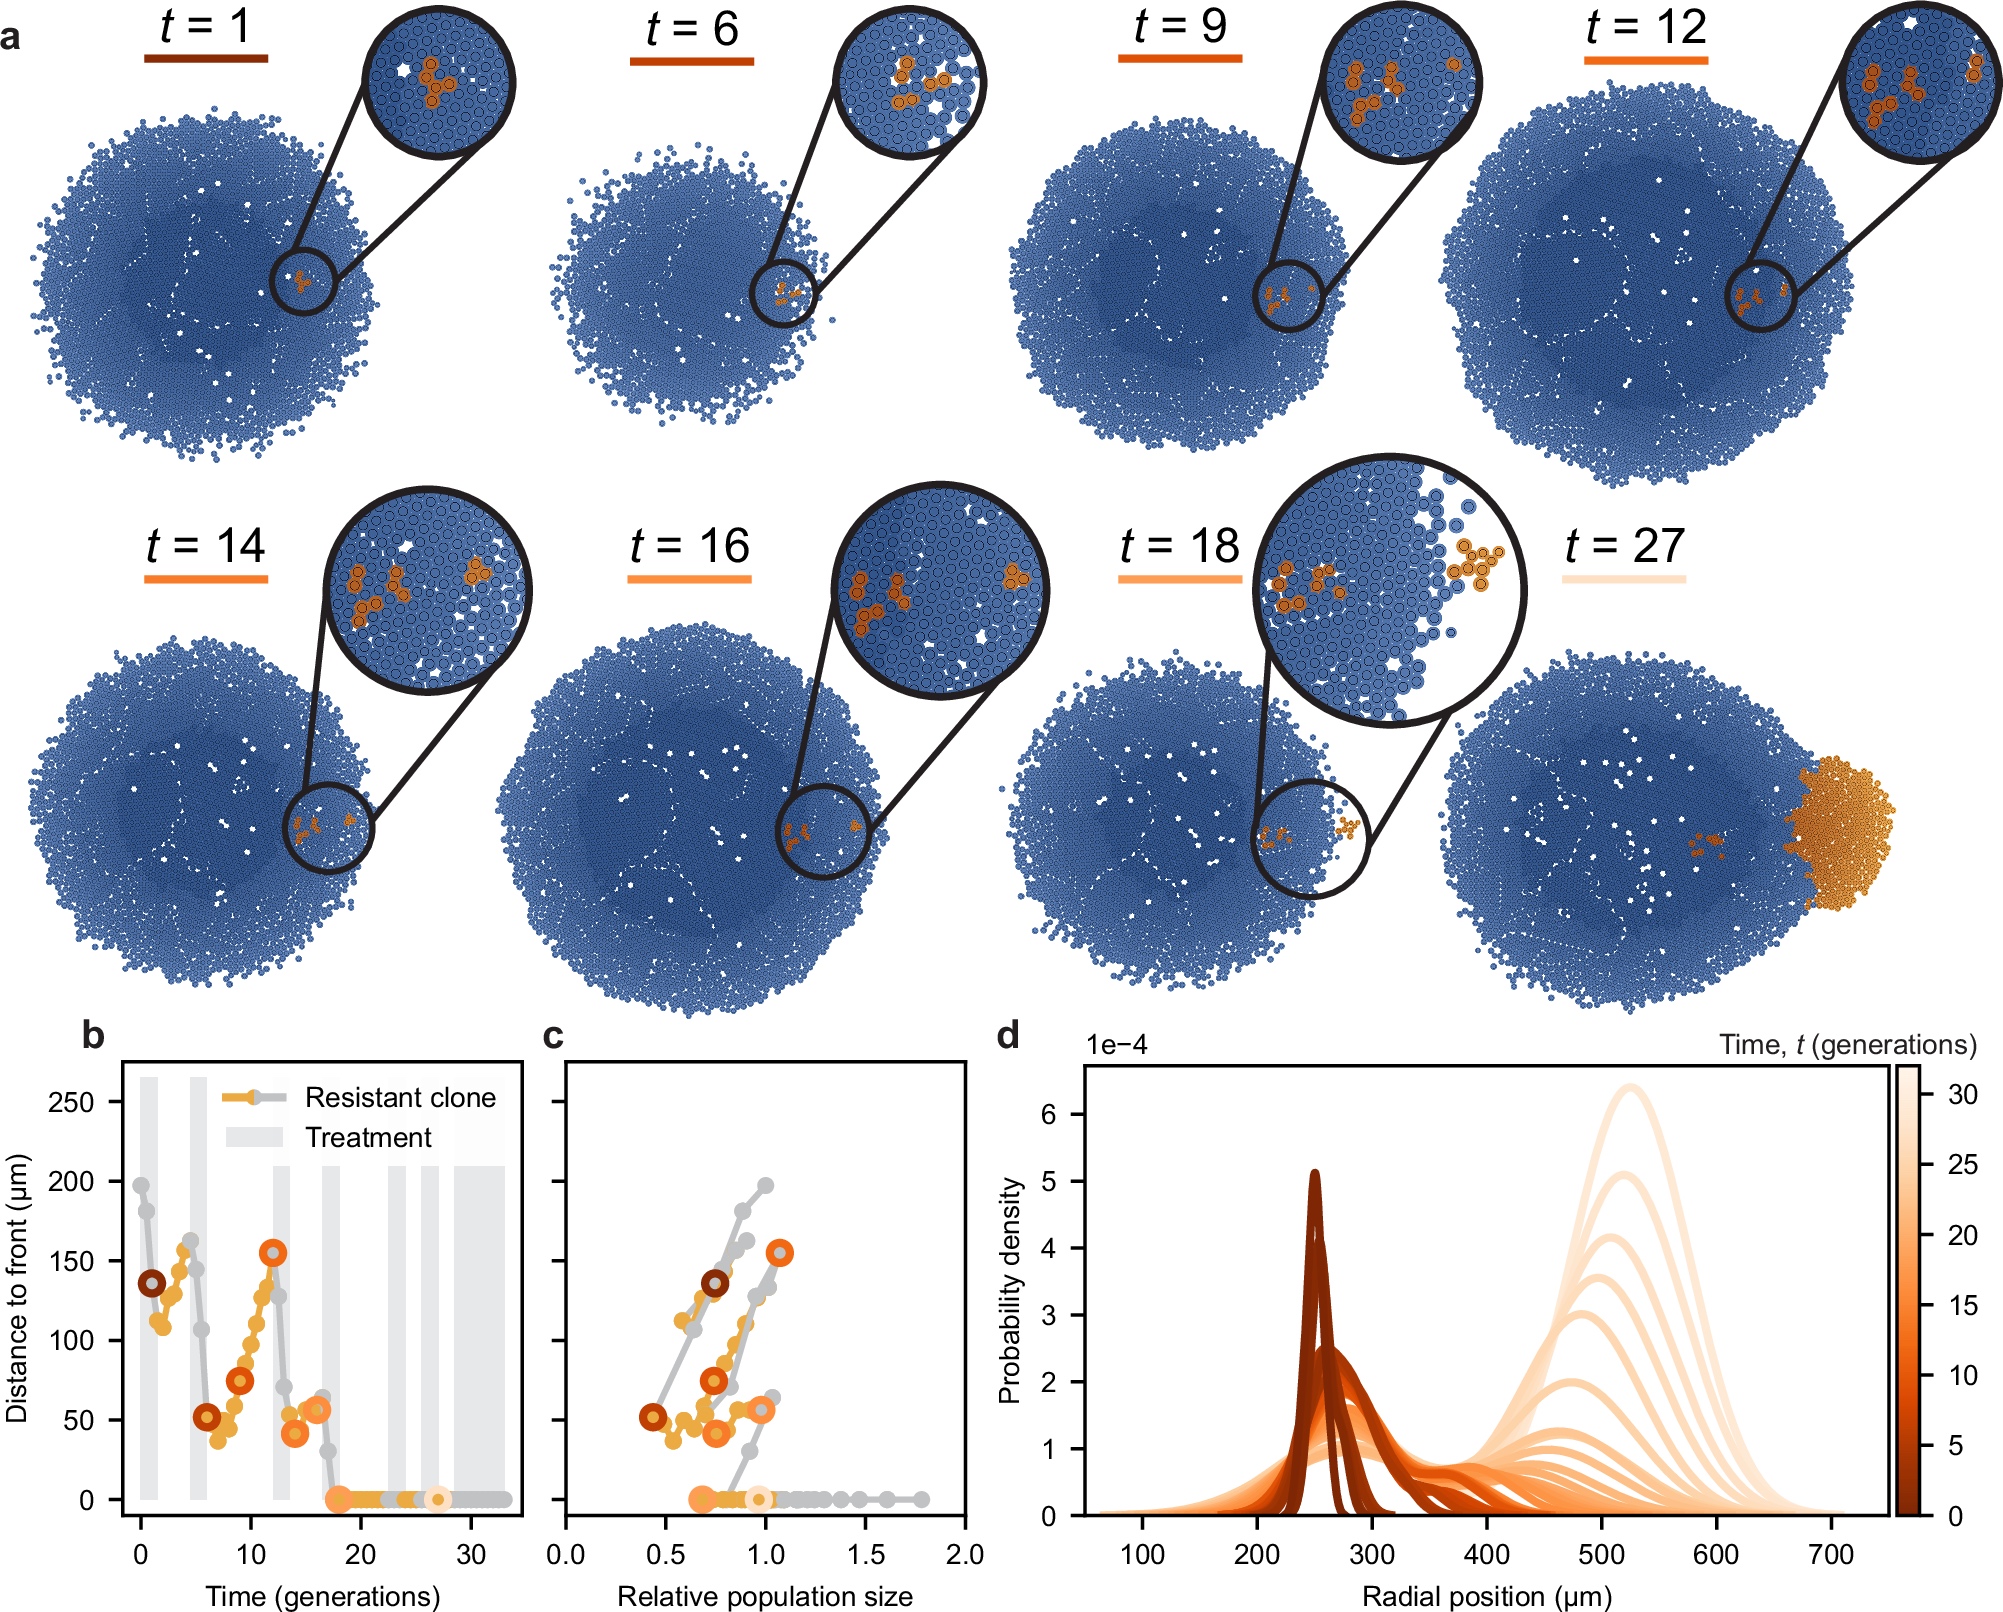
参考环境RE使用PhysiCell模拟细胞生长、资源扩散、空间组织与机械运动;为了降低反复训练的计算负担,团队把它简化为常微分方程构成的TE0。补充遗漏机制后得到的TE+,仍然是更便于训练的模型,并不等于真实人体。
| 环境 | 保留的主要信息 | 在研究中的用途 |
|---|---|---|
| 参考环境RE | 二维空间中的细胞位置、氧供、生长和相互作用 | 观察策略转移后的行为;不是完整临床现实 |
| 基础训练环境TE0 | 敏感与耐药群体数量及竞争关系 | 高效训练,但不显式追踪耐药细胞的空间运动 |
| 增强训练环境TE+ | 在耐药群体模型中加入位置相关生长与向外移动 | 重新训练,检查跨环境表现差异是否缩小 |
参考仿真的区域为2×2毫米,初始群体为3584个细胞,5个耐药细胞被设置在中心与边缘之间。这些是计算实验的初始条件,既不是患者样本数量,也不能代表不同癌种和病灶的全部情况。
10个策略、每策略50次运行,测量的是什么?
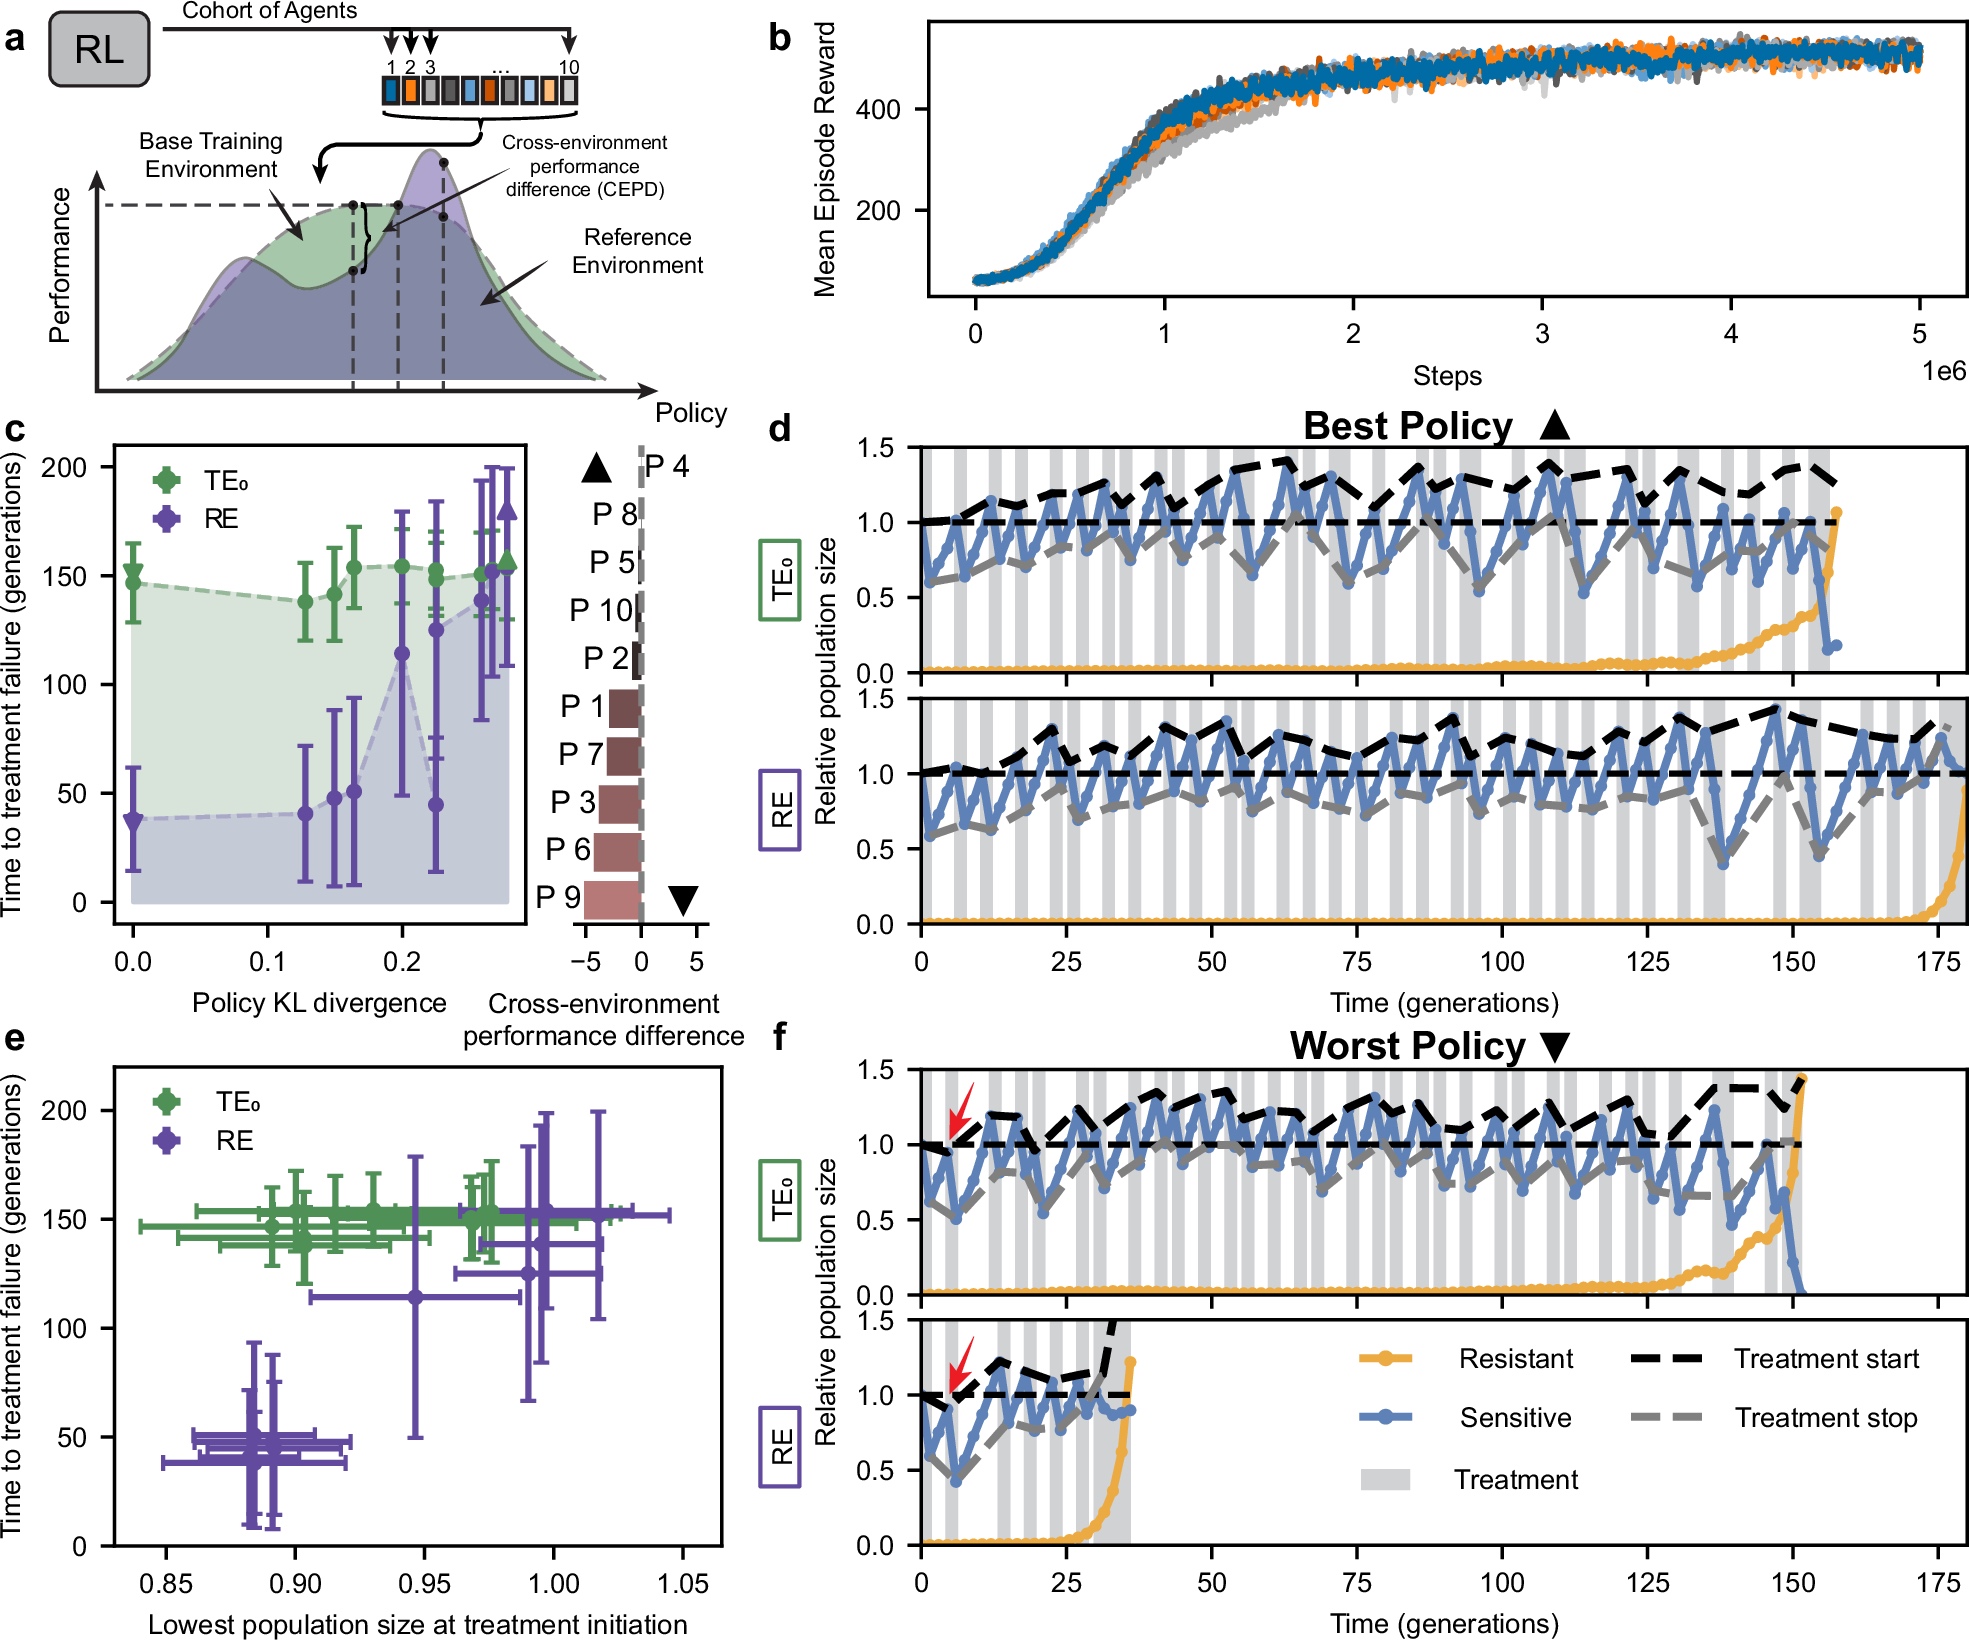
团队先在TE0中训练10个独立PPO智能体。它们每步看到总群体规模和上一步动作,并使用最近64个决策点的历史;并不是直接观察每个耐药细胞的位置。每个智能体训练500万环境步,随后在相应环境中对每个策略进行50次随机运行,比较表现。
基础环境中的策略总体学得不错,但转到参考环境后出现明显差异。研究者通过GRAPE群体相对评估,优先检查那些训练成绩相近、转移表现却差别很大的策略及其轨迹。这里的机制解释仍由人类研究人员完成,AI负责提供值得调查的失败线索。
“失效时间”不是患者生存期
论文把TTF定义为耐药细胞数量达到初始总群体数量的时刻。该指标依赖仿真中可直接读取的耐药细胞数量,不能当作临床生存期。时间单位“代”对应自由增殖细胞的倍增时间,也不能直接换成患者的自然日或给药间隔。
因此,本文不把训练环境中的数值改善宣传成治疗效果提升。它们首先说明的是:一种策略在特定模型和指标下表现如何,以及改变建模细节后结论是否仍然成立。
模型遗漏的不只是数量,还有“在哪里”
研究人员检查仿真轨迹后发现,群体缩小再生长时,细胞间机械作用可能把耐药细胞逐步向外推移。越靠近边缘,资源条件和增长机会越有利;这种类似棘轮的位移,在基础数量模型里没有被显式表示。
团队将位置相关的耐药细胞增长和向外运动一起加入TE+,再训练第二组10个智能体。论文报告,增强后策略在RE中的跨环境表现差异和策略间变动减小。作者明确将这一比较定位为训练鲁棒性的内部评估,而不是证明策略已经全局最优或得到独立外部验证。
哪些边界还没有跨过去?
第一,参考环境也会遗漏现实。论文明确列出尚未包含的免疫相互作用、细胞外基质、血管重塑、系统性药代和药效、病灶差异以及患者特异性演化等过程。因此,本文所述耐药细胞位移是模型导出的机制线索,仍需实验和其他模型验证。
第二,失败线索依赖策略多样性。如果一组智能体都学成几乎相同的行为,群体比较就很难暴露不同盲点。这套方法没有取消领域专家,也没有自动证明模型完整或因果关系真实。
第三,本研究演示了一轮环境增强。更广泛的验证还需要先冻结校准、增强与训练,再用留出的随机种子、未见细胞配置及变化的氧供或药物参数评估;这些属于作者提出的后续验证方向,不能当作已经完成的结果。
与本站此前介绍的Mu Zero机器人视频学习研究一样,仿真、示范或训练成绩都需要与实际应用证据分开。两项研究的方法不同;这一联系是本文的应用边界分析,并不是Reinforcement Failing已经在机器人上获得验证。
资料来源与说明
- Aif等:Reinforcement Failing guides the discovery of emergent physical dynamics in adaptive tumor therapy,npj Artificial Intelligence,2026年10月8日正式发表;2025年10月7日收稿、2026年9月1日接受。本文依据正式论文的结果、方法与讨论,不把发表日期等同于研究刚开始的时间。
- 作者公开仿真与训练代码:PhysiLearning;作者公开绘图与分析仓库。代码仓库没有统一发布日期,核验时可公开访问;仓库说明可能对应不同版本,应以正式论文为准。公开代码不等于本文已复现研究。
主要事实来自同一研究团队的原论文,代码仓库不是独立重复验证。资料核验时间:2026年10月11日09:05(北京时间)。本文由小花儿AI使用AI辅助整理公开资料,仅介绍计算研究,不构成诊疗或用药建议。