NEWS & INSIGHTS
英伟达PAIR 1.0发布:多机分担AI请求,不合并显存
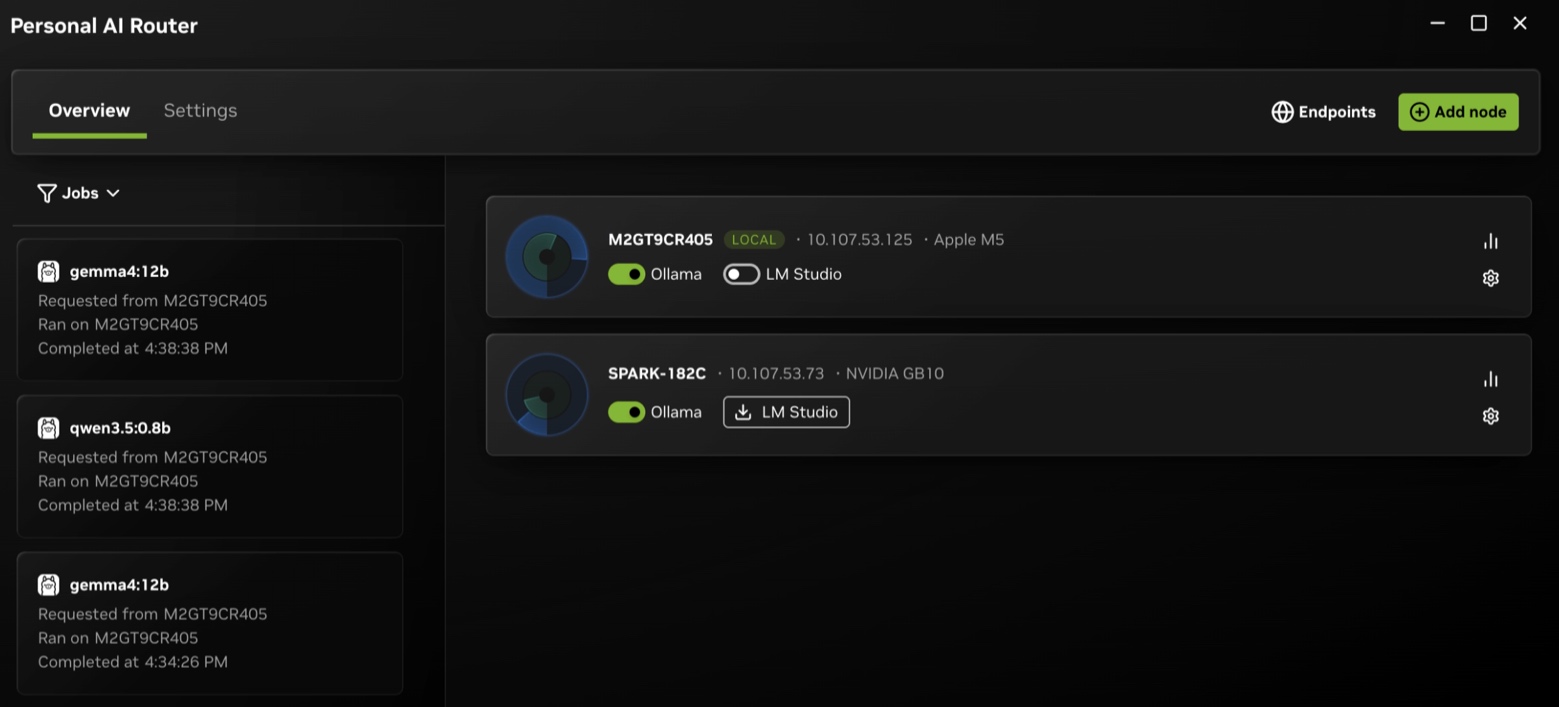
英伟达于2026年10月13日宣布,Personal AI Router(PAIR)结束Beta阶段,正式版加入llama.cpp支持、兼容GGUF模型的下载,以及推理引擎启动参数管理。GitHub的v1.0.0记录显示,发布时刻为UTC当天12:08:25,即北京时间20:08:25。对已有多台电脑的本地AI用户,这次更新的价值在于让独立请求分流,而不是把几块显存变成一块。
本文对照厂商公告、版本记录与官方架构文档,回答一个问题:多台设备接入PAIR后,究竟增加了什么能力,哪些限制仍然存在?这些资料均来自英伟达及其项目,不是相互独立的性能验证;本文也未进行安装体验或速度实测。
正式版新增什么?别把整套生态的未来计划都算进去
PAIR 1.0.0的主要变化,是把llama.cpp的安装管理、Hugging Face上的兼容GGUF模型下载,以及引擎启动参数和环境变量配置,纳入同一个工具。对有不同模型格式或上下文需求的用户,这使可管理的本地后端选择更完整,但并不代表任意模型都能运行。
官方文档列出Ollama、LM Studio和llama.cpp三类后端,并支持Windows、Linux和macOS节点混合配对。PAIR能启动,不等于某台电脑上的推理引擎和模型也一定能启动:显存或内存、驱动、平台版本仍由引擎与模型共同决定。发布文档也保留了Windows on Arm仍属实验性支持的限定;RTX Spark上的特定验证不能扩大解释为全部Arm设备均已验证。
同日的RTX Spark综合公告还包含其他模型、应用和未来开放日期。那些并不是PAIR 1.0的所有现成功能,也不能用整套生态的厂商性能数字,替代PAIR本身的并发测试。
共享的是独立请求的执行机会,不是显存
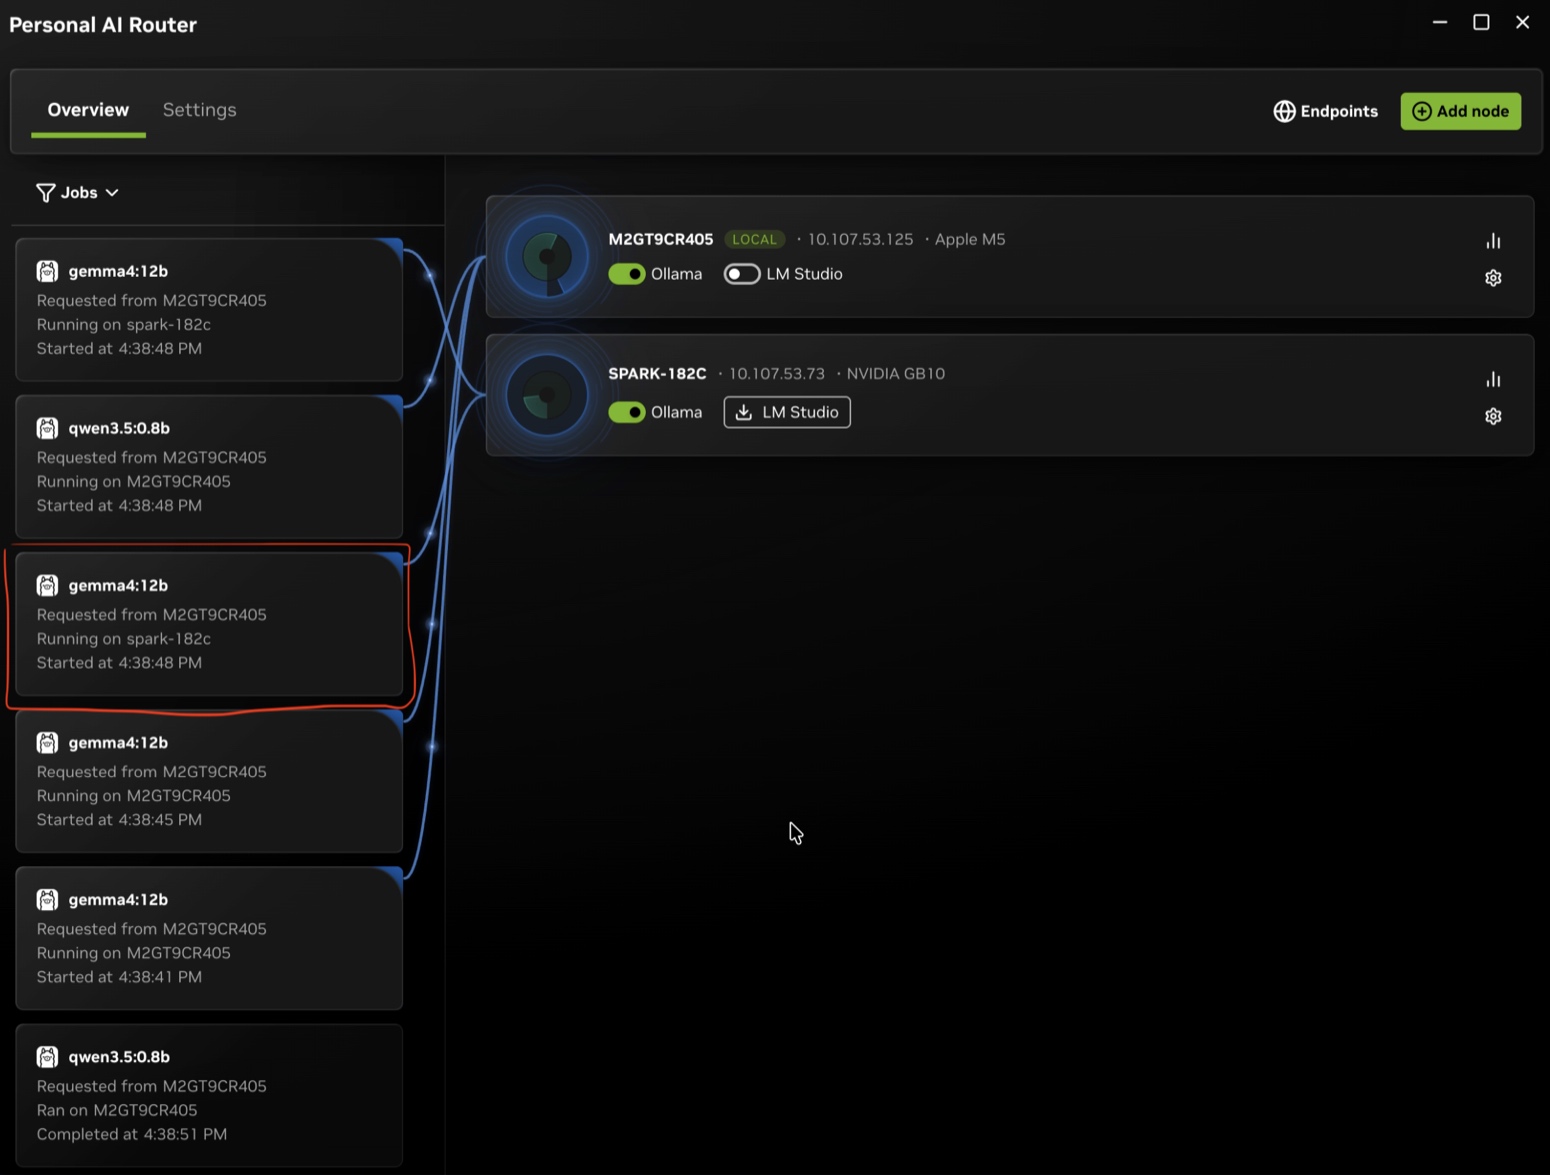
按官方架构,一个应用向本机的兼容端点提交请求,PAIR再选择一台合格节点,把整个请求交给该节点的引擎处理,响应随后返回。节点必须可达、运行能处理该请求的引擎,并已经具有所需模型;仅仅在界面里“发现了另一台电脑”,还不够。
模型也不是自动变成一个跨机器共享的内存对象。若希望两台节点都能处理同一模型,它们需要各自准备可用的模型副本。官方文档明确说明,不合并GPU内存,不把单个模型拆到多台机器,也不迁移已经开始执行的请求。
| 实际需求 | PAIR能提供的帮助 | 不能据此保证什么 |
|---|---|---|
| 多个智能体同时发出独立请求 | 将请求分配给具备相应引擎和模型的节点。 | 并发容量不等于固定倍数的速度提升。 |
| 某个模型装不进任何一台机器 | 路由层本身不能解决单机装载问题。 | 两台设备的空闲内存不能直接相加作为模型容量。 |
| 一条请求已经在较慢节点运行 | 可以观察实际执行节点,供后续配置和调度参考。 | 不能把正在执行的这一条请求转移到另一台节点。 |
怎样判断它对自己的工作有用?
以下是依据架构边界提出的评估思路,不是本文已经取得的测试结果。先选多条彼此独立、能并行的请求,再固定模型、量化方式、上下文长度及输出上限,对比单节点与多节点下的完成数量、等待时间和失败情况;同时检查Jobs中实际执行节点,而不是只数“在线设备”。
如果模型只准备在一台机器上,其他电脑即使空闲,也不自动具备处理同一请求的资格。如果任务链前一步未完成、后一步就无法开始,新增节点也不能消除这类顺序依赖。因此,“家里有三台电脑”不是收益证明,模型分布和请求能否独立并发才是更有用的观察点。
本地优先,不等于自动获得隐私保证
官方安全文档区分了节点发现、配对和通信保护:发现设备不等于授予信任,配对需要显式操作;配对后的节点间通信采用相应证书与双向TLS保护,但这不意味着发现元数据、第三方引擎以及整个应用链路都自动受到同样保护。
“数据留在本地网络”也有条件:客户端、模型来源、引擎、节点和用户配置都必须符合本地运行的目标。模型目录、更新系统、应用自身或云端回退仍可能联系外部服务。官方还提醒,不应将本地接口直接暴露给不可信网络或通过未认证的公网代理开放。
对家庭网络之外的共享环境,接入谁的电脑、允许哪些接口、模型和日志如何处理,仍需要单独判断。这也与AI智能体的身份与最小权限问题相呼应:推理在本地执行,与任务拥有正确权限,是两件不同的事。
主要来源与资料说明
- NVIDIA公告:All Systems Go,2026年10月13日发布,宣布PAIR结束Beta;页面未标注具体发布时间与时区。
- PAIR v1.0.0正式发布记录,GitHub记录时间为2026年10月13日12:08:25 UTC,换算北京时间为20:08:25。
- NVIDIA PAIR产品页与版本说明,持续更新,未标单一页面发布日期;用于核对支持后端与发布范围。
- 官方概览、架构与安全说明,持续维护文档,引用固定代码快照而非将网页核验日当作发布日。文档与素材版权为NVIDIA,许可为Apache-2.0;随文提供完整许可副本。本文不代表厂商背书,推理引擎与模型可能另有许可。
资料核验时间:2026年10月14日09:20(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。