NEWS & INSIGHTS
ARC机器人研究:如何让推理真正影响动作?
北京时间2026年10月9日公开的一篇ARC机器人研究预印本,尝试在不新增机器人示范轨迹的前提下,让现有模型更好地完成操作任务。它的关键不是给机器人加一段更长的解释,而是让“下一步为什么这样做、要改变什么”成为动作预测的输入。对机器人开发者而言,这提供了复用已有示范数据的一条路线,但并不意味着免训练或可以直接上岗。
论文题为《ARC: A Reasoning Recipe for Robot Foundation Models》,arXiv首版提交时间为10月8日17:38 UTC,即北京时间10月9日01:38。以下结果均来自作者论文与项目页,属于同一研究团队的自报实验;尚不能视作独立复现或商业部署验证。
不添新示范,不等于不需要微调
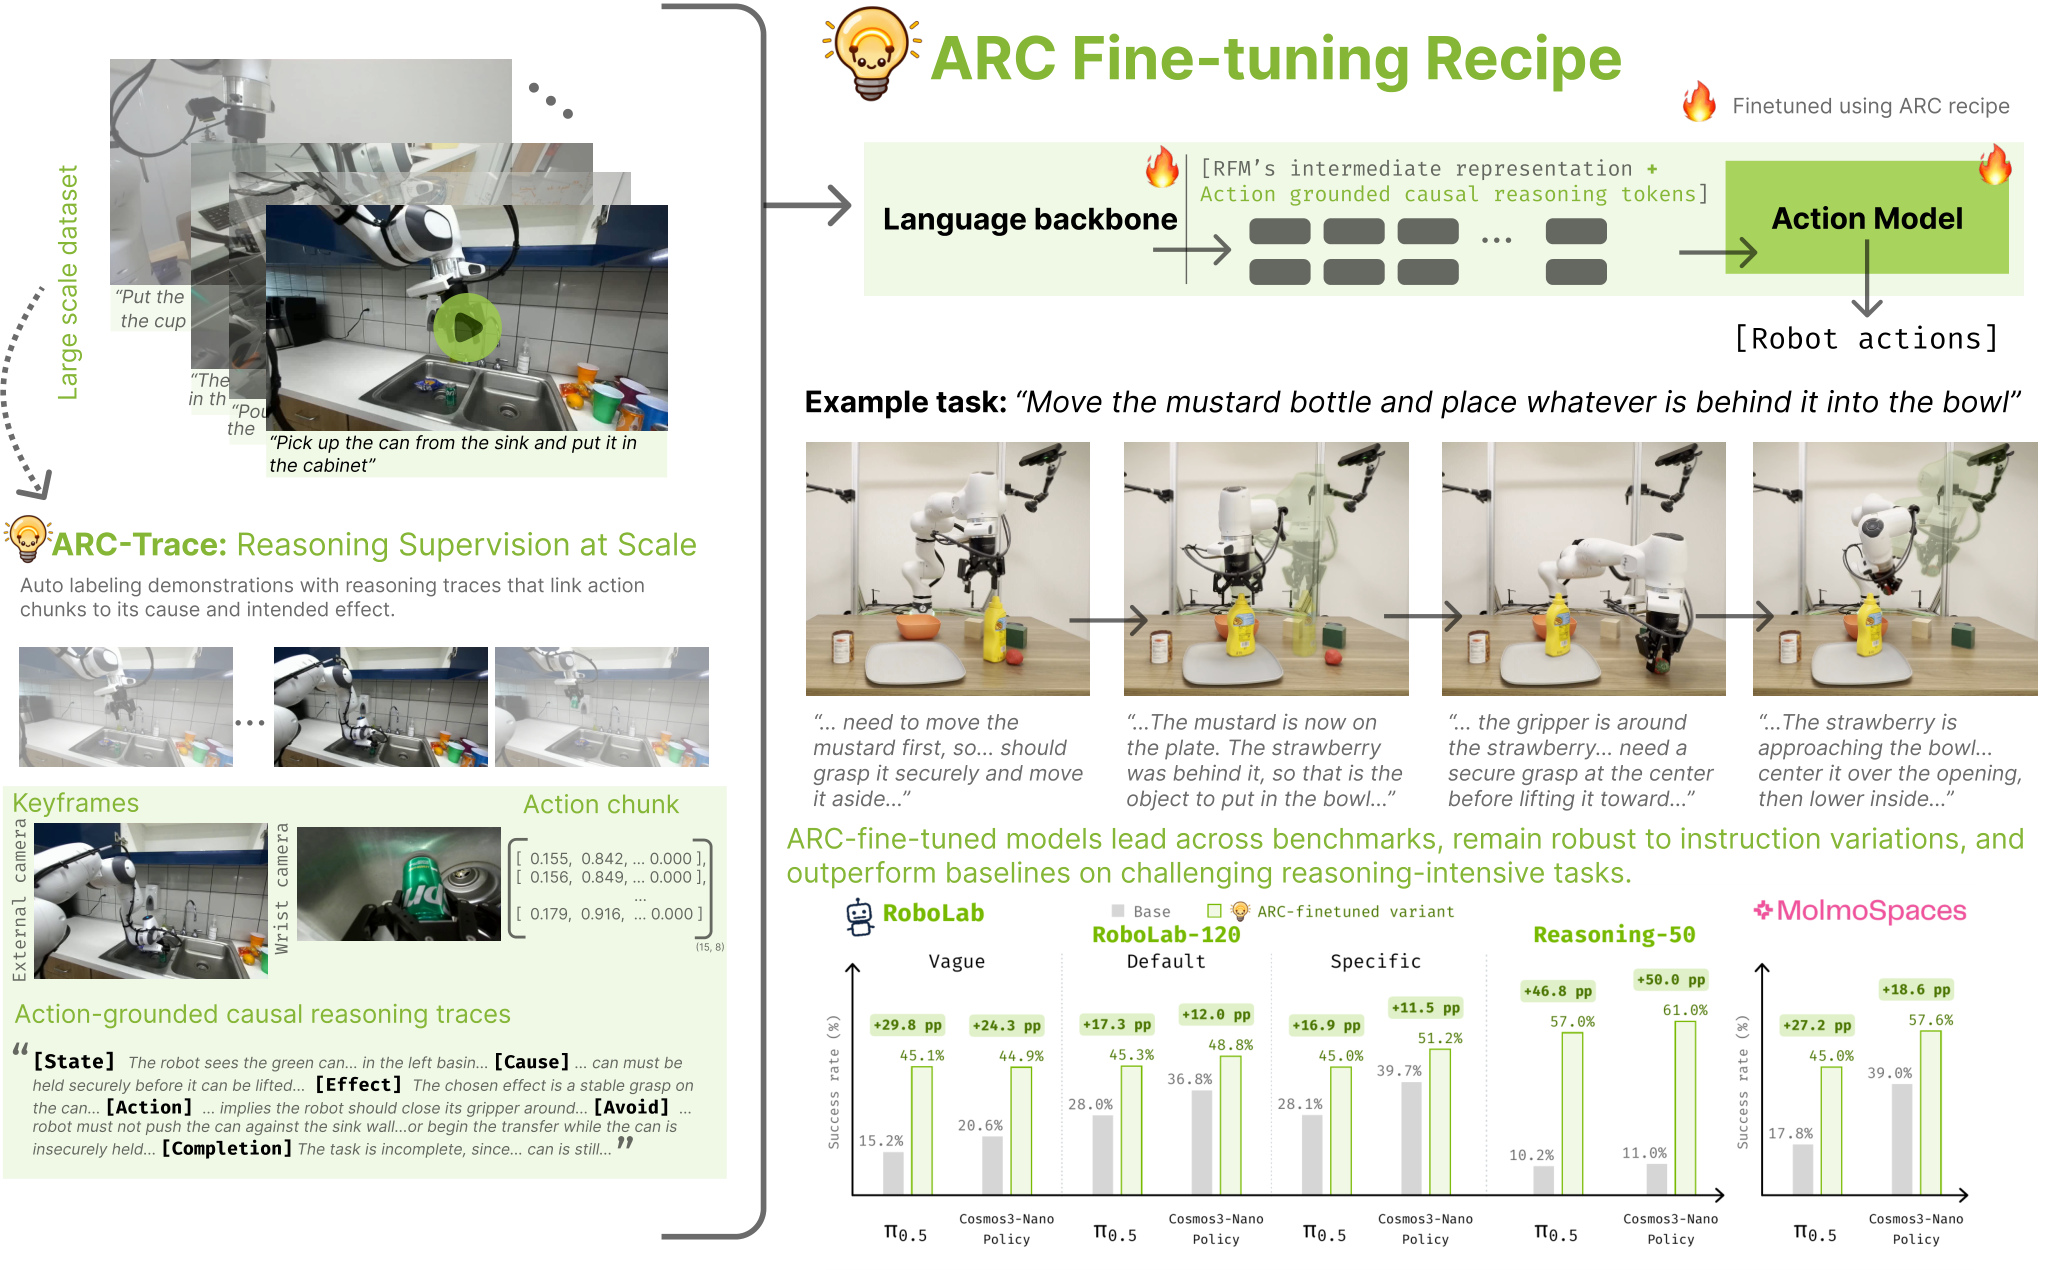
普通机器人示范记录了相机看见什么、机械臂怎样移动,却往往没有说明动作背后的判断。ARC先为已有DROID数据补上与动作片段对齐的自然语言标注,再用这些标注、图像和任务指令微调预训练策略。作者把这套流程用于视觉语言动作模型π0.5,以及世界动作模型Cosmos3-Nano-Policy。
标注围绕当前状态、原因、可能后果、预期效果、动作、应避免的变化和完成状态组织。例如,“先移开遮挡物,是为了看清并抓取后面的目标”,比单独写“移动瓶子”多交代了一层与下一步动作相关的关系。这是对方法的说明性转述,不是新做的实验。
到了执行时,外部视觉语言模型仍要根据当前相机画面生成推理,微调后的策略再把它转成连续动作。这里的“零样本评估”指没有针对测试基准再训练,而不是整个系统从未训练。论文报告标注约7.5万段既有示范、约120万帧;节省的是新增机器人轨迹采集,不是标注计算、微调和推理的全部成本。
同一套方法,三个数字对应不同测试
下表摘取论文中的成功率。增量以“百分点”表示,不能写成同等幅度的百分比增长,也不能把不同测试集的数字混在一起比较。
| 测试条件 | 策略 | 原始→ARC微调后 | 增量 |
|---|---|---|---|
| RoboLab-120仿真,默认指令 | π0.5 | 28.0%→45.3% | 17.3个百分点 |
| RoboLab-120仿真,默认指令 | Cosmos3-Nano-Policy | 36.8%→48.8% | 12.0个百分点 |
| RoboLab-Reasoning-Hardware实机任务集 | π0.5 | 9.5%→91.7% | 82.2个百分点 |
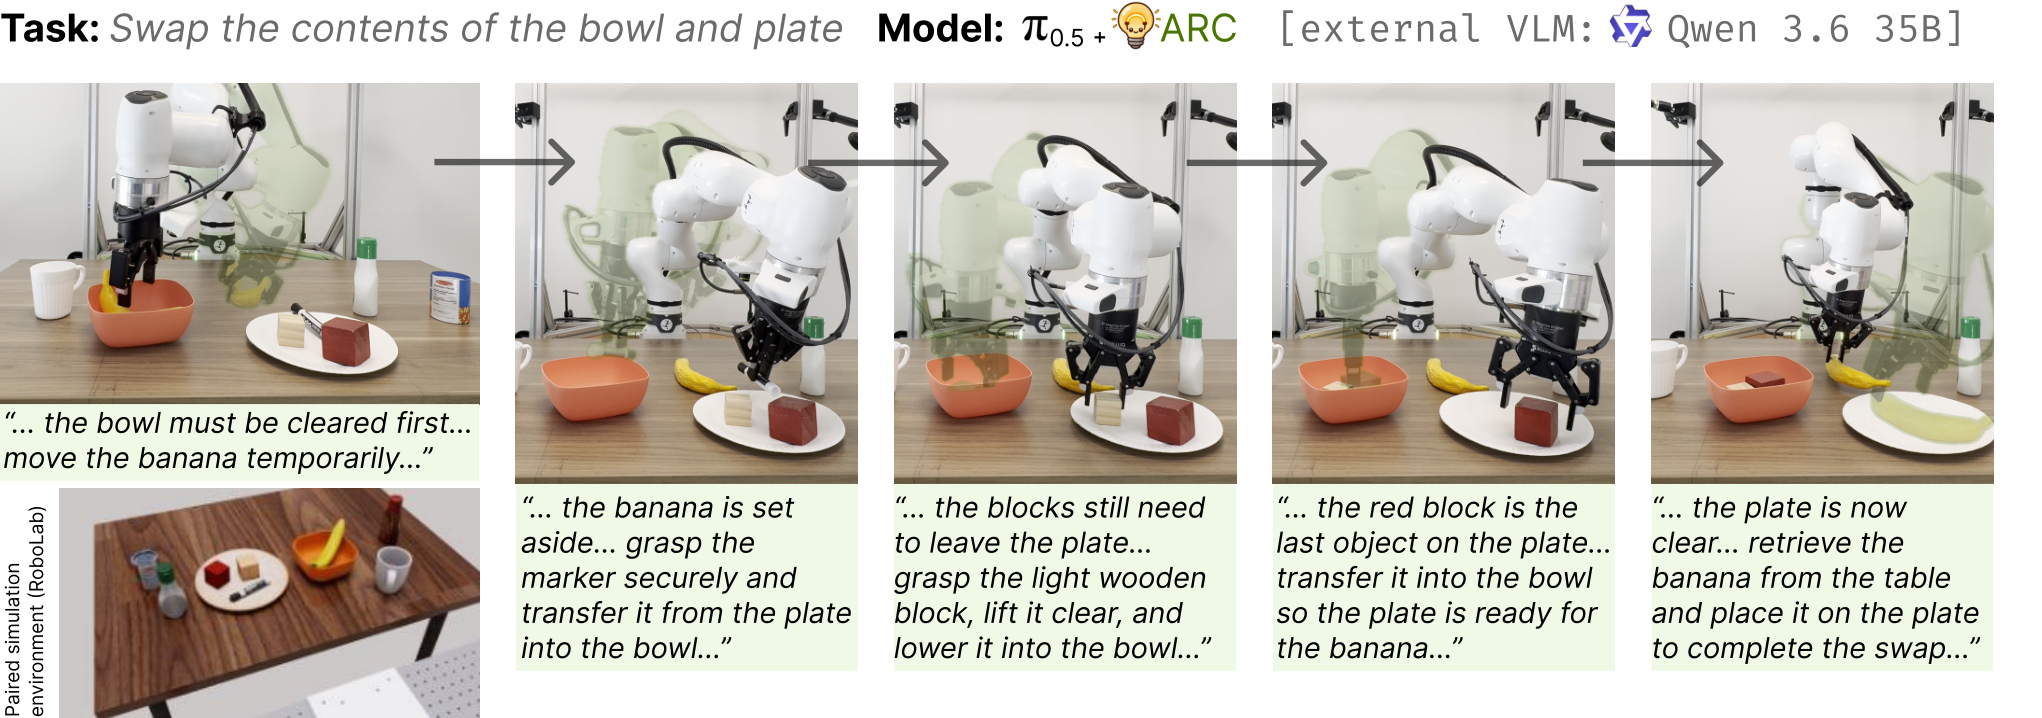
仿真RoboLab-120包含120项任务,每种指令设置下,每个模型测试1200轮。实机部分则是在DROID机械臂配置上复现28项推理任务,每项测试3轮;按这份设计计算,每种策略为84轮。实机使用与仿真相同的检查点,没有额外做针对该硬件的微调。
因此,91.7%是这组特定实机任务的完成率,不是机器人在任意家庭、任意物品上的通用成功率。作者自建的推理任务集覆盖目标推断、多步操作、探索和排除条件;它能支持研究中的比较,却不能单凭一个汇总值证明所有真实场景都同样受益。
推理和控制异步运行,收益也有代价
论文示例中,机器人控制为15赫兹,推理刷新约为1赫兹,两者不是同一个频率。后台更新对场景的解释,动作策略继续使用最近一次通过格式检查的推理;这减少了逐步等待,却带来另一种风险:场景已经改变,动作仍依据旧判断。
作者在局限部分还指出,遮挡可能让系统把尚未完成的抓取误认为已经完成;错误推理也可能被更紧密的动作条件化放大。注意力分析能提供诊断线索,但不能单独证明机器人已经获得可靠的因果理解。外部推理增加的算力、显存和延迟,也不会因为动作生成步数减少就自动消失。
基于这些条件,采用者更值得补测的是:相机遮挡或物体移动后,推理多久更新;错误完成判断如何被纠正;把外部模型成本计入后,任务收益是否仍成立。这是由论文限制推导的应用核查方向,而非作者已经证明的结果。与此前Mu Zero视频学习研究关注的动作示范问题相比,ARC聚焦的是给既有示范补上推理并训练策略使用它,两者的训练输入和所解决的问题不同。
资料来源与核验说明
- ARC预印本记录及许可,首版提交:2026年10月8日17:38:04 UTC,北京时间10月9日01:38:04。
- ARC论文全文,版本同上;主要核对第4、5节、附录B.3、C和F,分别对应方法、成绩、异步执行、测试条件及限制。
- 作者项目页,页面未注明独立发布日期;核验时仍标注代码、模型及数据待审稿期后发布,不能把有演示页面写成已经全部开源可复现。
资料核验时间:2026年10月23日09:08(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。