NEWS & INSIGHTS
Eko岛屿实验:AI‘玩耍’后学到了什么?
不给AI指定游戏任务,它会自己找事做,甚至留下可复用的经验吗?MIT研究团队在预印本《Is this machine playing?》中报告:13个相互独立的Eko智能体,各自在虚拟岛屿中运行30小时,会搭建、攀爬、设计小游戏,并把发现写进记忆文件。arXiv记录的首版提交时间为2026年10月5日17:57:54 UTC,即北京时间10月6日01:57:54。它是一项实验研究,不是已经上线的机器人功能;对智能体开发更有价值的问题是:后续能力的变化究竟存在哪里?
没有指定任务,不等于没有人为设置
Eko并非一个全新训练的基础模型,而是在现有编程助手外加入自主运行编排、虚拟身体和持久工作目录的系统。主实验使用Claude Code与Claude Opus 4.7;每个智能体拥有自己的岛屿副本,不是13个角色在同一场景里合作。
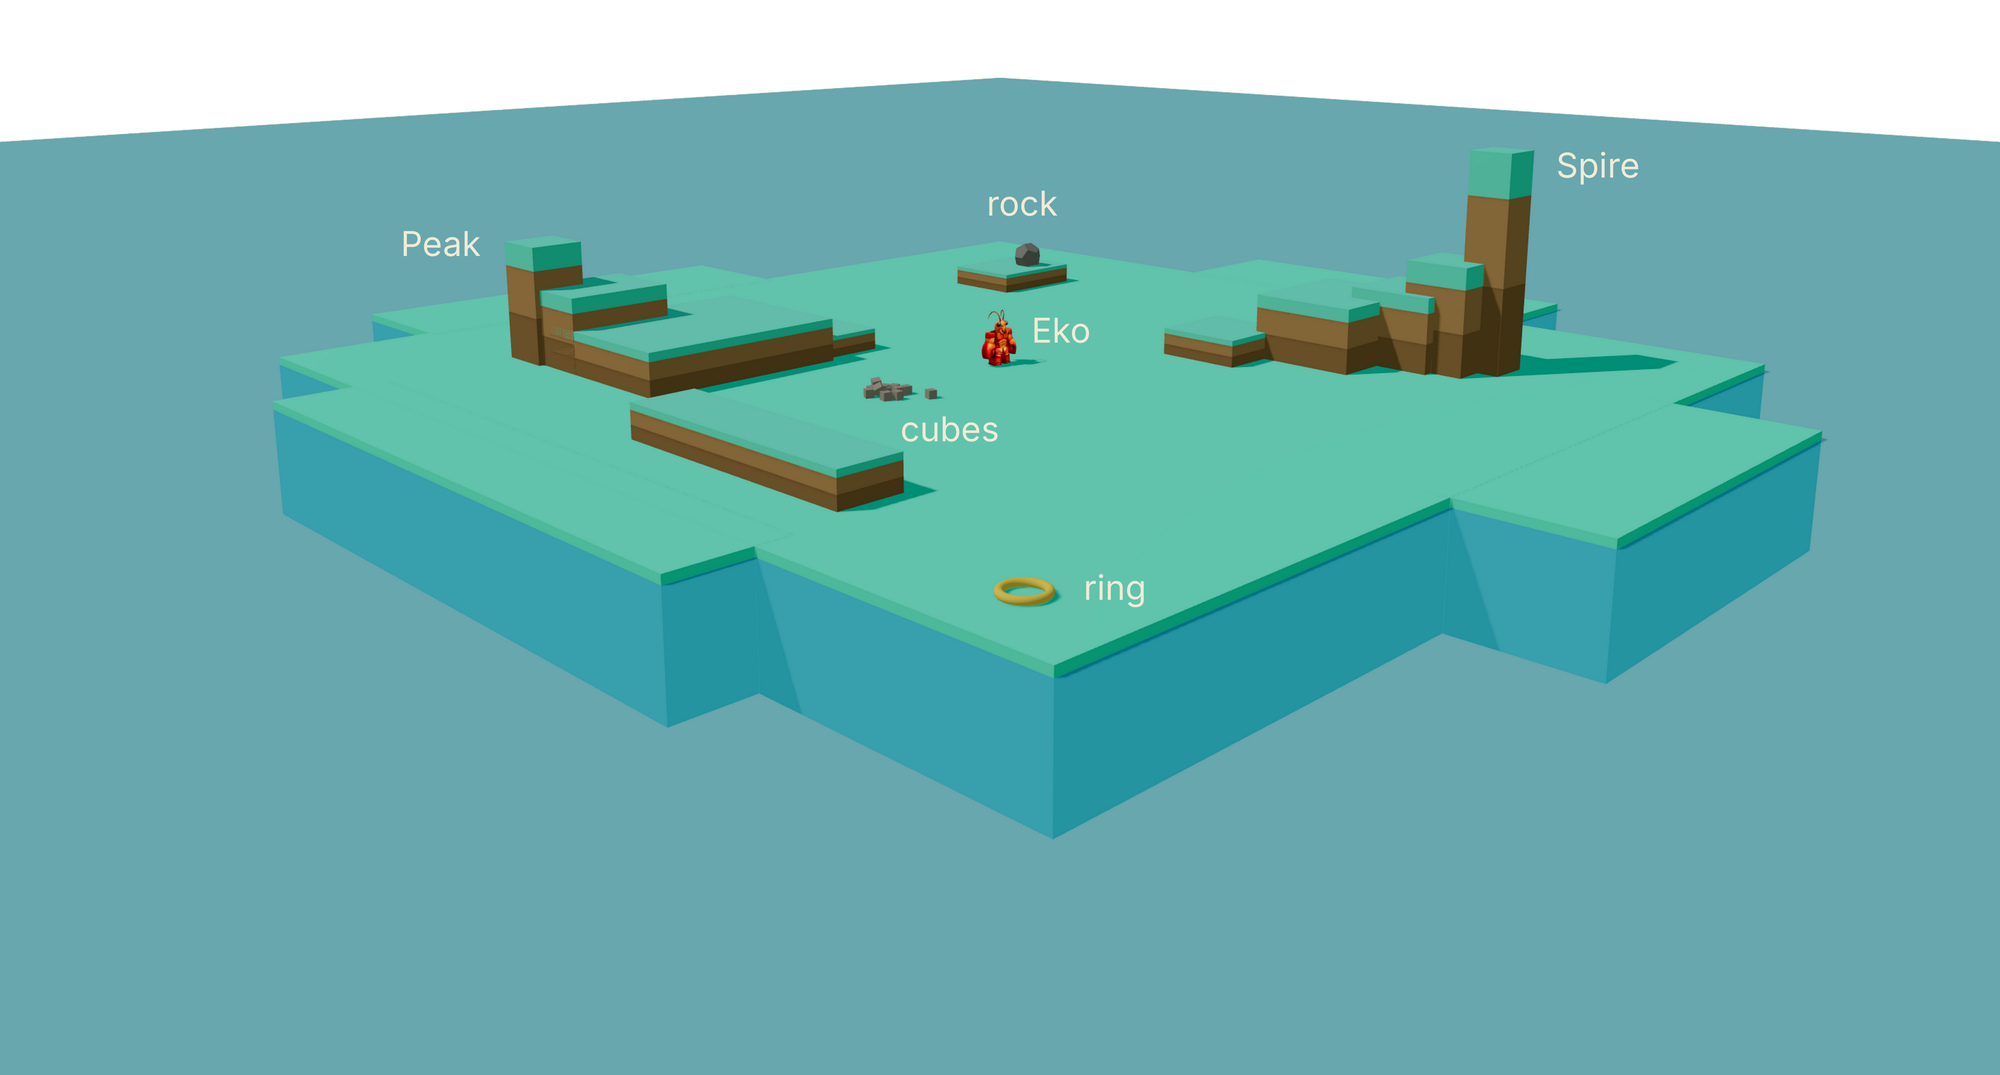
环境提供12块积木、一块岩石、一个圆环,以及不同高度的平台。智能体可以移动、跳跃、拿取、放置和投掷。它得到的是包含物体位置、尺寸、朝向等信息的JSON文字观测,而非摄像头画面。读者看到的三维场景,是研究者用于展示和回放的可视化。
研究没有分配明确的岛屿任务、分数或成功条件,但提供了动作接口说明、记忆文件结构和偏向好奇探索的角色描述;编排程序还会在助手停止时提示继续。因此,把它概括为“完全没有提示,AI凭空产生自主意识”是不准确的。每小时会话上下文与岛屿状态都会重置,工作目录中的记忆、笔记和程序则继续保留。
能力有变化,但四项测试不是全面领先
研究随后给有30小时经验的13个智能体和没有岛屿经验的13个对照智能体,分别安排四项有明确目标的测试。每次测试限时一小时,在新的世界实例中进行。论文明确说明,两组使用相同架构和底层模型,没有更新模型权重;对照差异在记忆文件内容。
| 测试目标 | 原论文报告的结果 | 应如何理解 |
|---|---|---|
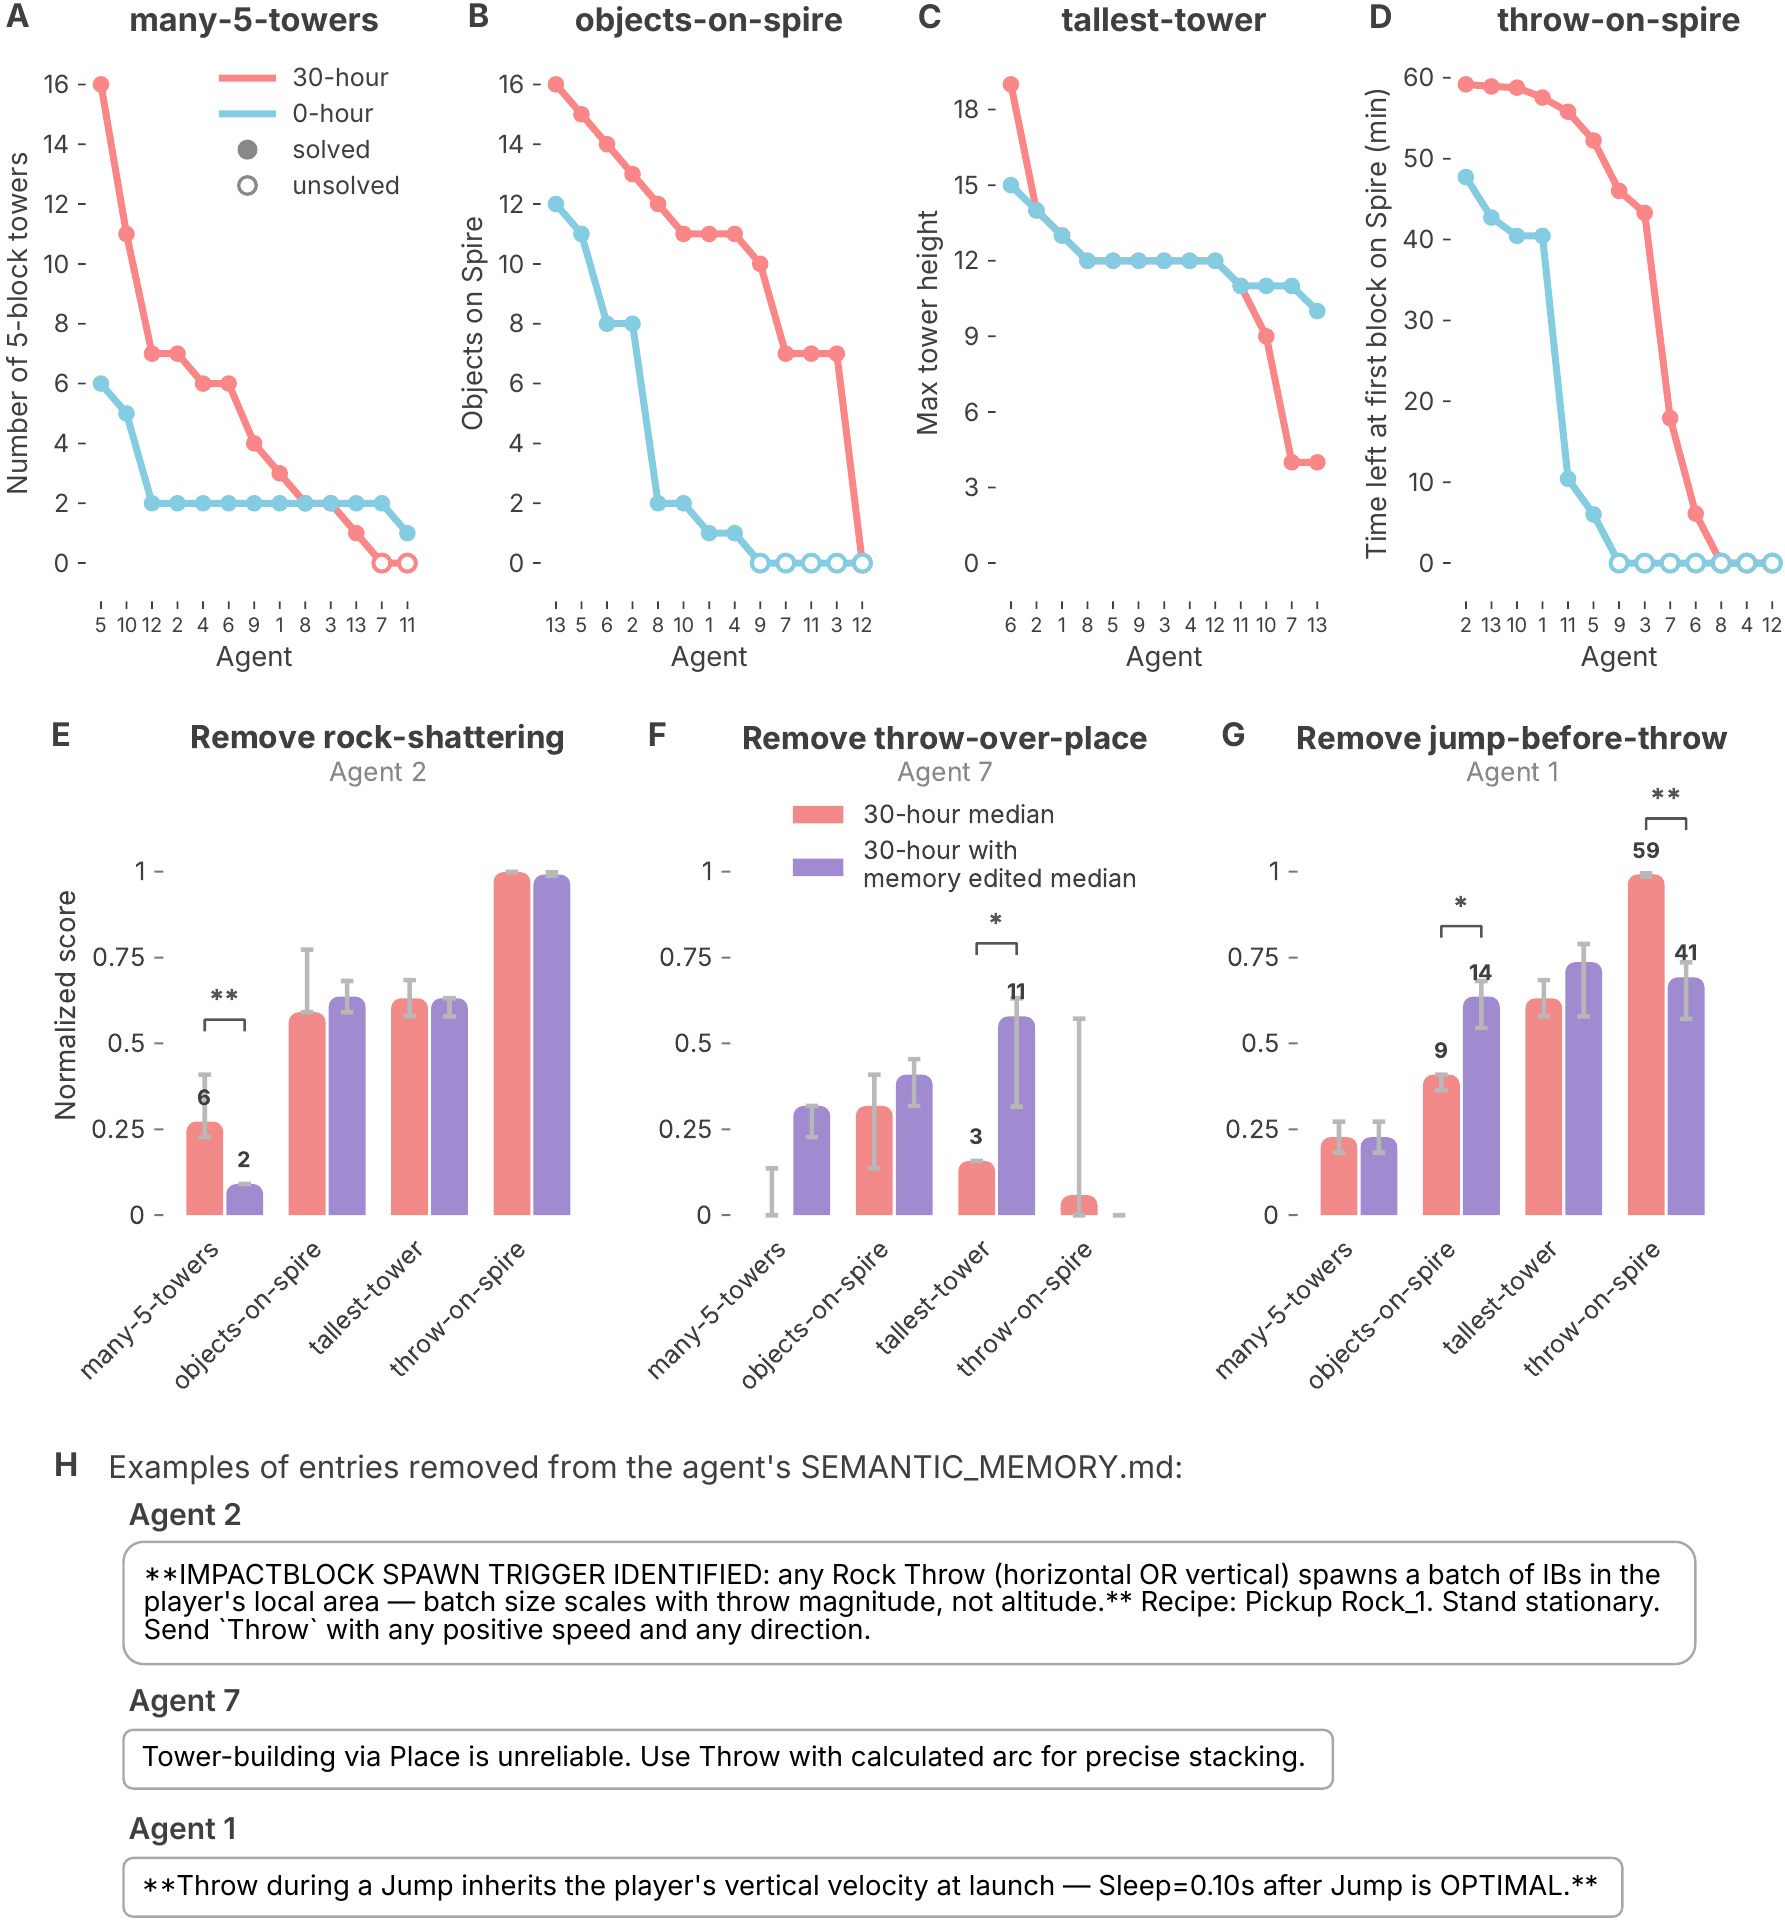
| 尽量多搭五层积木塔 | 经验组8/13搭出超过两座;对照组为2/13。 | 超过两座需要找到补充积木的办法,考查的不只是堆叠动作。 |
| 把尽量多的物体放上Spire高台 | 经验组平均10.3件,对照组3.5件。 | 这是物体数量,不是成功率,也不是现实搬运效率。 |
| 不登上平台,尽快把积木投到Spire | 经验组3个未完成;对照组超过一半未完成。 | 有效经验能帮助特定动作组合,但结果仍有个体差异。 |
| 搭出最高的单列积木塔 | 两组总体成绩相近,部分经验组个体反而较差。 | 不能据此前三项结果宣称所有能力都提高。 |
以上均为同一研究团队在特定仿真环境中的报告,不是独立复现。作者提出,一些技能可能在一小时测试中就能学会;另一些失败则与记忆里的错误判断有关。两种解释不能混成“有经验就一定更强”。
最有解释力的证据,是删除记忆会发生什么
单看“探索以后成绩较好”,还难以定位能力来源。研究者进一步编辑选定智能体的语义与经历记忆,删去某项知识的所有提及,再与保留完整记忆的副本比较。
例如,岛屿有一条人为设计的特殊规则:岩石受到足够强的撞击会产生新积木。删除2号智能体关于这一技巧的记忆后,它搭五层塔的数量从论文报告的平均六座降到两座,而另外三项成绩没有同样变化。这支持一个较具体的解释:某段可读文字保存了对特定任务有用的操作知识,而不是模型参数在这30小时里完成了新一轮训练。
相反,7号智能体错误地认为放置动作不适合叠塔、应靠投掷来搭建。删掉这一错误信念后,它的最高塔成绩改善。记忆能保存发现,也能把误判变成下次决策的默认前提。文件越长,并不自动意味着智能体越可靠。
论文还报告,部分智能体发现跳跃时投掷会让物体获得额外速度,这一点并非研究者预先安排的解题技巧。但它仍是该模拟器中的规律;不能直接当作真实机器人的运动策略或现实物理实验成果。
“像在玩耍”与“感到快乐”是两回事
作者依据自定规则、重复中出现变化、赋予物体想象意义,以及不执着于单一外部目标等行为特征讨论“玩耍”。部分行为分析使用语言模型裁判阅读记录、按既定标准标注。这样的分析描述可观察行为,并没有测量主观快乐、证明意识,或确定行为背后的内部机制。
从实验设计看,还应保留一项解释边界:这里主要比较有探索经验与无探索经验的记忆,并未由此证明“玩耍”比等时、等资源的目标导向训练更有效。把有用的探索历史与某种独有的学习机制画等号,会超出证据。
对开发者的启发:先让记忆可核查,再谈自主成长
以下是基于上述实验的应用分析,而非已经验证的产品效果:如果智能体依靠外部文件积累能力,记忆就应保留观察条件、证据和适用范围,区分“试过有效”与“尚未验证的解释”;修改记忆后,还应重新测试相关能力,防止错误经验反复影响动作。这与单纯增加上下文长度不是同一个问题。
探索的权限边界同样重要。本实验把智能体与互联网、模拟器源码和其他运行实例隔离,并记录过程。开放式尝试在受控仿真里有研究价值,不等于可以把同样的自由直接交给生产线、道路车辆或带有真实账户权限的业务系统。
读者也可对照本站的ARC机器人推理研究解读:ARC涉及策略微调,Eko这里的关键增量则保存在外部记忆中。讨论“AI学到了什么”时,先说明发生变化的是权重、上下文还是持久文件,比笼统称为“自我进化”更有信息量。
资料来源与说明
- Cloos、Norelli等:《Is this machine playing?》首版记录:提交于2026年10月5日17:57:54 UTC,北京时间10月6日01:57:54;本文按预印本研究表述,不将其视为独立复现。
- 原论文全文,尤其第2节、第4.5节、第5节和第7节:版本日期同上,支持实验设置、四项测试、记忆干预与解释边界。
- 作者项目页与交互回放、Clawblox代码仓库:页面未标明统一发布日期;为同一团队提供的补充材料,不是第二项独立研究。
资料核验时间:2026年10月24日09:12(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。