NEWS & INSIGHTS
遥感AI剪枝新研究:实机效率改善,准确率优势尚待验证
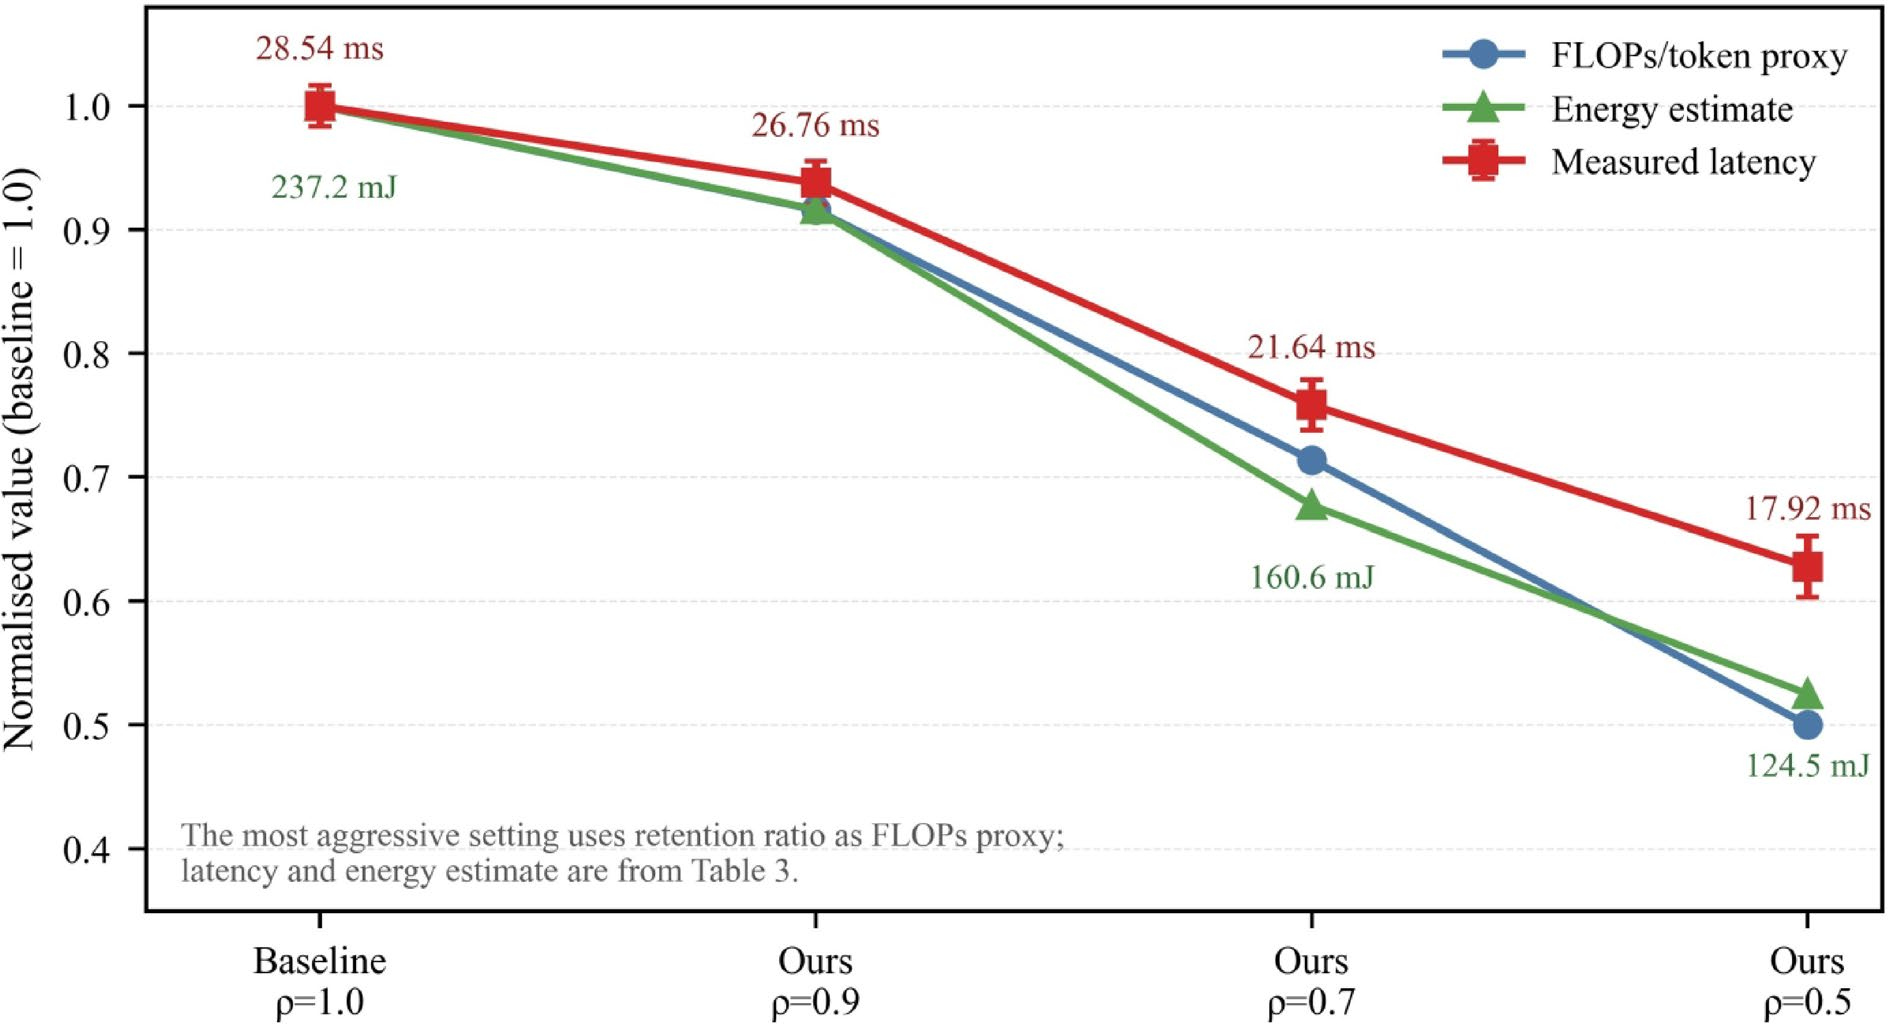
2026年10月27日,《Scientific Reports》提前公开了一项遥感AI研究:研究者尝试让视觉模型少处理一些图块,在一台Jetson Orin Nano上降低推理开销。论文报告,推荐配置相对未剪枝模型的单张延迟下降24.18%,单张能耗估计下降32.27%。不过,这项工作没有证明识别准确率普遍提高。对需要把AI放进算力和供电受限设备的开发者而言,更有用的问题是:这些效率收益是在什么条件下得到的,又付出了什么代价?
模型怎样决定哪些图块可以少算?
视觉Transformer会把图像切分为一串图块,再处理它们之间的关系。这里的“剪枝”是减少后续计算的图块数量。研究没有让设备在每次识别时都执行昂贵的Shapley贡献计算,而是在训练前近似估计贡献排序,再让一个轻量预测模块学习这种排序。运行时按分数保留图块,并结合重新校准的提前退出机制。
这一设计把部分负担移到了离线阶段。因此,端侧推理变省,并不能推导出训练全过程也更节能。作者明确表示,没有记录离线Shapley预处理的GPU小时数和峰值显存。贡献估计本身也采用遮罩近似,尚缺少与真正移除图块的直接对照。
把速度、能耗与准确率放在一起看
论文的主要遥感实验使用DeiT-S模型、NWPU-RESISC45数据集的20%训练协议,以及224×224输入。硬件效率测试采用Jetson Orin Nano、TensorRT和FP16。推荐的ρ=0.7表示在第4、7、10层分别保留当层输入图块的70%,并非整个网络最终固定保留70%。
| 比较项目 | 未剪枝DeiT-S | 论文推荐配置 |
|---|---|---|
| 单张推理延迟 | 28.54±0.47毫秒 | 21.64±0.58毫秒 |
| 单张能耗估计 | 237.18毫焦 | 160.63毫焦 |
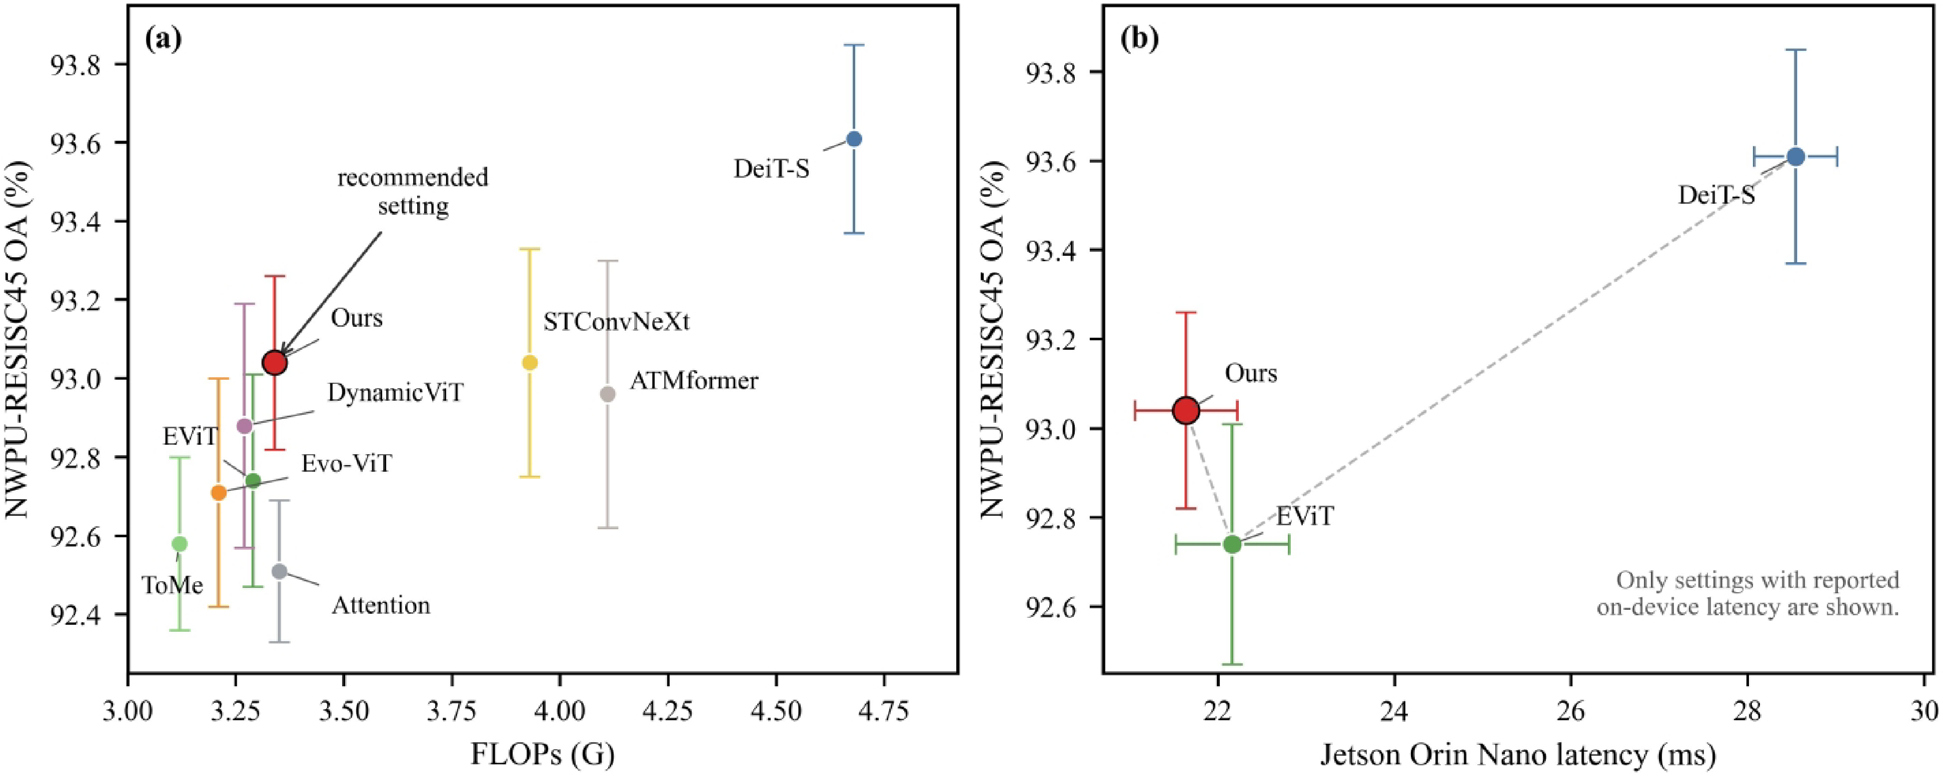
| 遥感场景总体准确率 | 93.61%±0.24% | 93.04%±0.22% |
表中数据来自原论文表2、表3。能耗是平均功率乘以单张延迟得到的估计值,不是对整套设备长期耗电的直接测量。准确率相对未剪枝模型下降0.57个百分点,说明这里存在效率与识别效果的取舍。
为什么还不能说它“更准、更快、更省电”?
与同样ρ=0.7的注意力剪枝相比,新方法的总体准确率高0.53个百分点,但主要比较只有三组配对随机种子,p=0.067,未达到常用的0.05显著性门槛。作者也没有把它作为已确立的准确率提升。与EViT相比,延迟和能耗估计的差距又小得多,论文认为不足以宣称明确优势。
作为本文的应用判断,评估这类方法应分开回答三个问题:能否接受相对完整模型的精度损失;同一设备、精度和编译条件下是否仍有收益;离线训练成本能否被实际调用次数摊薄。这些是由实验条件推导出的评估方向,不是本文已完成的产品测试。单一遥感基准上的分类结果,也不能直接替代目标检测、其他模型或真实在轨任务的验证。
与这一话题相关,还可阅读本站的固定强化学习策略无人机吊载研究,比较另一类AI实验如何界定实机结果与适用范围。
资料来源与说明
- Li, C.、Zhou, T.:Shapley-guided token pruning for real-time remote sensing scene classification on edge devices,Scientific Reports,2026年10月27日提前公开,2026年10月14日接受。网页未提供具体发布时间或时区,不能把接受日期当成发表日期。
- 同一论文的作者PDF,对应2026年10月27日提前公开版本;方法、比较条件、数值和图表据此核对。该版本仍可能在正式编辑过程中更新。
主要证据来自同一项研究,论文网页与PDF不构成两项独立验证;本文未复现实验。资料核验时间:2026年10月28日11:27(北京时间)。
本文由小花儿AI使用AI辅助整理公开资料