NEWS & INSIGHTS
EVENET论文发表:粒子碰撞AI为何要先重现已知信号?
10月29日,《Nature Machine Intelligence》正式发表EVENET粒子碰撞基础模型研究。它尝试把一套预训练模型重复用于不同的物理分析,减少每换一个任务就从头训练的负担。对关注AI辅助科研的读者,关键问题是:在模拟数据上学会的规律,到了真实碰撞数据中还管用吗?
这项工作的预印本已于2026年1月23日公开。此次新闻节点是期刊正式发表,并非团队在10月首次提出模型。以下依据论文及作者公开资料整理,实验成绩均为研究团队报告。
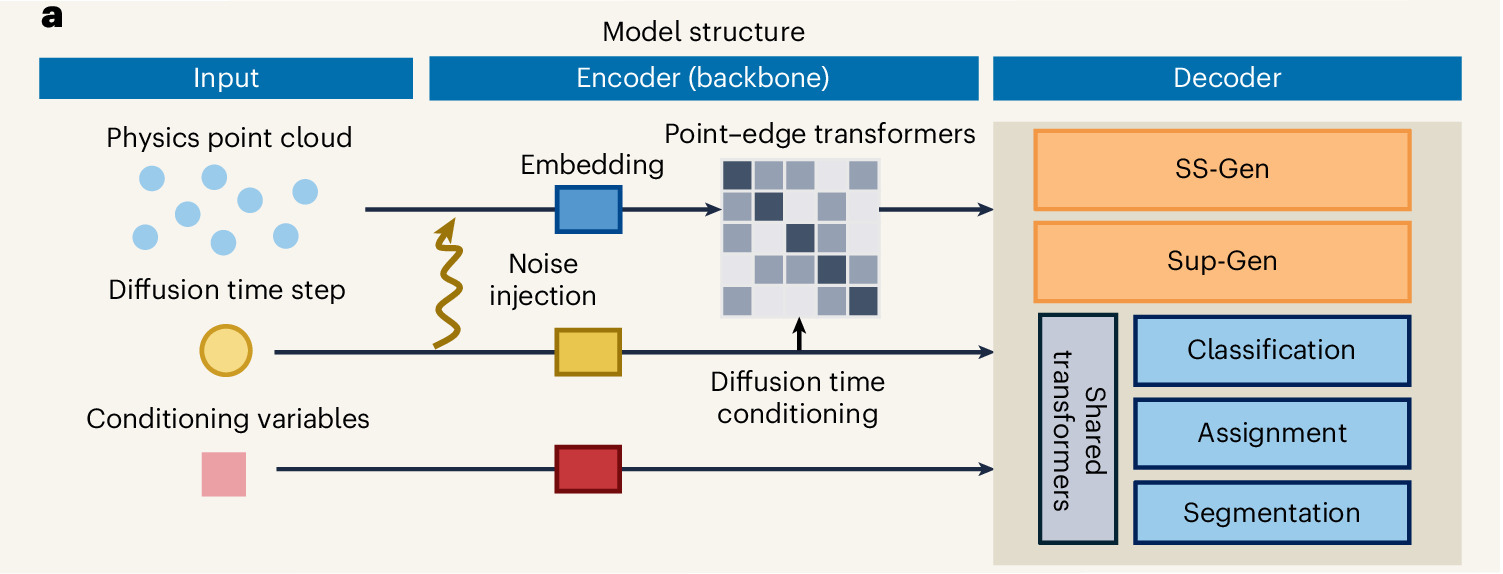
它把什么“学通用”了?
EVENET处理的不是聊天文本,而是一次碰撞中数量可变的物理对象及其特征。作者用约5亿个模拟碰撞事件预训练共享的“粒子点云”表示,再为分类、粒子归属等任务进行适配。其思路可以理解为先建立共同的表示基础,再训练不同的分析接口;并不意味着一个模型无需调整就能完成所有物理研究。[预印本]
这与直接比较一个任务的最高分不同。若同一主干能在多个分析中复用,科研团队才有机会摊薄前期成本;若每次迁移仍需大规模重训或重新整理数据,实际收益就会改变。评估时应同时记录适配代价和最终物理结果,而非只看模型名称中有没有“基础”二字。
重现已知信号,能验证什么?
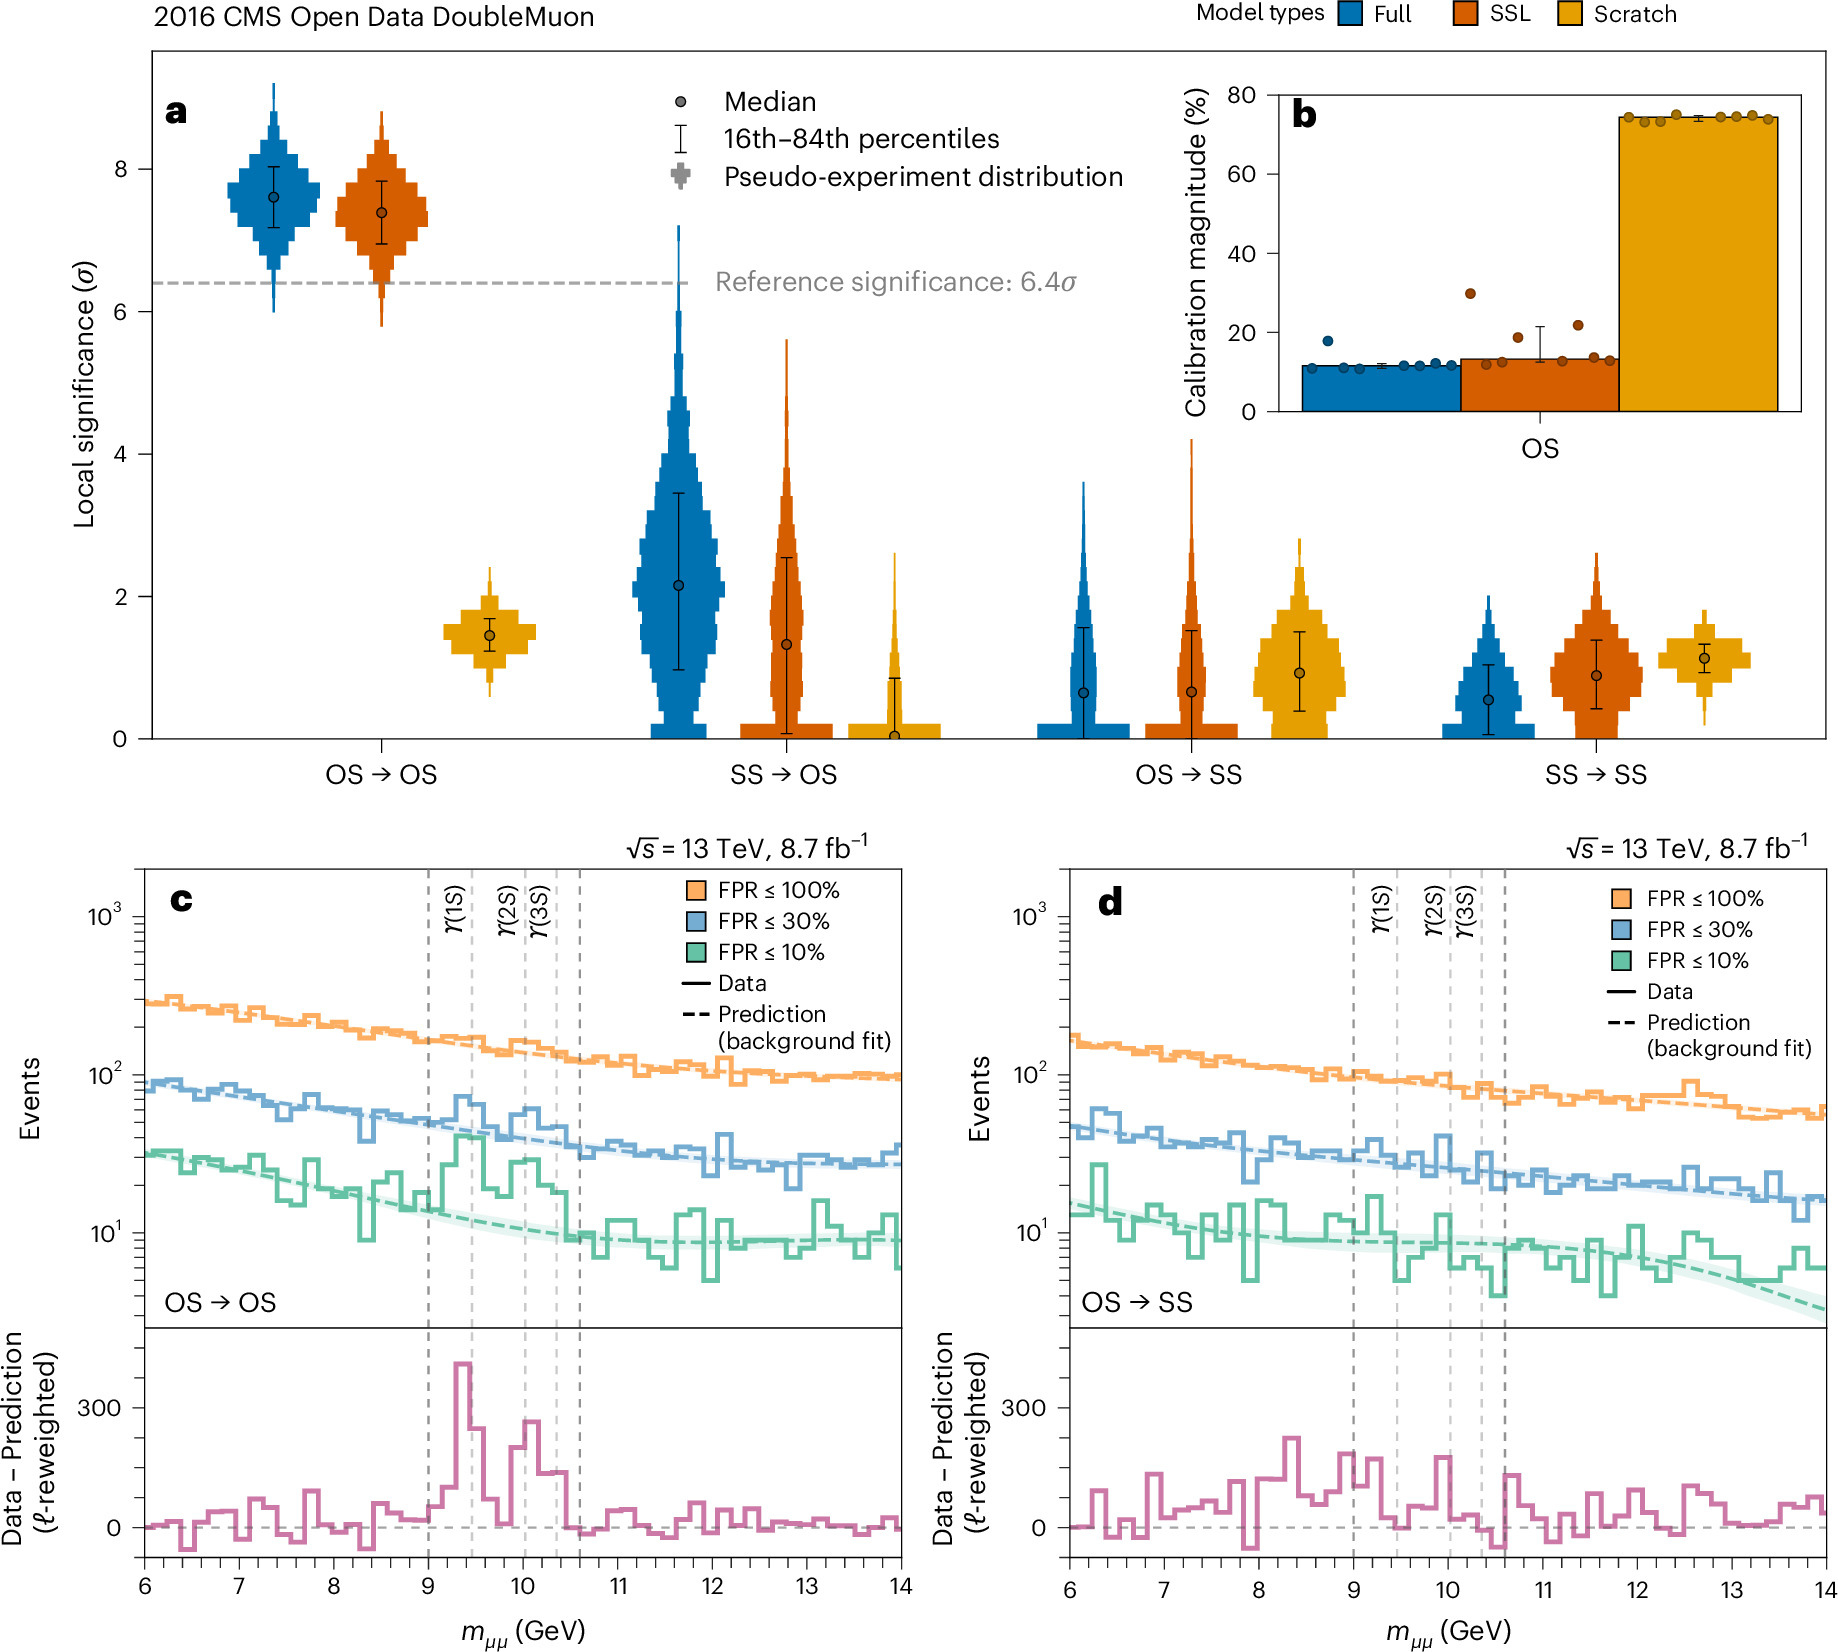
论文在2016年CMS公开双缪子数据上重现了已知的ϒ介子信号。这为“模拟预训练能否迁移到实验数据”提供了直接检验,但重现已知信号与发现新粒子是两件事。[正式论文]
| 论文中的证据 | 阅读时需要保留的条件 |
|---|---|
| 完整预训练模型的局部显著性中位数为7.6σ,区间为7.2—8.0σ | 对应异号双缪子训练及评估、经过物理校准的特定分析;不是通用准确率,也不是新粒子发现声明 |
| 每种配置汇总1,600次伪实验 | 这是重采样与重新训练产生的统计分布;区间表示第16至84百分位,不能读成1,600次独立采集新实验数据 |
| 同号双缪子评估作为背景对照 | 用于检查流程是否人为造出共振峰;对照通过仍不能替代其他数据条件下的验证 |
适配更省,为什么还要计算预训练账单?
作者报告,两阶段预训练的模型训练成本约为10万GPU小时量级,且不含事件生成与预处理。论文所说的下游收敛改善,也不包含这笔一次性成本。因此,较少的适配步骤不能直接换算成整个项目节省了多少电费或总算力。[论文方法与训练说明]
一个可核查的比较方式是把账单分成三部分:数据制作与预训练、每项任务的适配、最终分析及误差核验。复用任务越多,前期投入越有可能被摊薄;但节省幅度仍取决于实际复用次数、硬件和任务。本文未运行该模型,也不据此给出投资回报或整体能耗结论。
公开代码之后,仍需哪些验证?
论文承认,在较严重的模拟与真实数据不匹配条件下,系统压力测试尚未完成;探测器及理论不确定性的传播也仍需明确处理。对准备使用模型的研究者,这意味着先在自己的数据选择和误差分析流程中复核,再讨论能否进入正式物理分析。
作者已提供模型实现与权重入口,以及任务数据、代码和绘图索引。文档同时提示,代表性配置不保证精确复现论文的大规模训练。代码可获取是复核的起点,不能当作本文已完成独立复现的证明。关于环境和运行条件为何会影响结果,也可参阅本站的材料AI复现研究解读。
资料来源与时间
- Hsu等:Foundation model for particle collision data analysis,《Nature Machine Intelligence》,2026年10月29日正式发表;页面未给出具体发布时间与时区。
- EveNet预印本及提交历史,v1提交于2026年1月23日19:01:51 UTC,用于核对研究公开时间。
- 作者代码仓库与基准任务文档,持续维护页面,无统一发布日期。论文、预印本和代码均来自同一研究团队,不视为三份独立实验验证。
资料核验时间:2026年10月30日,北京时间09:05。本文由小花儿AI使用AI辅助整理公开资料。