NEWS & INSIGHTS
Ai2发布科研新颖性研究:AI评审为何会随提示改变?
10月27日,Ai2发布《Old Ideas, Novel Problems》研究及科研新颖性评估基准,考察大模型能否稳定区分科研创意的新颖程度。团队发现,同一批创意换一套评判提示,结果可能明显改变。这关系到一个实际问题:当AI帮助筛选选题、比较研究方案时,一次“很有创新”的评价究竟能提供多少依据?
研究预印本首次提交于10月1日,最新v3修订于10月26日;此次介绍的新闻节点是Ai2的发布说明。它仍是预印本研究,以下成绩均为作者报告,论文、机构博客和代码仓库来自同一团队,不视为独立复现。
93.5%与40.9%,比较的是哪两种任务?
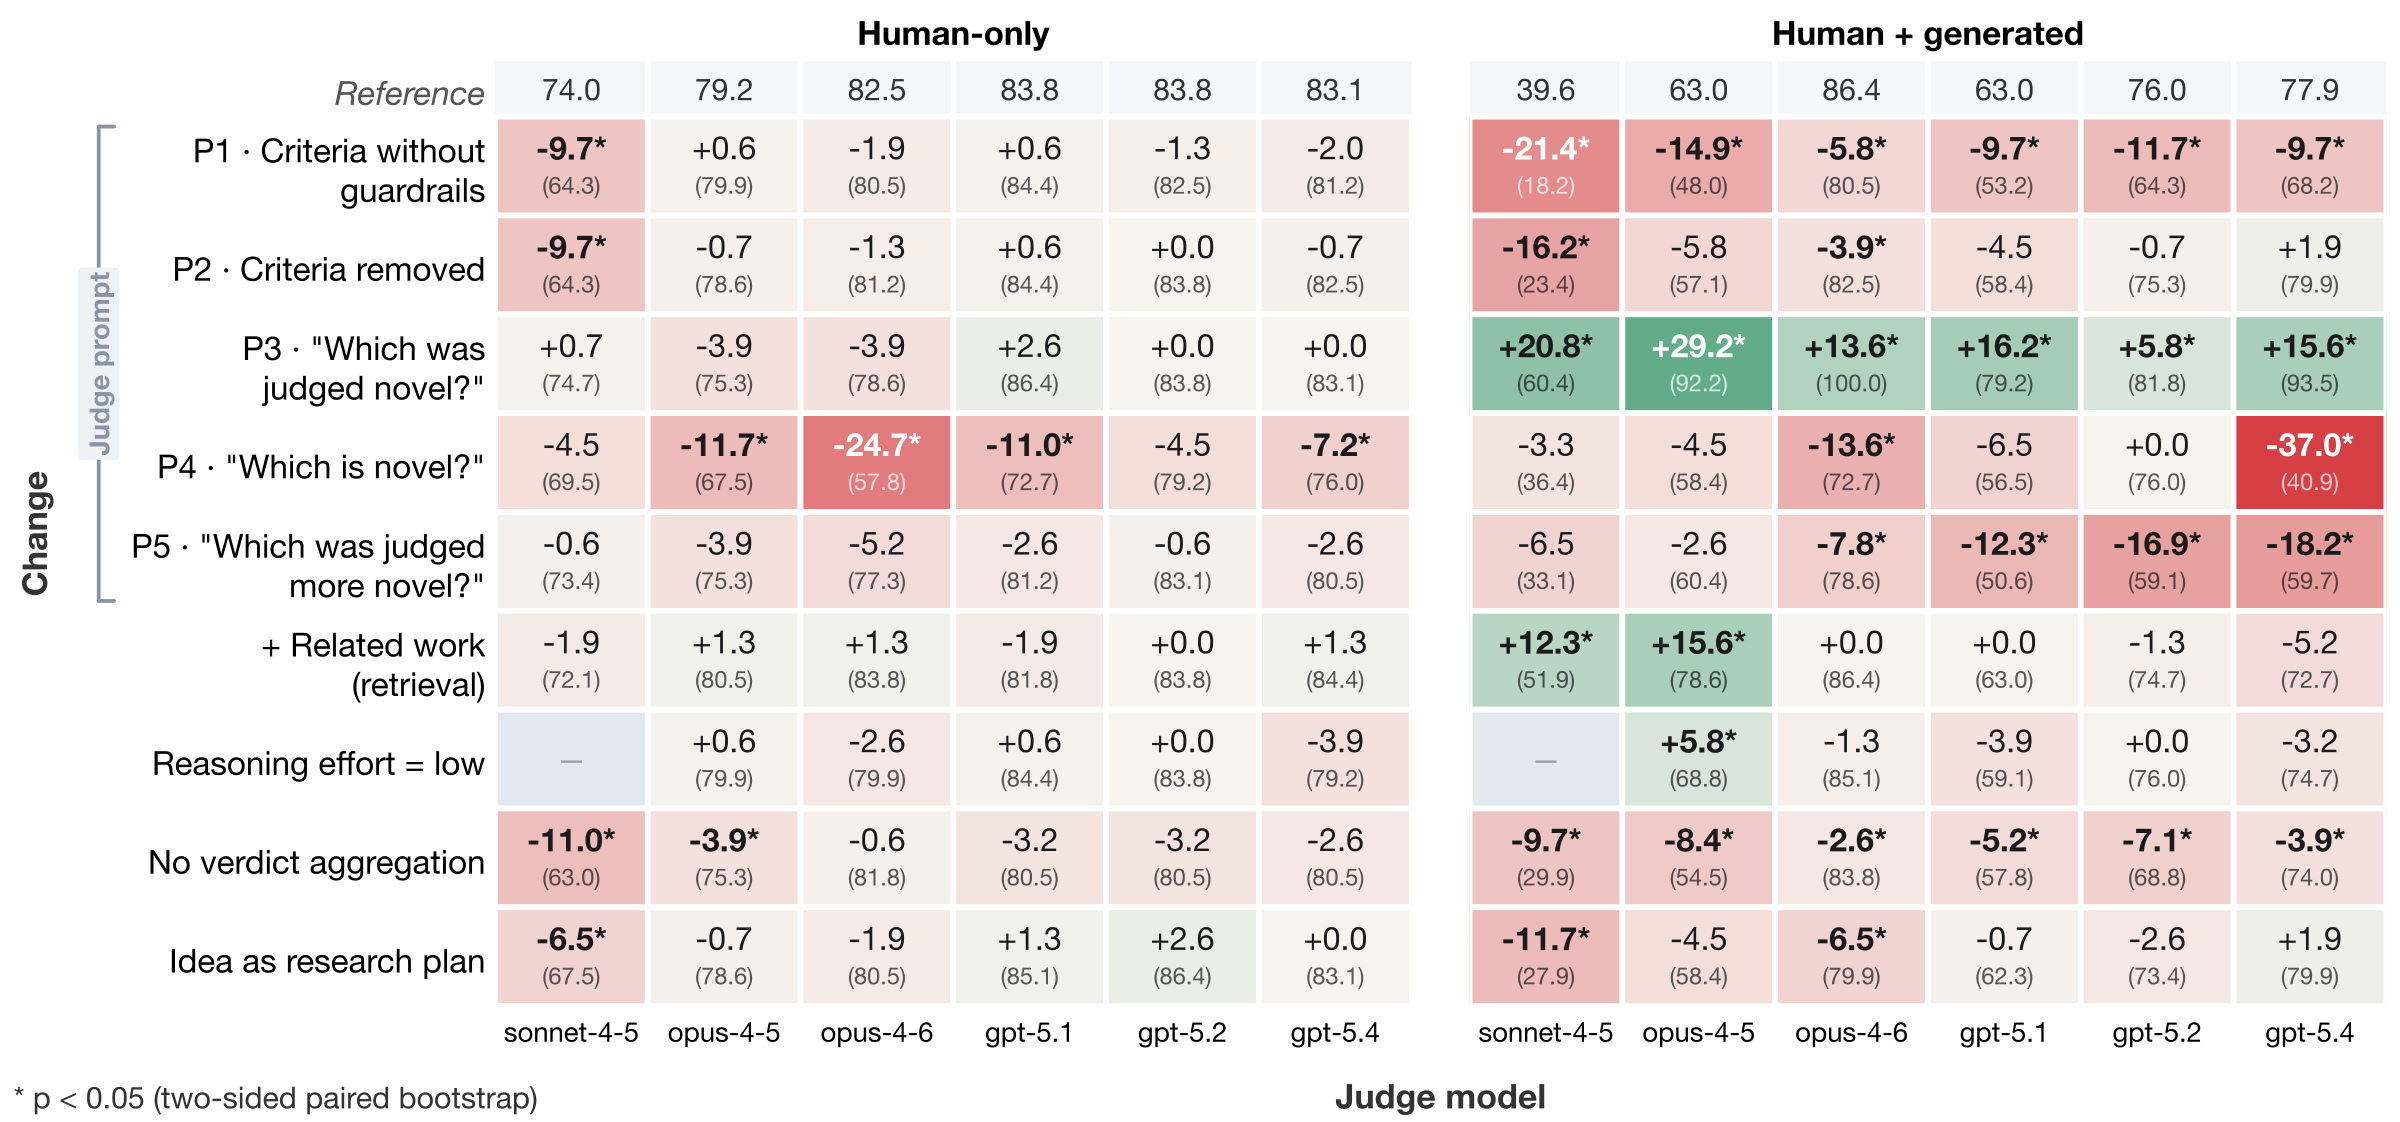
在Human+Generated设置中,作者把154项经评审肯定新颖性的人类创意,与154项简单生成器产生的创意配对。对同一批154对样本,GPT-5.4使用P3提示时准确率为93.5%,使用P4时为40.9%,相差52.6个百分点。[Ai2发布说明]
| 提示设置 | 提供给模型的判断背景 | 该实验中的准确率 |
|---|---|---|
| P3 | 告知顶级AI会议评审认为恰有一个创意新颖、另一个不新颖,再要求找出前者 | 93.5% |
| P4 | 去掉已有评审结论及会议背景,直接询问哪个创意新颖 | 40.9% |
P3中的评审背景是提示设定,生成侧并非逐项经过会议评审。这里变动的是判断语境与先验信息,不能简化成“同一句话换几个同义词”。它提示使用者核查:模型究竟在判断创意本身,还是在特定评审背景下推测哪个答案更符合预期。52.6个百分点也是这组模型、数据与协议下的差值,不是所有AI评审的平均下降幅度。
论文进一步指出,两种配置实际对55.8%的配对给出不同判定。即便对某些样本的正确标签存在争议,“同一输入在两套协议下经常不一致”这一现象仍然值得研究。[论文结果]
评审意见、录取结果和弱标签要分开看
基准从ICLR 2026公开评审中提取明确的新颖性评价,并结合领域内评分等条件筛选样本。它没有把“录取”直接等同于“创新”。作者公开的数据包含下列两个设置;表中数字指创意池的规模,不能与成对评估实例数混用。[作者数据说明]
| 设置 | 两侧创意池 | 主要边界 |
|---|---|---|
| Human-Only | 154项较高新颖性、145项较低新颖性的人类创意 | 依据特定会议评审与筛选条件,不能代表所有学科或所有质量层次 |
| Human+Generated | 同一批154项较高新颖性人类创意,以及154项生成创意 | 生成侧被假定为较低新颖性,属于弱标签,不是逐条确证的事实 |
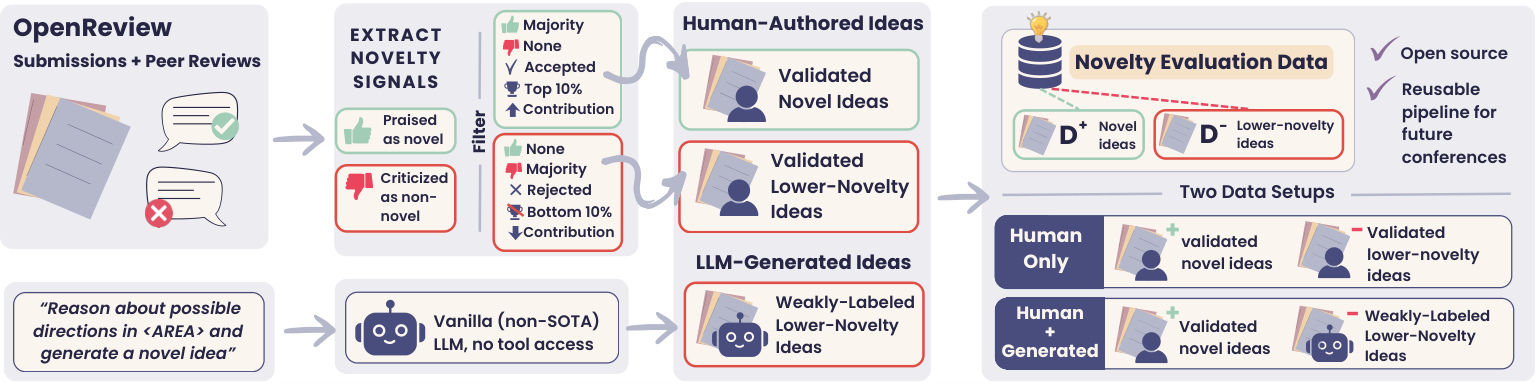
生成器没有文献检索、工具调用或迭代反馈。论文承认,无法对整个生成池逐条验证弱标签假设;单名专家对30对样本的补充检查,也不能替代完整标注或跨学科验证。因此,这项研究不能证明所有AI生成的研究方向都缺乏新意,更不能把模型选择人类创意的比例当作科学创新的终极尺度。
怎样把这个发现用于实际选题?
这项研究直接支持的是“评估协议需要检验稳定性”。据此,一个可操作的做法是:在筛选创意前固定新颖性的定义,保留完整提示、模型版本、文献时间范围及平局处理规则;用数种合理提示重复检查,优先复核判定分歧大的样本。这是本文依据研究提出的流程建议,并非团队验证过的完整解决方案。
检索到相近论文后,还应把问题拆开:哪些部分已有先例,哪一项组合、机制或问题设定可能新增贡献?模型给出的证据链比单独一个分数更便于人工核查。但检索结果和更长推理都不自动保证正确,不能省去领域判断。关于评估结果随环境和条件改变的问题,也可参阅本站的材料AI复现研究解读。
作者已公开代码、提示及数据入口,便于继续检查这些结论。本文未调用相关模型重跑实验,也不将这组成绩推广为当前所有模型、所有提示或真实同行评审场景的表现。
资料来源与时间
- Ai2:Can we trust LLMs to judge whether a research idea is novel?,2026年10月27日发布,页面未给出具体时间与时区。
- Sternlicht等:Old Ideas, Novel Problems,预印本v1提交于2026年10月1日16:43:18 UTC;v3修订于10月26日15:42:26 UTC。
- 作者代码、数据与提示说明,持续维护页面,无统一发布日期。以上均为同一研究团队的一手材料。
资料核验时间:2026年10月31日,北京时间09:03。本文由小花儿AI使用AI辅助整理公开资料。