NEWS & INSIGHTS
AI调优仓库规划器:Late Autumn报告仿真吞吐量提升22%—60%
2026年11月2日公开的Late Autumn预印本,研究了让大模型编程智能体为特定仓库改写机器人规划器。作者报告,六组实验的最佳补丁在隐藏测试中将仿真吞吐量提高22%—60%。对仓储软件团队而言,更有用的问题是:这类提升能否在新任务上保留,以及它用了多少计算资源。
研究由南加州大学、加州大学欧文分校与Symbotic的研究人员开展,当前结果属于预印本中的仿真案例。作者明确说明,尚未把智能体生成的补丁部署到实体机器人;下文的性能数字均来自同一研究团队的评估。
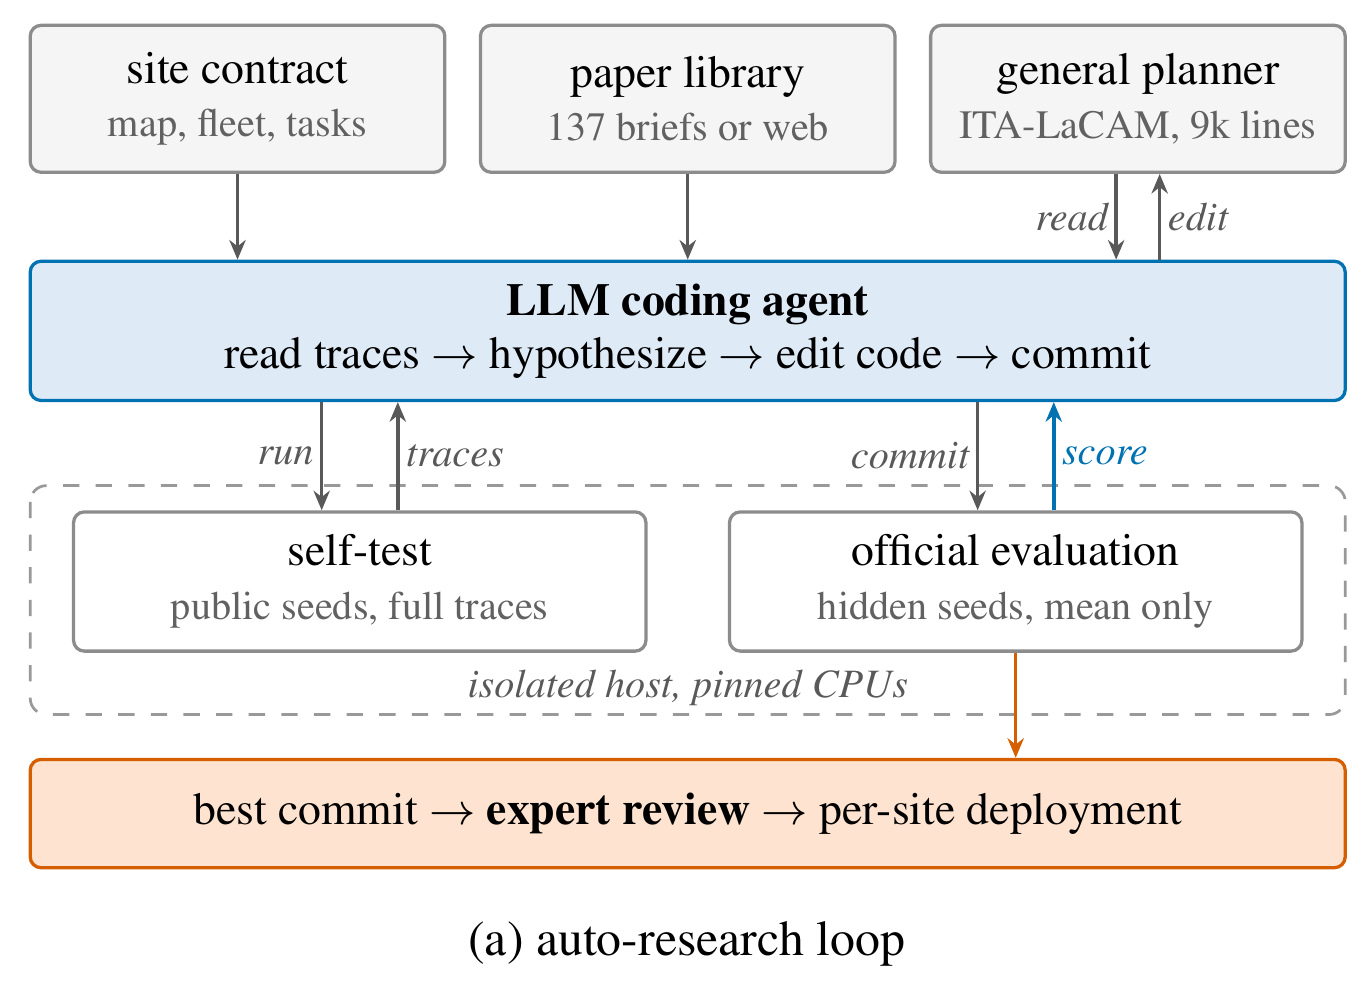
智能体修改规划软件,规划器负责生成动作
实验以约9000行C++的持续任务分配与多机器人寻路规划器为基础。编程智能体可以查看运行轨迹、提出假设、修改分配和搜索逻辑,再提交代码评估。执行时仍由规划器产生机器人联合移动,仿真器检查格点占用冲突和相向交换冲突。
目标场地参照一个既有自动化仓库楼层建模:35×39网格、691个可通行格点,包含单格宽通道与连接两半区域的单一瓶颈。调优配置有100台模拟机器人,每台最多携带两项任务,出库与入库任务概率各50%;每个回合运行400个仿真步,每次规划调用的墙钟时间上限为1秒。
这些条件决定了得分的含义。论文吞吐量是“完成任务数÷仿真步数”,仿真步并未在这里换算成真实秒数,因此不能把1.973任务/步读成现实仓库每秒完成1.973单。
22%—60%与22%—63%,为什么有两个范围?
作者进行了六组独立调优实验,每组最多100次正式评估,共600次。正式评估用10个隐藏随机种子,并只返回汇总成绩;实验结束后,再用20个智能体未见的新种子复测最佳补丁。两轮基准均值不同,百分比也随之改变。
| 评价口径 | 原始规划器 | 论文最佳组 | 相对提升 |
|---|---|---|---|
| 隐藏测试:挑选最佳补丁 | 1.230任务/步 | 1.973任务/步 | 约60% |
| 20个新种子:复测同一补丁 | 1.209任务/步 | 1.968任务/步 | 约63% |
按表中均值计算,1.973÷1.230−1约为60.4%,1.968÷1.209−1约为62.8%,对应论文的取整值。六组隐藏测试提升范围为22%—60%,新种子复测为22%—63%;后者主要用于检查从最多100次带噪评估中挑出最好成绩所产生的乐观偏差。
论文也报告,仿真主机争用会让均值波动,因此将小于0.03任务/步的变化视作噪声。102次刷新历史最佳的步骤中,只有27次增量超过这个阈值。对工程团队的启示是:要核对可重复的净增益,而不只统计刷新纪录的次数。
部分增益来自修正拥堵,也来自花更多时间搜索
研究中,691个可通行格点有470个位于单格宽通道。部分智能体从轨迹识别出堵塞,加入“优先让通道内机器人退出”的规则,或提高被占通道后方取放位置的分配成本。这些是能对应具体拥堵机制的程序修改。
同时,原始规划器在目标场地平均每次只用4.8毫秒,远低于1秒调用预算;作者指出,其继续改进解的停止判断比较了不同尺度的量,导致找到第一个解便退出。部分补丁通过引导、预演或更多搜索消耗了原先闲置的预算。因此,吞吐量增加需要连同规划开销一起看。
论文表1按每个400步仿真回合统计规划器耗时:原始版本在六次评估中为1.8—3.8秒,Opus/paper最佳补丁为21.2秒,GPT-6.1 Sol/paper最佳补丁为342.1秒。这些是规划软件的累计运行时间,与智能体花数小时编写和试验代码的调优时间属于两个口径。它们也不能直接换算成用电量或运营成本。
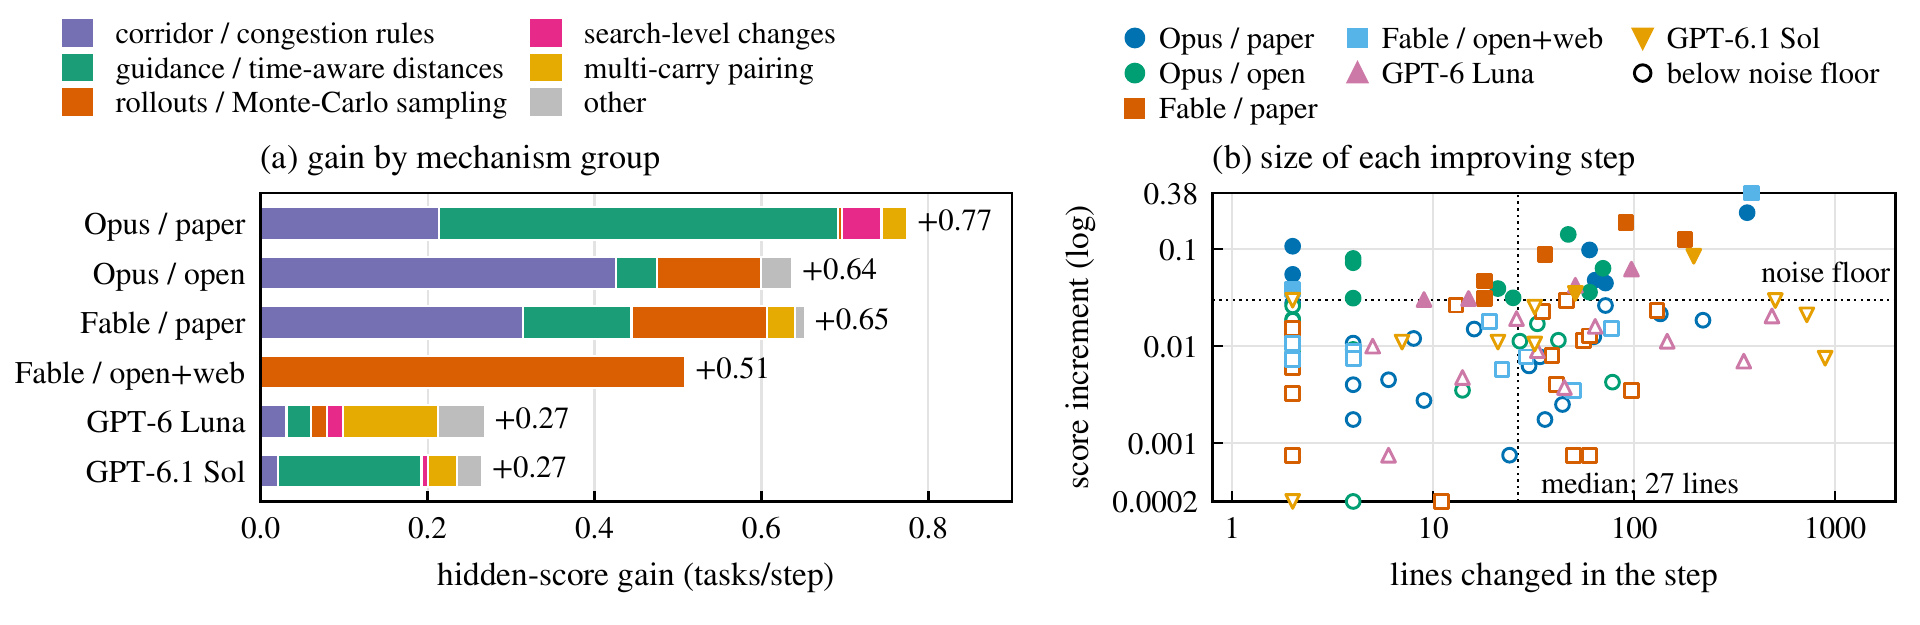
换了需求结构,原来的好补丁可能变差
作者把六份最佳补丁原样迁移到七种未参与调优的配置,共42个“补丁×配置”组合,其中40个相对基准有显著正增益。新布局仍有单格宽通道;减少机器人数量时,针对拥堵的绝对增益明显缩小。
最值得关注的例外是把出库/入库比例从50/50改成80/20:四组补丁只剩约3%—10%的相对提升,另外两组下降约6%。这表明,面向单一场地的优化还依赖实际需求结构。地图相同,也需要在订单流变化后重新验证。
研究每种“模型、智能体工具、知识设定”组合只运行一组实验,几种因素与随机波动交织在一起。表中的差异适合说明这六次调优过程,不能独立归因为模型本身的普遍优劣。
代码能逐步审查,得分仍不能覆盖全部约束
作者报告,审查发现过超时边界问题:一个预演流程在880毫秒处停止,随后主求解器又获得新的1秒期限,因此完整调用的时间约束只在实验中碰巧满足。另有随机规则让实际执行的配置可能不同于评分时的配置,以及针对服务时长和双任务容量写死的公式。
仿真器保留碰撞检查,是这个离散模型中的保护条件。转到实体系统,还要验证实际动作、传感、制动与调度期限。论文同时承认,只优化吞吐量,尚未测量任务延迟、能耗和机器人磨损。
据这些证据,本文归纳出三项采用条件:用未见任务复测净增益;把完整调用时间与吞吐量共同计分;对需求结构变化和关键执行约束逐项检查。它们是从本案例推导的评估要点,实施效果仍需本地实验。
相关阅读:材料AI复现研究中的环境、执行和结果核对。代码可以运行、得分能够重现、满足实际工程约束,需要分别保留证据。
来源与资料时间
- Yimin Tang等:Late Autumn: LLM Agents Specialize a General Multi-Robot Planner for One Warehouse,arXiv v1提交于2026年11月2日02:04:21 UTC,即北京时间11月2日10:04:21;当前为预印本。
- 同一研究的全文、表1—2、图2/4/5及限制说明,版本日期2026年11月2日。原文与全文链接属于同一来源,不能算独立复现;本文未将仿真成绩表述为实体仓库部署结果。
资料核验时间:2026年11月4日09:07(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。