NEWS & INSIGHTS
GUILD机器人研究:用数据归因指导下一批示范采集
北京时间2026年11月4日凌晨,得克萨斯大学奥斯汀分校研究团队公开GUILD预印本,研究如何用AI指导机器人下一批示范数据的采集。它把视觉语言模型提出任务与数据归因评估连接起来,再让人按建议采集示范。对于需要花时间遥操作、训练机器人操作策略的团队,关键问题是:下一批数据怎样才能更有助于目标任务?
这是一项含仿真与实机实验的研究,尚不能据此认定已在家庭或仓库规模部署。以下主要实验事实来自作者同一篇论文及其附录,属于单一研究团队的一手报告。
任务看起来相关,为什么还要再评估?
GUILD先依据目标任务示范、文字描述及可用场景和物体,让视觉语言模型提出采集任务;随后用预测性数据归因,估计已有示范对目标数据上策略表现的影响,将下一批采集预算投向当前更有用的任务。积累新数据后重新计算,隔若干轮再提出新任务。
这里的“有用”是局部估计:论文用少量目标示范上的模仿学习验证损失作为代理指标,并非每轮都去目标场景直接测成功率。已经很有用的任务也可能随着数据增加而收益递减,所以一次排序不能永久替代后续评估。
这为采集工作提供了一条可检验的判断链:任务提议说明“可能相关”,归因结果说明“在当前模型与数据下值得尝试”,最终实机评测才说明“这批数据训练后的策略表现如何”。三者的证据强度不同。
三种实验,分别支持什么结论?
| 设置 | 采集与评测条件 | 读者可据此判断的范围 |
|---|---|---|
| LIBERO仿真 | 3个目标任务,各用另外16个场景采集;每种策略重复3个采集种子,评测包含5个策略训练种子、每次100次运行。 | 支持在受控仿真下比较数据分配方法;不直接代表实机效率。 |
| 实机固定任务池 | 6个搭建场景中预先采好49项任务数据;从已有数据中选择,测试4个目标任务。 | 支持比较选择哪些示范;这里的“采集”不意味着为每种方法重新遥操作采一遍。 |
| 实机开放任务空间 | 模型可指定场景、物体配置和任务,人类遥操作员据此采新示范;与VLM均匀采集和2名人类专家方案比较。 | 更接近指导实际采集,但仍限于论文的场景、物体和任务。 |
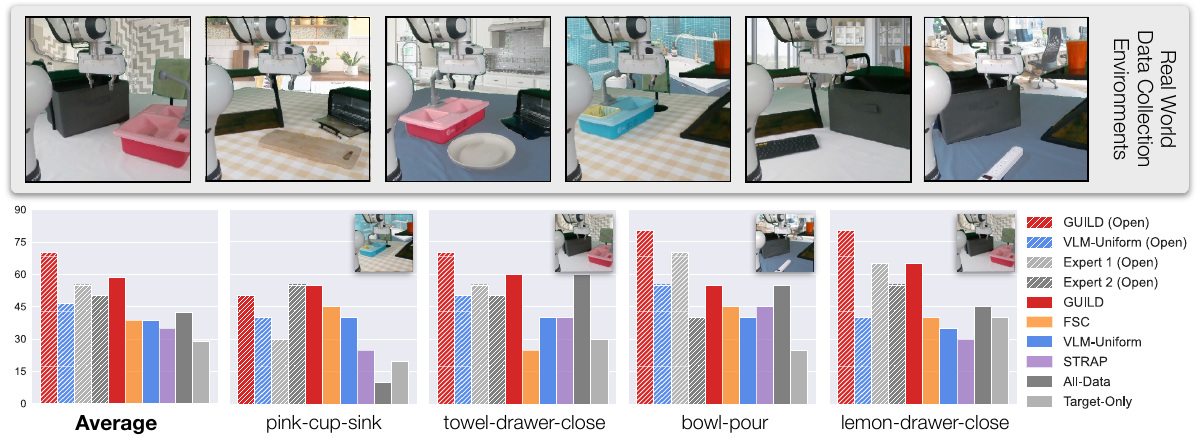
实机的6个场景对应厨房、浴室和办公室各两种布置。作者通过设备摆放、桌面纹理以及绿幕替换背景形成差异;它们是搭建的实验环境。论文图中的背景不能当成机器人已经进入真实住户家庭的证明。
“目标场景难接触”仍需要多少目标数据?
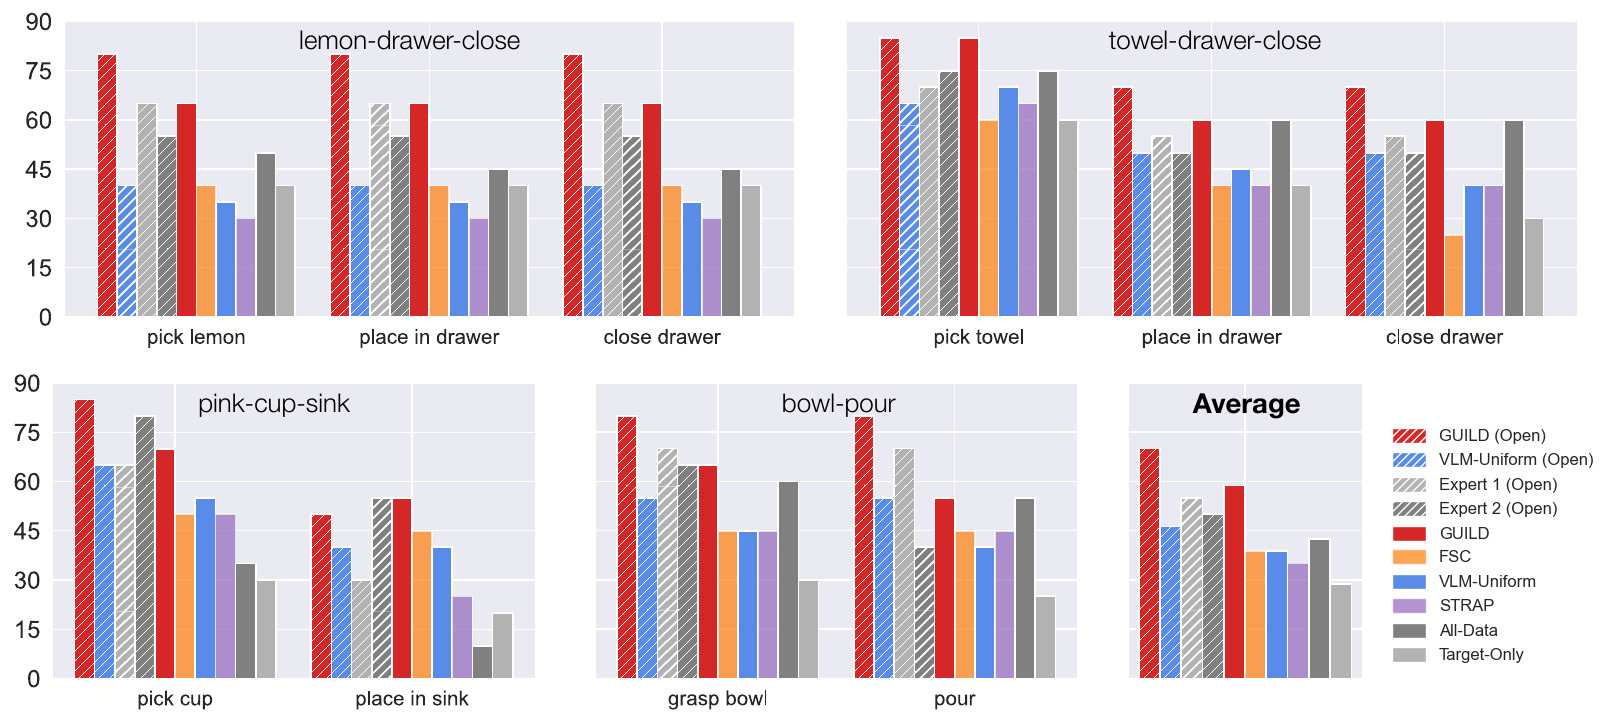
方法并不要求完全没有目标数据。表1分别使用15条粉色杯子放入水槽示范、30条毛巾放入抽屉并关上的示范、20条碗倾倒示范、50条柠檬放入抽屉并关上的示范。训练时还将目标示范与辅助数据按50/50比例采样。这是训练抽样比例,不表示两类独立示范数量相等。
每个实机目标任务用相同的一组20个初始配置运行20次。由此可知,单项任务多成功一次就相差5个百分点。采用者应同时查看逐项任务、样本数和失败阶段,而不能只凭平均柱形图判断稳定性。图9还显示:杯子抓取成功后,放入水槽仍可能失败;柔性毛巾的放置也可能成为后续关抽屉的瓶颈。
省下示范预算,需要付出什么?
作者报告,单轮元梯度与效用估计在4张NVIDIA A5000上约需10—15分钟;实机每轮采集约需15—30分钟。包含归因与采集的20轮实机开放流程约需10—15小时。这些是论文配置下的用时,不是任意机器人任务的费用报价,也不足以换算为普遍的成本节省比例。
归因信号也有边界。附录将数据平均效用与最终策略成功率比较:三个仿真任务的Spearman相关系数分别为−0.23、0.78和0.75。至少在第一项任务上,代理指标与最终结果并不呈正相关。因此,实际采用时应保留最终任务评测,并判断重复归因的计算开销是否值得。
论文也承认,视觉语言模型可能提出不可行或重复的任务,实践中仍需要人的监督。本研究值得关注的增量,是把“接下来采什么”变成可反馈更新的过程;它并没有免除遥操作、目标数据或实机验证。此前介绍的ARC机器人推理研究关注动作策略中的推理标注;GUILD讨论的是示范采集的分配,两者解决的是不同环节。
来源与资料核验
- Shivin Dass等,GUILD: Guided Iterative Data Collection for Imitation Learning,v1记录与许可。首次提交:2026年11月3日18:57:35 UTC,即北京时间11月4日02:57:35。
- 同一论文的全文与附录、PDF及作者源文件:同为上述v1版本,用于核对实验、成本、图表和素材许可,不作为多项独立研究计数。
资料核验时间:2026年11月5日09:45(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。