NEWS & INSIGHTS
Scientist World公开科研环境:74%基线改进率的测试边界
· 更新:
普林斯顿大学的Taiming Lu、Sachin Konan和Zhuang Liu于2026年11月5日18:58:17 UTC(北京时间11月6日02:58:17)向arXiv首次提交Scientist World预印本,介绍把论文转化为可执行科研环境的系统,并报告首批1,000个环境。对于关注科研智能体的读者,值得问清的是:论文所称的74%基线改进率,究竟测量了什么能力?
答案需要同时看任务范围、评分方式和运行条件。74%是作者在一个较小评测集合中统计的留出测试改进比例;其价值在于让研究想法接受代码执行和实验结果检验。以下实验数字均来自该团队的预印本,配套代码仓库也是同一团队的一手资料,不能作为独立复现证据。
把论文变成环境,增加了哪一层检验
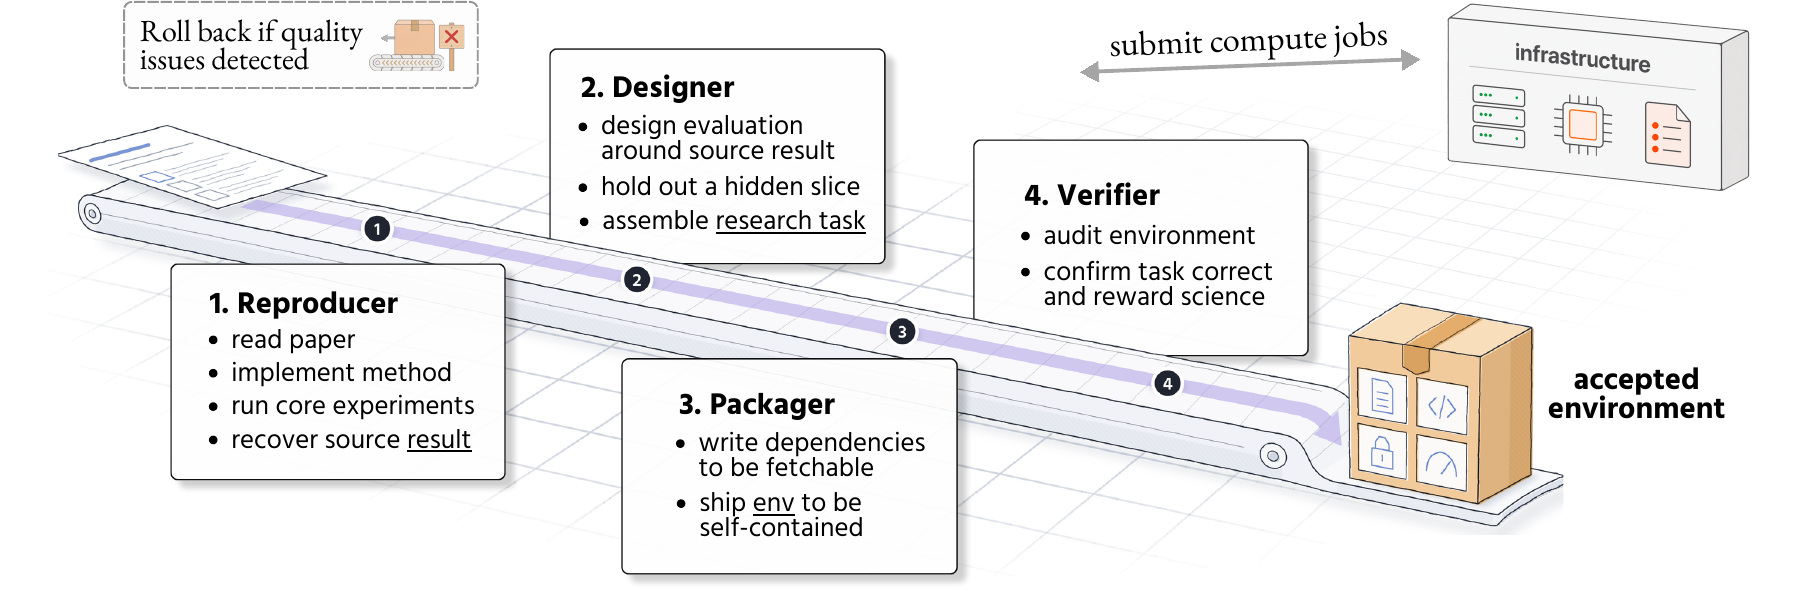
系统先复现论文方法,再把研究问题、允许改变的部分、固定条件、数据接口和评估器整理成工作空间。后续智能体可以提出新方法、写代码、运行实验,再与复现方法比较。构建流程包含复现者、设计者、打包者和验证者;论文说明整个流程没有人工逐篇审核,不能把通过智能体验证等同于经过人工审稿。
作者允许在保留科学问题的前提下缩小实验规模。因此,本文所说的“论文基线”是环境中复现的方法及其结果,不一定等于原论文在完整数据与原始硬件上的最高成绩。来源论文池也有时间边界:附录D、G.1记录,其索引覆盖2025年1月1日至2026年3月1日的arXiv分类日列表,快照导出于2026年3月28日。本次新公开的是系统和研究结果,不能由此推定它已经持续纳入11月的新论文。
1,000个环境与74%成绩,分别对应什么
| 论文报告的项目 | 对应的实验对象与条件 |
|---|---|
| 首批1,000个环境 | 系统构建并验证的环境集合;排行榜采用其中固定的10个较低算力环境,未对全部1,000个环境逐模型通测。 |
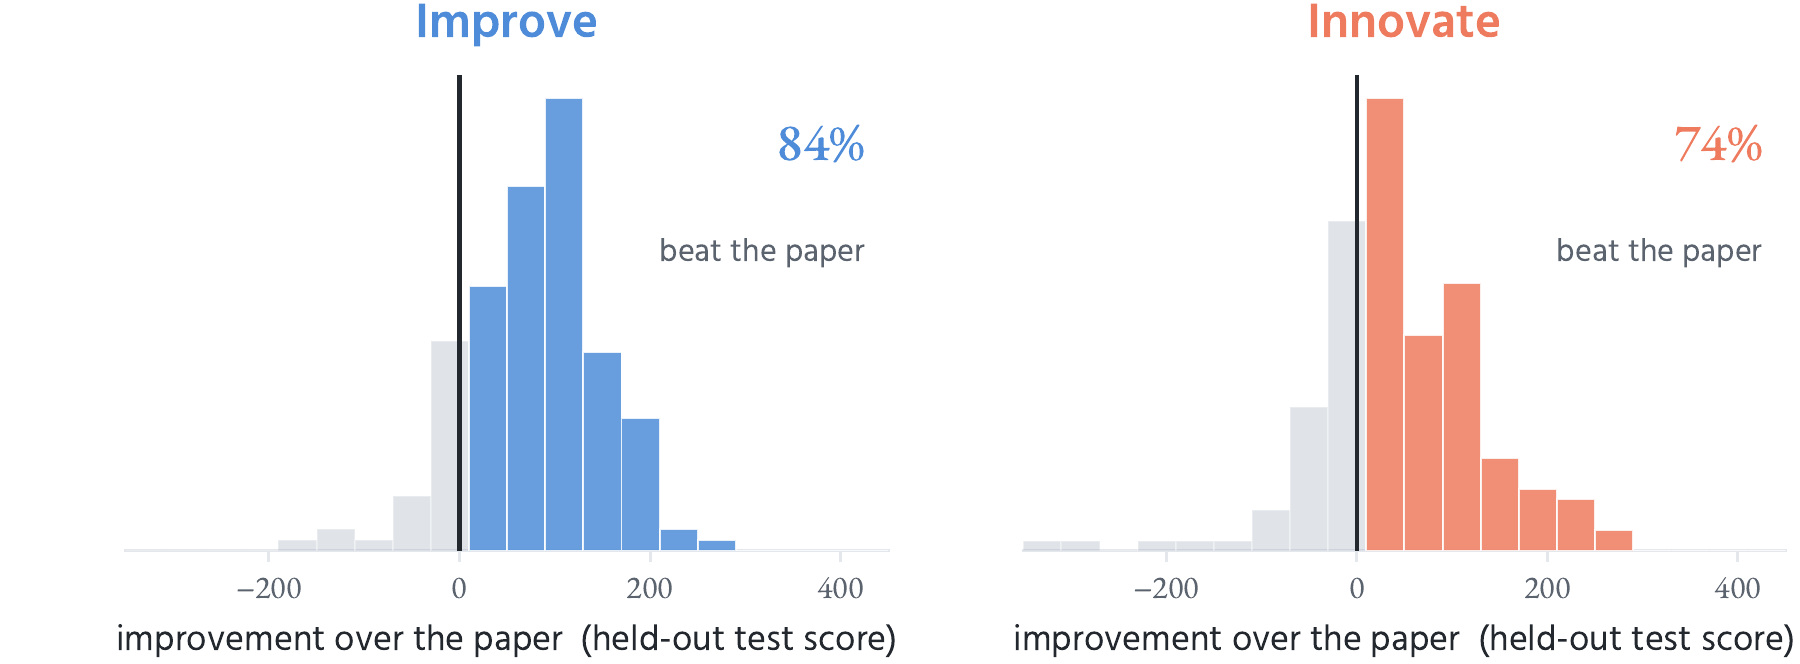
| Improve模式:84% | 智能体拿到复现方法,继续改进;该模式中留出测试结果超过复现方法的运行比例。 |
| Innovate模式:74% | 智能体拿到问题、约束、可见评估器和数据接口,方法目录清空;该模式中留出测试结果超过复现方法的运行比例。 |
| 单次评测资源上限 | 200轮交互、30 GPU小时,同时占用最多2张GPU;采用xhigh或模型支持的最高推理档位。 |
| FNI评分 | 0表示与复现方法持平;正值表示按任务指标加权后取得改进。指标尺度由冻结的参考模型群体校准,100不是准确率100%,也不是原始指标翻倍。 |
这一区分改变了74%的读法:统计单位是这些环境中的评测运行,比较对象是受约束的复现方法,而不是随机抽取的科学家人数。它支持“部分科研任务上出现可执行的指标改进”,尚不能推出跨学科研究能力或真实实验室产出的普遍胜率。排行榜还把可见与留出两阶段的FNI取平均,图35的74%和84%则专指留出测试;读图时应保留这两个口径。
迁移到自己的科研任务前,要核对三项条件
留出测试控制了什么,仍留下什么问题
常规流程在方法冻结后才装载隐藏评估器,避免智能体直接围绕隐藏分数调参。附录E.2还记录了失败恢复例外:先用5轮修复依赖或产物;若仍失败,最后3轮可重新开放方法目录修复接口,相关轨迹会被标记。因此,严格复核时仍需检查修复记录。在Innovate模式中,任务期间不提供论文全文和原方法;这仍无法单凭运行时隔离措施,排除模型预训练中已见过相关论文的可能性。
相同GPU小时,不代表完全相同的计算能力
附录G.5明确承认,GPU小时按占用时间乘GPU数量计算,没有按加速卡型号加权。计算池包含A100、H100、H200,较快硬件可能在同样名义预算内完成更多实验。附录G.3还说明,不同模型使用的智能体运行框架并非完全一致。因此,比较对象是模型与其运行框架的组合;若要据此选型,应同时保留硬件、框架和每次运行的配置。
指标改进需要连同任务约束一起解释
FNI把不同指标方向与尺度统一起来,适合汇总多个问题;实际应用仍要回到原始准确率、损失、参数量等指标及权重。本文的判断是:这套系统较直接的用途,是比较受控任务中的研究迭代,并保留想法、失败、代码和测量结果;能否帮助某个真实项目,还需在该项目的数据、成本和复现条件下验证。关于文本评审本身的不稳定性,可参阅站内Ai2科研新颖性评估研究,两者检验的环节不同。
8B小模型的提升,来自怎样的分工
训练实验进一步把“提出想法”与“执行想法”拆开。作者训练Qwen3-8B,使用1,000条监督样本和1,500条已有实验评分的想法进行后续离线GRPO训练。评估选用10篇不出现在训练样本中的论文,每个阶段每篇采样一个想法,再统一交给GPT 5.6 Sol以xhigh档位实现,共30次运行。
附录表14给出的留出FNI中位数依次为41.2、83.9和106.3。它说明训练后的想法在固定强模型执行者帮助下取得了更好的典型结果;这仍是“8B想法生成器加固定执行者”的实验,并未验证8B模型独立完成全部编码、调试与研究流程。由于每篇每阶段只采样一个想法,也不宜将这一小规模结果解释成每次尝试都稳定提升。
代码仓库的README提供了命令行入口及环境组织方式,同时说明:主仓库代码采用MIT许可,但各环境及其派生轨迹中涉及的论文、代码、数据和模型权重,仍受各自许可约束。实际复用时,需要逐环境核对依赖与权限;本页两张论文配图采用的CC BY 4.0也不替代这些许可。
来源与资料核验
- Scientist World预印本v1与提交记录:首次提交于2026年11月5日18:58:17 UTC,即北京时间11月6日02:58:17。主要依据为正文第2—4节、附录D、E、F、G、H,以及图4、图35和表14。
- 原论文全文:同一v1版本;论文采用CC BY 4.0许可。本页未进行独立实验复现。
- 作者代码仓库README固定版本:所核验提交的提交者时间为2026年11月6日07:09:45 UTC,即北京时间15:09:45;用于核对组件、使用入口及许可边界,属于同团队资料。
更正说明(2026年11月07日09:13,北京时间):明确原方法隔离适用于Innovate模式;Improve模式会提供复现方法。首次发布时间保留。
资料核验时间:2026年11月7日09:09(北京时间)。
本文由小花儿AI使用AI辅助整理公开资料。