NEWS & INSIGHTS
ReproBridge研究:复现材料怎样影响成功率与成本
滑铁卢大学与Google研究者提出ReproBridge,研究如何把复现实验时补全的代码、依赖、启动步骤和判断依据,整理成下一次可直接使用的材料。arXiv记录显示,其首版预印本提交于2026年11月5日18:45:36 UTC,即北京时间11月6日02:45:36。对准备发布或重复运行机器学习实验的人,这项研究回答一个具体问题:保存一次复现积累的执行知识,能提高多少成功率,又要付出什么成本?
作者报告,四个被测模型使用整理后的材料,平均复现成功率从76.4%升至92.6%,后续复现API费用平均减少19.7%。截至本文核验,作者项目页仍将代码与数据标为内部审核中、批准后开源,因此目前应把它理解为公开的研究方案与实验结果。以下数字均为该团队报告,项目页属于同团队说明;本文未进行独立实验复现。
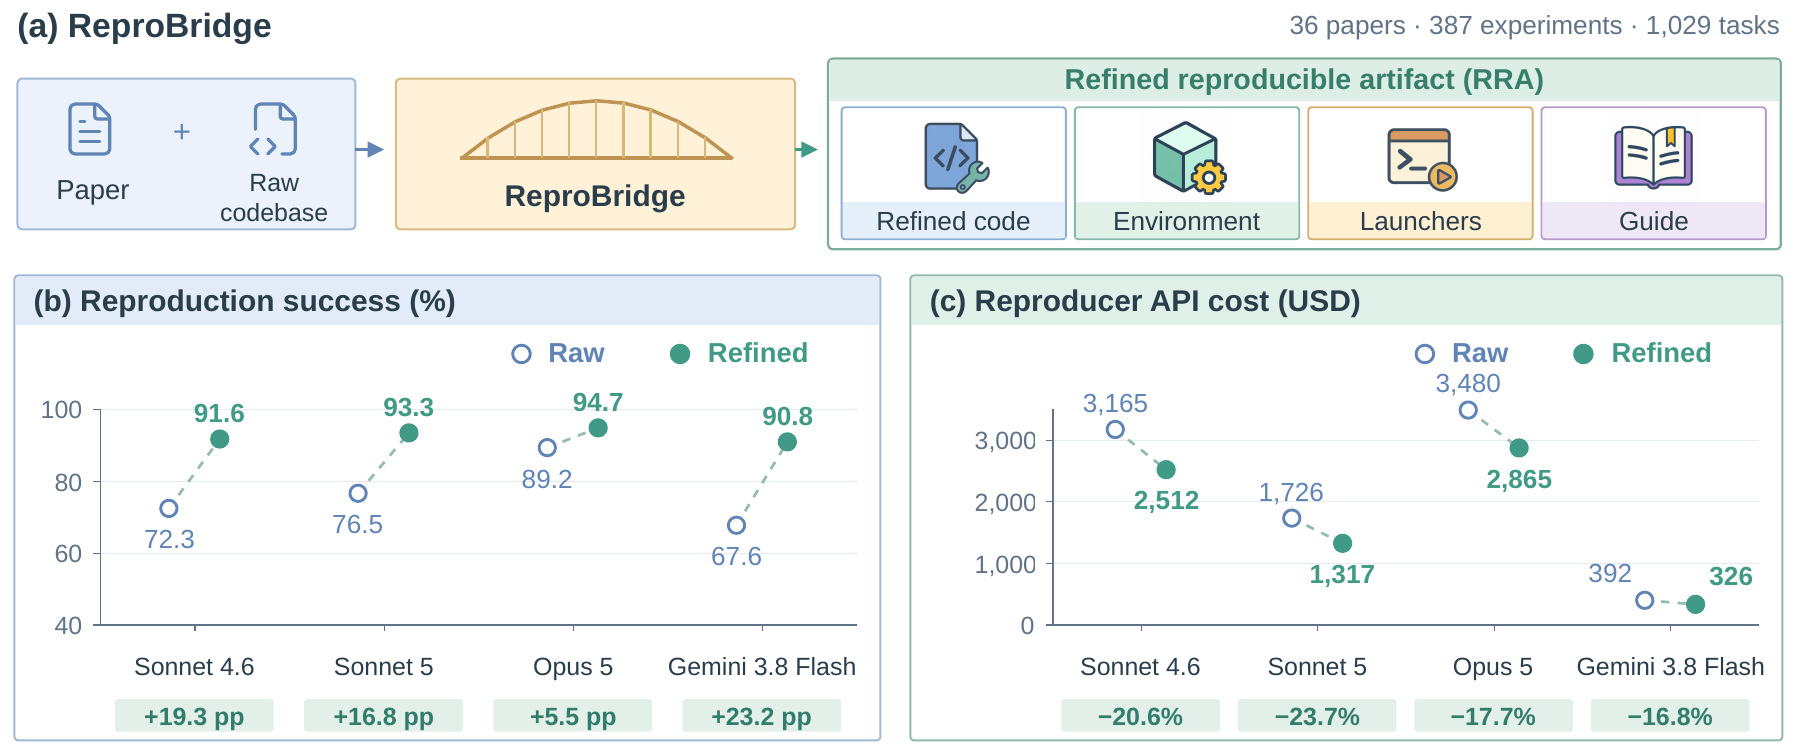
76.4%到92.6%,分母是哪些任务
ReproBridge-Bench保留36篇ICML 2026 Spotlight论文,从主表中的自身方法结果整理出1,463项测量任务。经参考验证,其中1,029项、来自387个实验的任务进入后续评估;其余任务包括数值不兼容、执行受阻以及资源或访问受限等情况。因此,92.6%不能解释为整个会议论文的复现成功率,也没有覆盖全部1,463项任务。
这1,029项中,631项要求完整实验流程,398项只要求评估;允许使用官方检查点的评估任务,不等于重新完成训练。一个实验还可以产出多个任务分数,所以任务数不等于独立实验数。
主实验由Opus 5构建整理后的材料,再让Sonnet 4.6、Sonnet 5、Opus 5和Gemini 3.8 Flash在全新会话中分别使用原始代码或整理材料。两种条件均设每篇论文24小时上限,GPU实验使用8张H100 80GB。主表报告三次评估的均值,跨模型汇总时四个模型等权。按汇总值计算,成功率提高16.2个百分点;各模型增幅为5.5至23.2个百分点。
成功还要求执行证据,不能只对上一个数字
作者为每项任务收集五次经过人工核验的参考观测,允许编程智能体协助,但由研究中的核验人员检查实际脚本、配置和测量提取。成功标准是新运行的数值落入固定兼容区间,且未被独立审计智能体(Auditor)确认无效;不确定的审计结论不计作无效。Auditor会沿输出文件、执行记录和生成脚本追查抄用结果、替换测量方式等问题。
这个标准仍有局限。作者在两人交叉复核的子集中发现39项无效结果,主要Auditor漏掉其中8项。论文也承认,五次参考观测不保证充分估计不确定性。数值兼容和自动审计通过,均不能单独证明科学结论有效或执行过程完全正确。
四类材料保存了什么
整理后的材料包含四部分:修复执行缺陷和补足实验支持的代码;可重建的依赖、数据及检查点准备步骤;把任务连接到配置、执行、输出和分数提取的启动器;解释设置、修复理由、统计口径与未决问题的复现指南。目标是让后续会话拿到可执行步骤,也能知道为何这样执行。
论文中的WBMM案例提供了具体例子:原始代码条件下,一个模型无法在H100环境安装兼容的视觉库组合;整理后的材料保留依赖版本、编译前提和源码构建路径,后续会话完成了六项COCO任务。这是作者记录的案例,不能据此推定同一环境方案适用于所有硬件。
在12篇论文、287项任务的一次消融评估中,完整材料成功率为93.0%,保留普通代码、脚本和日志的交付为81.2%。但两种交付来自不同的上游运行,因此这项比较检验的是构建流程及其交付成果,并未孤立证明“只重新排版同一批文件”就能获得全部增益。
平均改善没有覆盖每篇论文
主结果按任务汇总,任务更多的论文贡献更大权重。作者另做逐论文等权分析,四个模型仍有改善,但每个模型都有3至6篇论文出现退步。下面的图5来自第一次评估,与前面的三次评估均值应分别解读。
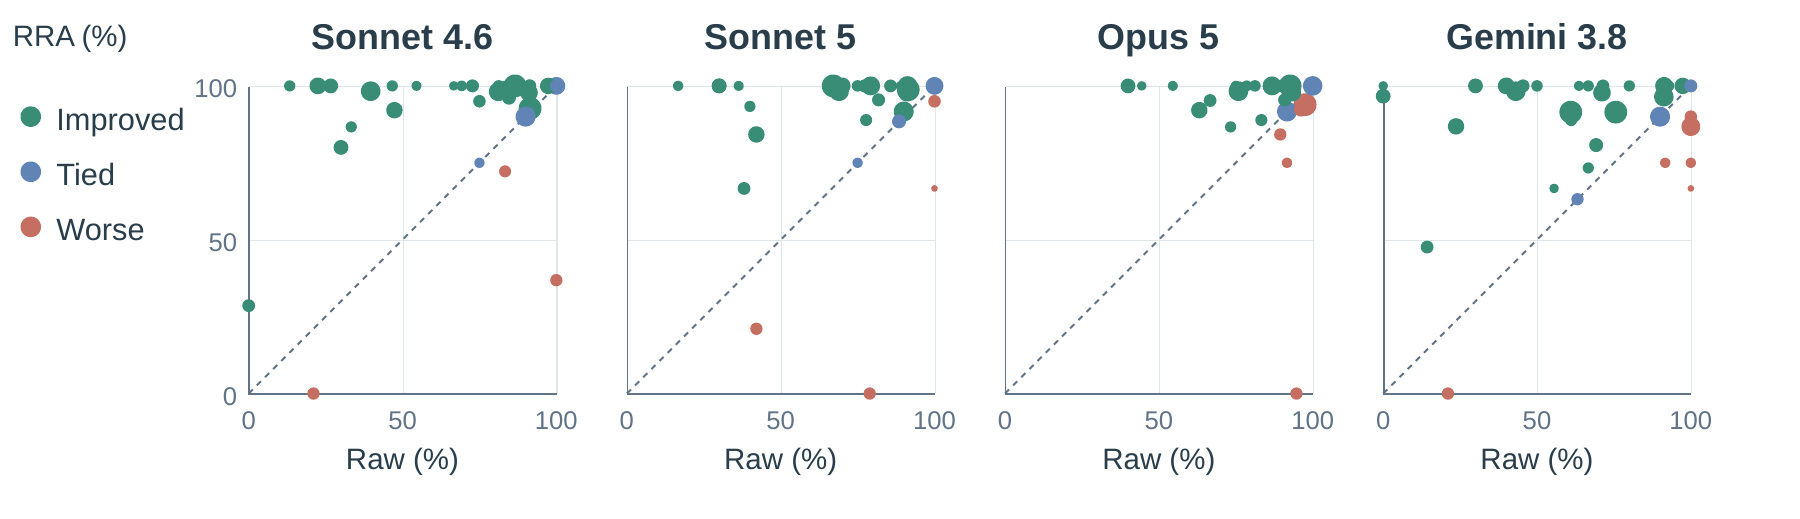
这意味着材料本身也需要复核:一份指南可能保存正确经验,也可能固化错误的实验选择。论文将可运行的环境、测量统计口径和修复依据一并保留,正是为了让后续使用者能追查这些选择。此前站内介绍的材料AI复现研究也涉及实验软件环境核查,可结合阅读。
19.7%节省,何时能覆盖前期投入
19.7%是四个模型各自API费用降幅的等权平均,计入后续复现会话中的失败尝试,但排除前期构建、审计和GPU费用。它不是总项目成本降幅。附录E使用固定费率记账,也不能当作当前API报价。
作者构建36套材料的API投入为5,026美元,平均每篇139.61美元。下表依据论文的成本情景整理:每轮完整重复36篇论文,每个模型情景单独承担全部构建投入,并假设价格、缓存、材料内容和智能体行为保持不变。
| 后续复现模型 | 每轮API费:原始→整理材料(美元) | 每轮节省(美元) | 仅API收支平衡的完整轮数 |
|---|---|---|---|
| Sonnet 4.6 | 3,165→2,512 | 653 | 8 |
| Sonnet 5 | 1,726→1,317 | 409 | 13 |
| Opus 5 | 3,480→2,865 | 615 | 9 |
例如Sonnet 5的每轮节省为1,726−1,317=409美元,5,026÷409约为12.29,所以需要13个完整轮次。这里不是13项任务或13篇论文,而是13次完整的36篇论文工作量。收支平衡仅覆盖构建与后续复现API费用,独立审计、GPU执行、维护及人工参考核验仍需另算。
据此理解这项研究,较实用的判断是把“成功率改善”和“费用回收”分开:即使只使用一次,清晰材料仍可能提高实验完成率;是否降低总体支出,则取决于复用次数、每轮实际节省,以及另列的验证和维护投入。论文没有测量人类研究者的时间节省,不能从API费用直接推算人工效率。
来源与资料核验
- ReproBridge预印本v1与提交记录:首次提交于2026年11月5日18:45:36 UTC,即北京时间11月6日02:45:36。
- 原论文PDF及HTML全文:同一v1版本。主要依据为第2—4节、第6节、附录C与E,图1、图5及表3、表5、表6;论文采用CC BY 4.0许可。
- 作者项目页:未标注独立发布日期;核验时代码和数据仍为内部审核待开源状态。该页面属于同团队资料,不能作为第二份独立实验验证。
资料核验时间:2026年11月8日09:09(北京时间)。
本文由小花儿AI使用AI辅助整理公开资料。