NEWS & INSIGHTS
Terminal-Bench 2.1研究:AI编程分数为何随评测版本变化?
11月5日(UTC)提交的《Benchmarks as Software》预印本,报告了Terminal-Bench从2.0到2.1的任务修复及重新评测:在19组智能体配置中,个别分数变化达12个百分点,名次最多移动三位。对正在选择AI编程助手的读者,这提出一个实际问题:成绩变了,有多少来自模型,有多少来自试题、评分程序与运行预算?
这项由斯坦福大学与康奈尔大学作者完成的研究,将可执行评测视为需要维护的软件。以下结果来自作者实验与公开仓库核对,属于研究报告;本文没有运行这些评测,也没有独立复现其分数。
28项任务有问题,不等于模型答错了28项
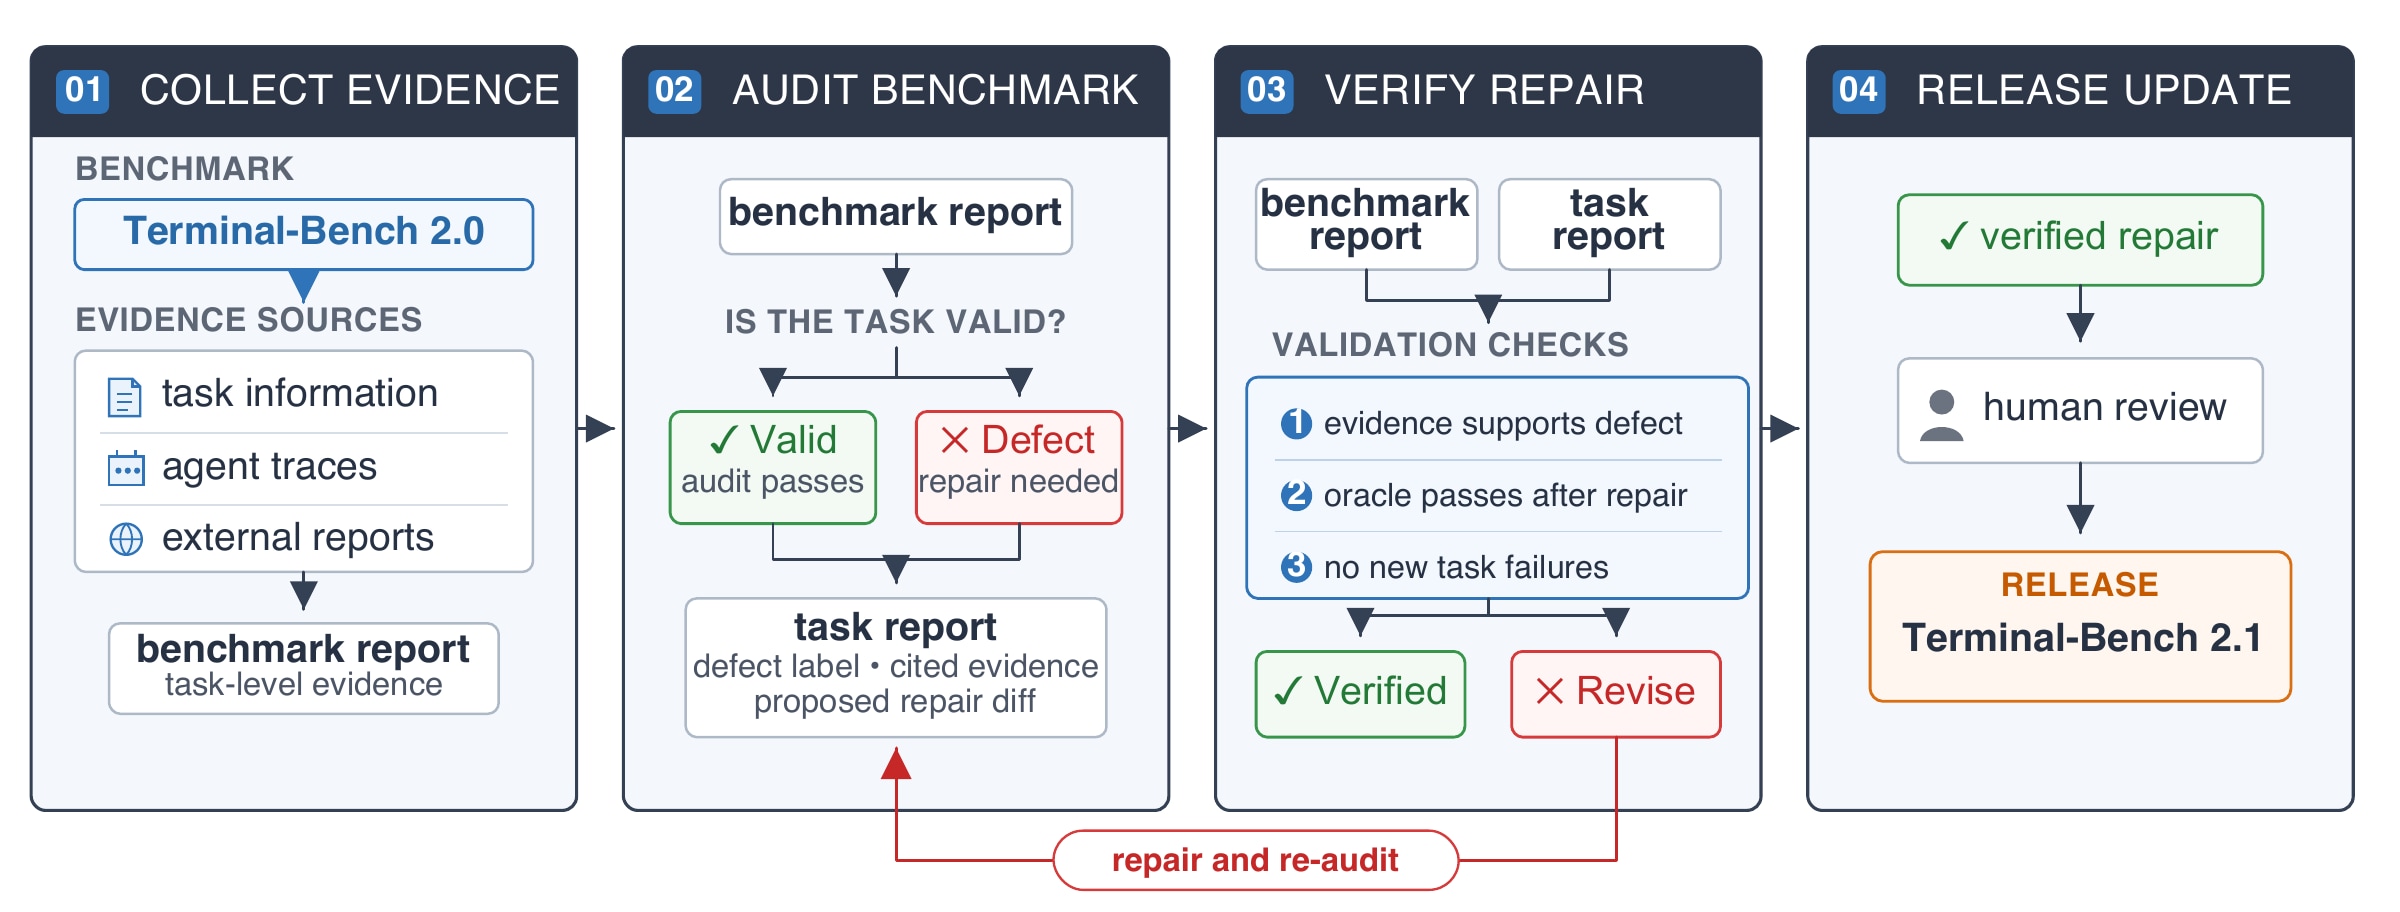
论文在89项TB2.0任务中汇总出28项需要修复的任务。问题分为指令与评分规则不一致、外部依赖变化造成任务漂移,以及环境或资源不足;同一任务可以涉及多个类别。例如,query-optimize的旧评分程序要求数据库文件逐字节保持不变,题目却没有明确写出这一限制。
修复有不同方向:评分程序可能开始接受本来就正确的方案,也可能剔除过去误给的分数。论文称,五项以评分程序修复为主的任务,通过率从不超过15%升至超过50%;同时也有智能体总分下降。因此,这不是一次可以从旧分数统一加上固定增量的更新。
这里还有一个需要保留的资料差异:论文按28项讨论修复与分析,核验时官方2.1仓库README写的是“修改26项任务”。公开材料没有解释这两个计数如何对应。本文将28限定为该论文的统计范围,不把它当成当前仓库修改任务数的统一结论。
总排名相近,近邻比较仍会改变
作者比较19组智能体配置在两个版本下的准确率,报告Spearman排名相关系数为0.958,按任务重采样得到的95%区间为[0.881, 0.979]。这说明整体排序较接近,同时允许局部名次和绝对分数变化;它不是“每个模型有95.8%的成绩不变”,也不是单个模型的可靠性概率。
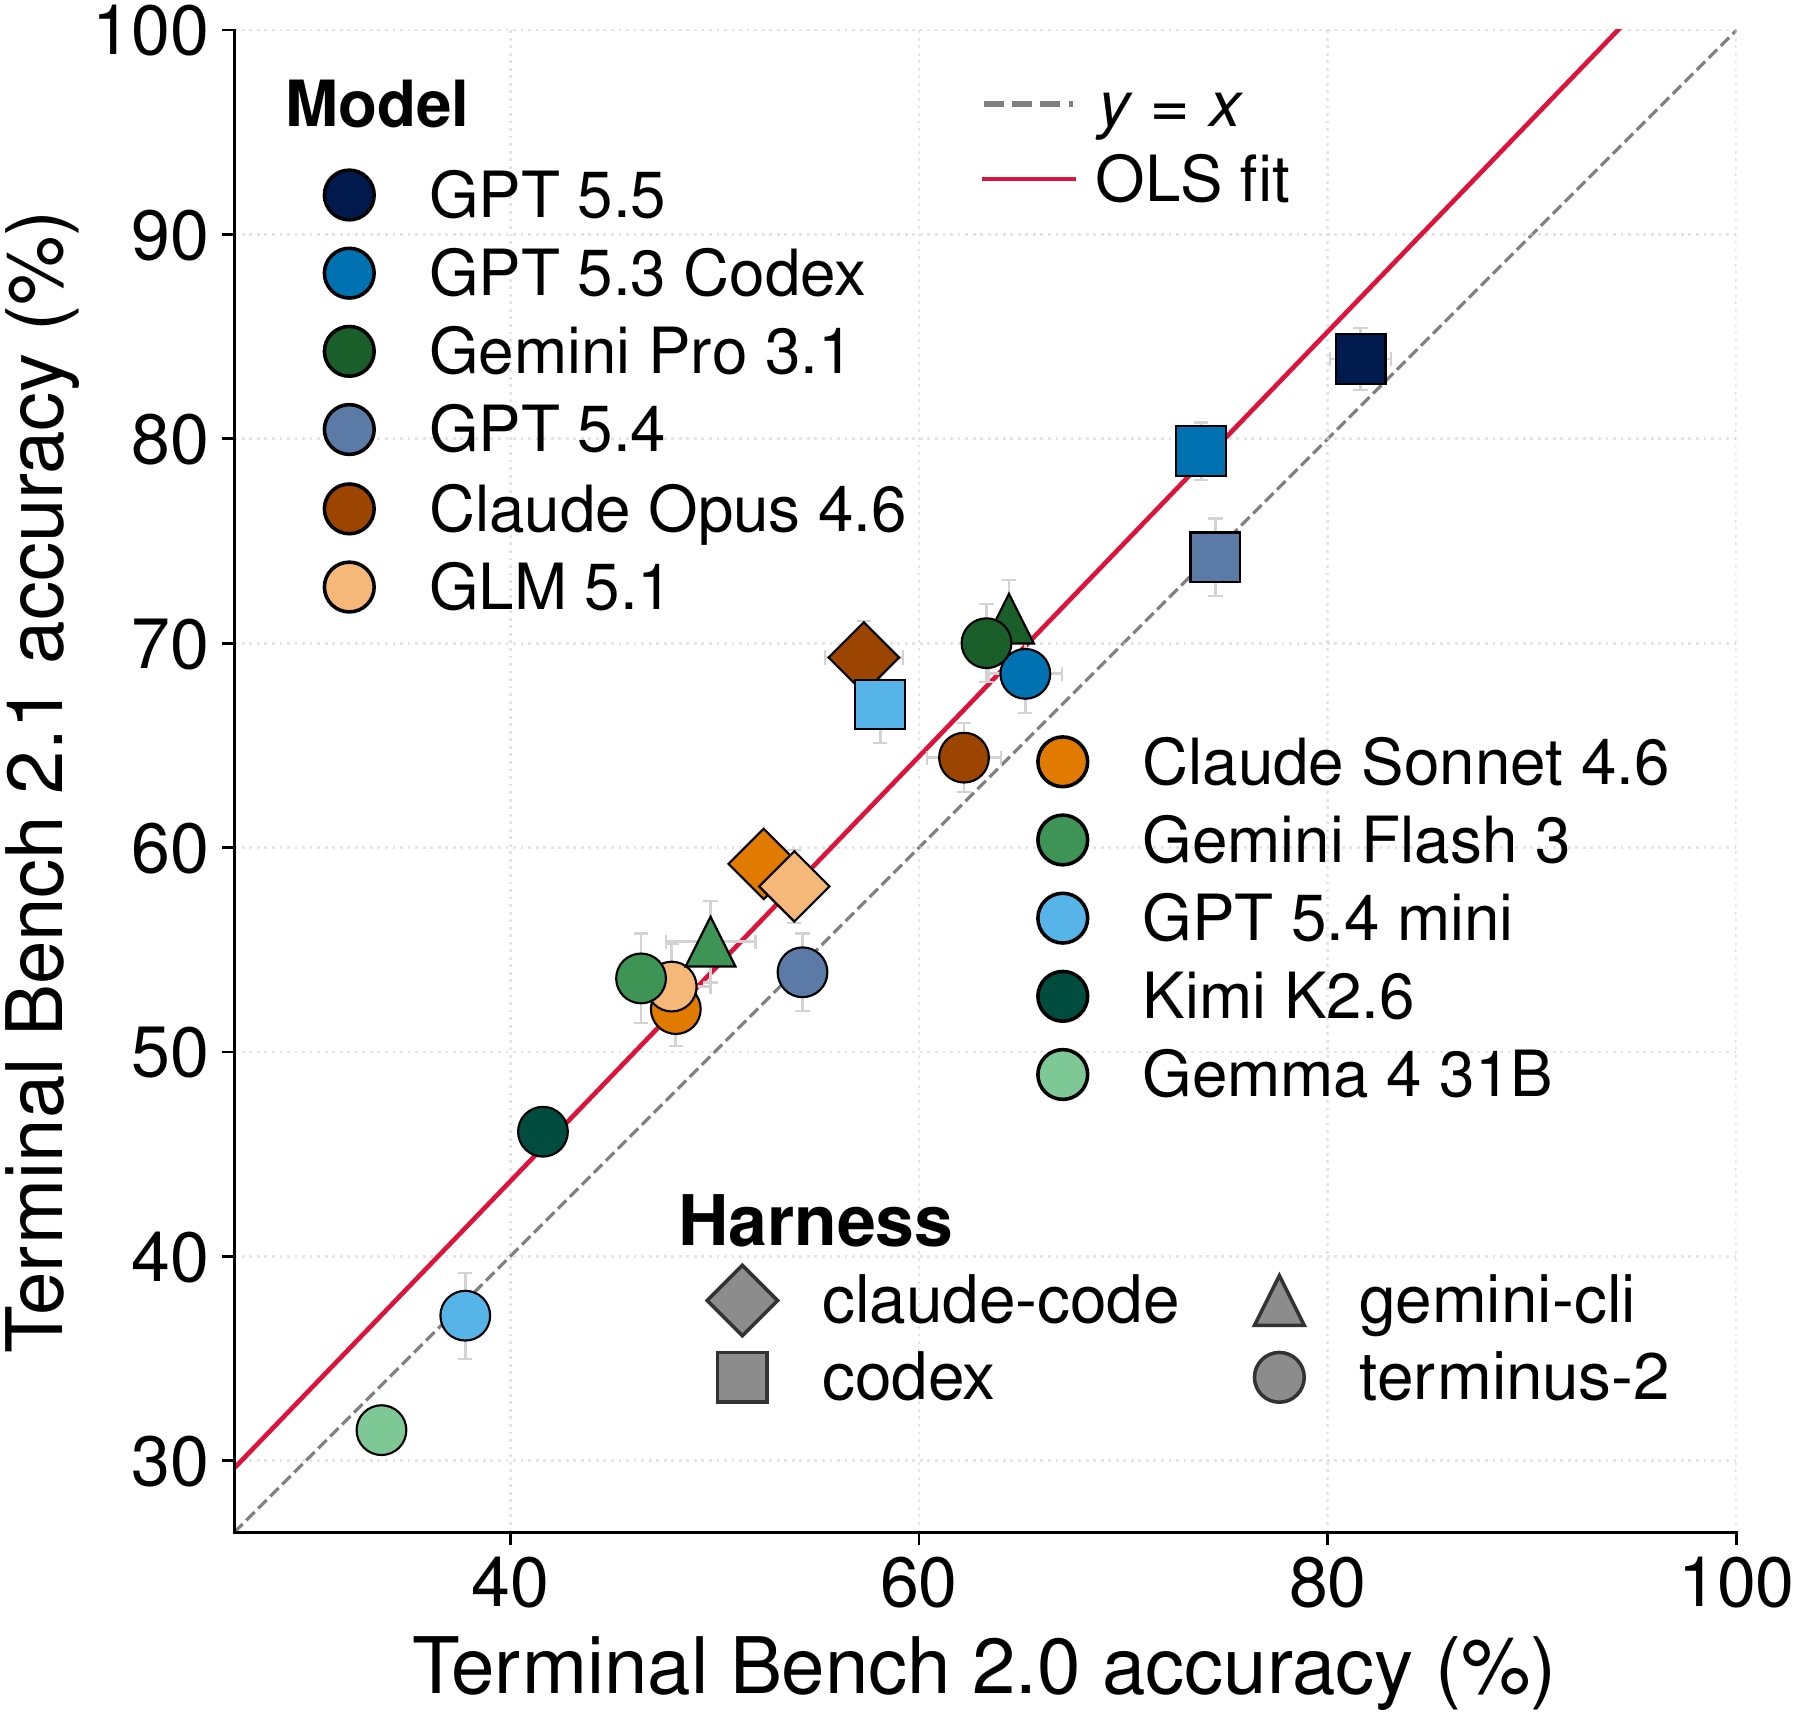
对采购或内部选型而言,本文据此认为,跨版本的两个单点分数不能单独证明某模型后来变强。更可比较的证据,是在同一任务版本、同一运行环境和预算下复测候选方案,再查看逐任务变化及其原因。
同一模型换工具框架,差距还取决于时间上限
论文还做了偏离标准协议的诊断实验,将部分配置的任务超时上限提高至原来的32倍。图6给出的TB2.1准确率如下,单位均为百分比:
| 模型与工具框架 | 标准时间上限 | 32倍时间上限 |
|---|---|---|
| GPT 5.4 / Codex | 74.2% | 74.9% |
| GPT 5.4 / Terminus-2 | 53.9% | 75.3% |
| GPT 5.4 mini / Codex | 67.0% | 68.2% |
| GPT 5.4 mini / Terminus-2 | 37.1% | 62.9% |
按这些四舍五入后的点估计计算,GPT 5.4的两种框架差距由20.3个百分点缩至接近零,mini的差距由29.9个百分点缩至5.3个百分点。它们支持“默认时限下的差距有一部分与执行效率有关”,不能推出任意模型都能靠等待追平。32倍指允许的上限,智能体可以提前结束;它既不是每次实际耗时都增长32倍,也不说明额外时间没有成本。没有区间支持时,75.3%与74.9%的细微差异也不宜当作稳定领先。
另一个容易混淆的分母来自论文图3:全部工具框架合计,57%的失败试验因超时结束。这不是57%的所有试验,也不能把不同框架下的占比直接当成纯模型能力排名,因为各框架对应的模型组合并不相同。
把评测用于工作流,需要保存哪些条件?
这项研究给出的可核验启示,是把评测版本与资源设置一同记录。对照实验至少应保留任务快照或提交哈希、评分程序、容器依赖、模型与工具框架配置、每项时间与内存预算,以及失败轨迹。若更新了评分或依赖,应同时列出受影响任务,区分“有效解被重新承认”“错误解被剔除”和“资源限制解除”三种变化。
AI参与审计也有边界。论文报告该流程相对最终修复集的精确率为57.1%、召回率为71.4%,并明确指出流程参与构建了这个修复集,因此这是回顾性一致程度,不能当作独立发现缺陷的准确率。作者的流程仍由维护者审查把关。相关的实验材料与环境影响,可参阅本站ReproBridge复现材料研究。
来源与资料核验
原论文v1及提交记录、PDF全文:2026年11月5日18:18:39 UTC提交,即北京时间11月6日02:18:39。主要核对第3—6节、图2—6及复现说明;此时间是预印本提交时间,不作为2.1代码首次开放时刻。
官方2.1仓库README核验快照:按提交12b7565679ce5006230b820666353673a133db93读取,README未单列发布日期。该快照写26项修改,论文写28项;上述数字分别归于各自资料。仓库与论文属于项目相关一手材料,不作为两次独立复现实验。
资料核验时间:2026年11月11日16:42(北京时间)。
本文由小花儿AI使用AI辅助整理公开资料。