NEWS & INSIGHTS
StateBench研究:长上下文评测需要区分四类状态追踪
2026年11月3日,艾伦人工智能研究所(Ai2)介绍了StateBench:把语言模型的状态追踪任务分成四级,检验模型能否在一串更新之后给出正确结果。对于需要处理长对话、表格修改或代码执行记录的读者,它提出一个具体问题:模型找得到长文本里的信息,是否也能持续跟住信息如何变化?
这项研究由Jackson Petty、William Merrill、Ashish Sabharwal完成。论文v1于11月2日13:12:15 UTC提交arXiv,换算为北京时间11月2日21:12:15;这是提交时间,不能据此确定首次公开可读的精确时刻。Ai2公告只标注11月3日,未给出具体时间和时区。以下实验结论均归因于作者报告,论文、机构介绍和代码仓库属于同一研究项目,尚不能视为独立复现。
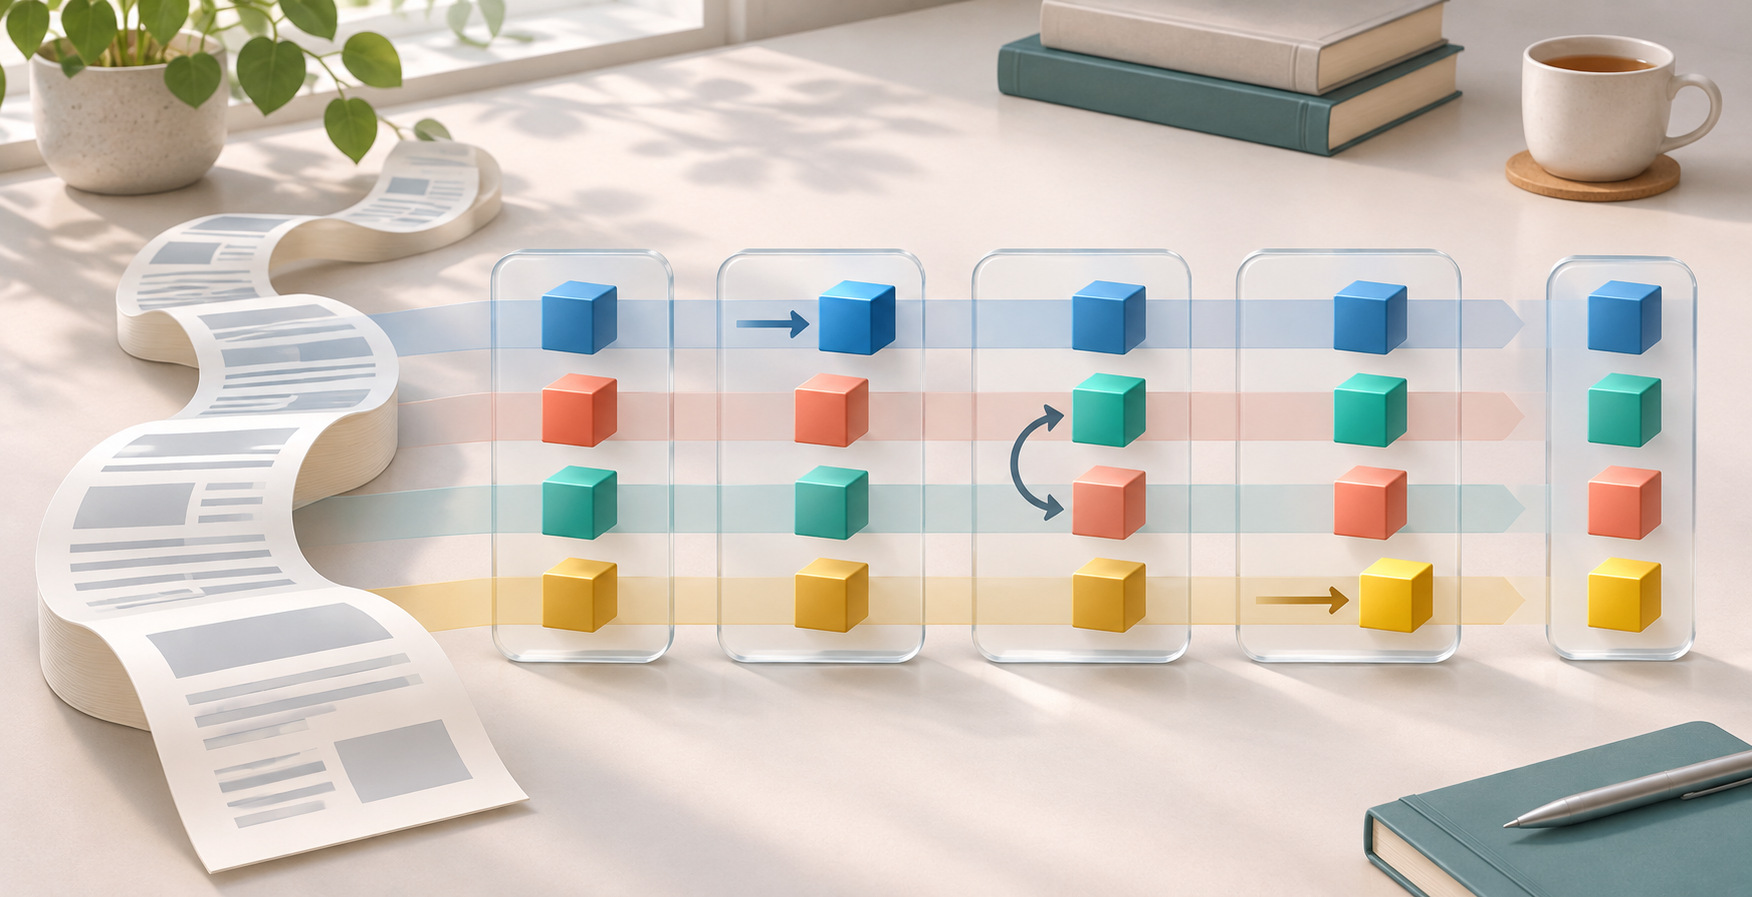
四类任务:差别在更新关系,不只在文本长度
StateBench用有限个变量和有限取值构造更新序列。以下例子帮助理解四级难度;它们不是对任意程序进行分类的通用判据。
| 论文中的类别 | 典型构造 | 回答最终值需要保留什么 |
|---|---|---|
| r-trivial | 变量取值保持不变 | 恢复原始值即可 |
| aperiodic | 按常量重写,如x←4,随后x←2 | 找到该变量最近一次有效赋值 |
| soluble | 在自身当前值上累加,如x←(x+3) mod 100 | 沿更新顺序累计状态,不能只抄最后一个常量 |
| general finite | 构造包含跨变量复制或交换的序列,如x与y交换 | 继续追踪变量之间传递的当前值 |
这里的“引用赋值”有一个容易误解的边界:仓库说明,x←y复制的是执行那一步时y的值,不是建立永久别名。之后再修改y,不会自动让x随之改变。
研究先生成最一般的有限状态追踪序列,再替换其中操作,得到较简单的对应样本。这样能够控制变量数、不同取值的数量和赋值位置,减少“难任务只是文本更长”的混淆。数据可呈现为整数代码、电子表格、方块涂色等六种文本格式,但并非所有格式都支持全部四级:仓库中的自增类任务需要相应的整数或表格格式。
250倍指赋值次数,不能换成上下文窗口
作者从随机初始化开始,专门训练六种架构的2.75亿参数模型,包括两种Transformer、两种Gated DeltaNet(GDN)及两种混合模型。训练序列含8至256次赋值,评测最长达到64,000次赋值。64,000÷256=250,因此“250倍”比较的是最大赋值次数,不是token窗口扩展、推理提速或商用模型能力增长。
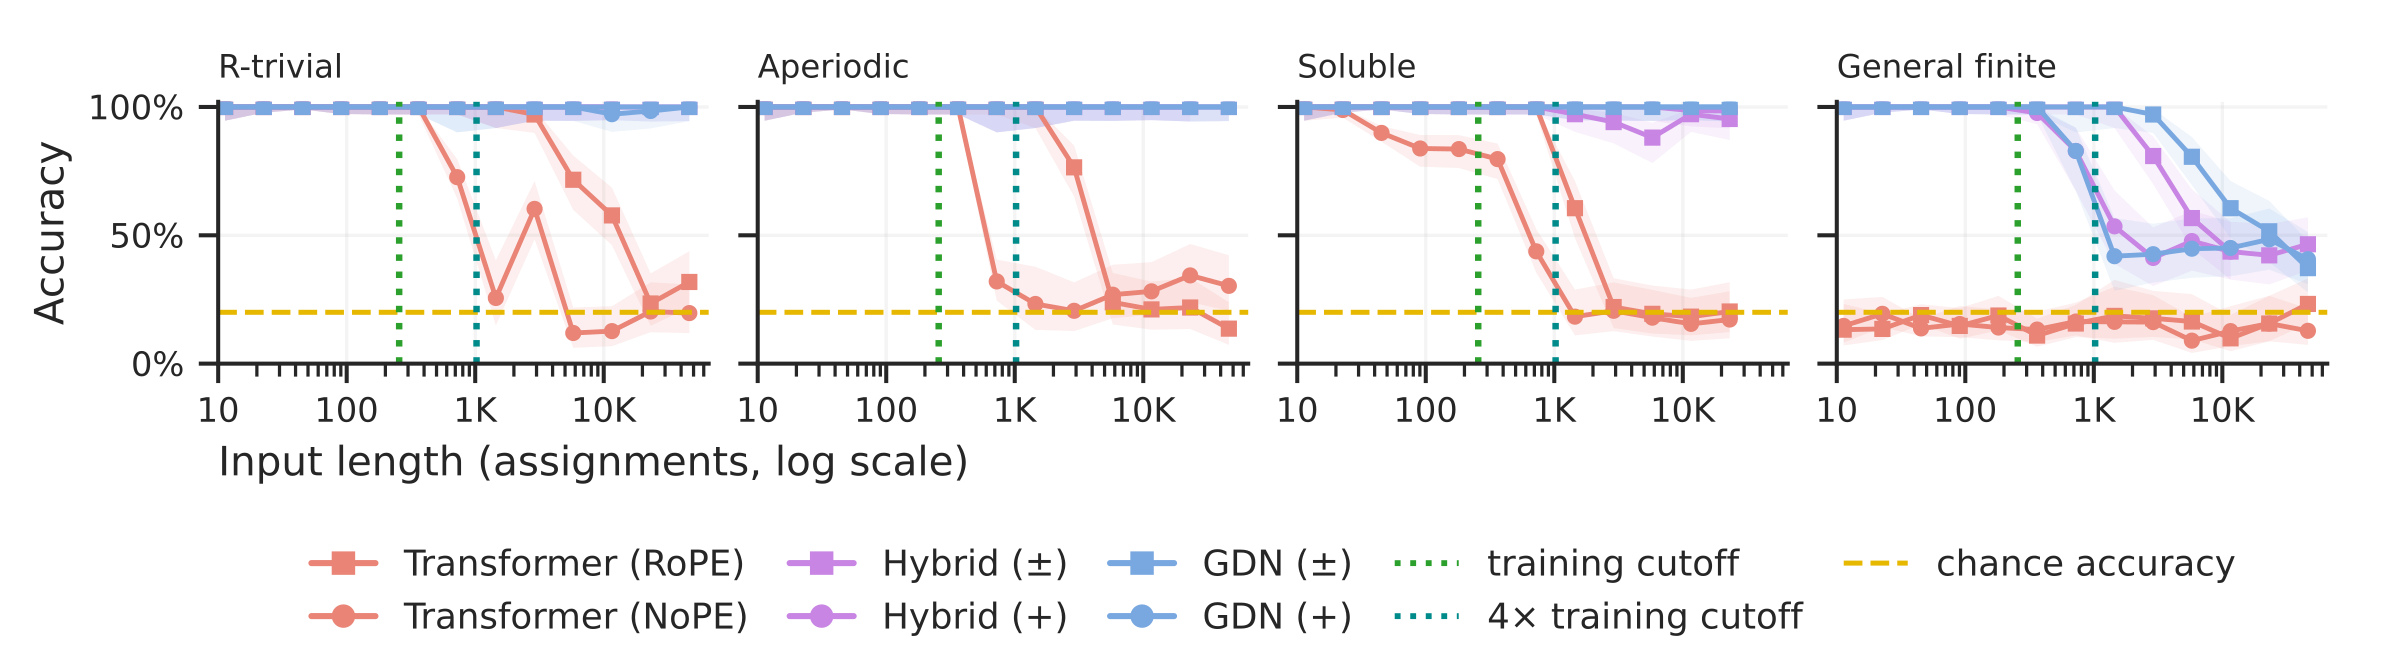
论文报告,在前三类任务上,GDN及混合架构能在远超训练长度的序列中保持接近满分;到了general finite,外推明显更困难,部分版本约达到训练长度的10倍后开始退化。这说明架构和更新关系都影响结果,但不能从这组任务训练实验推出“所有循环模型都能处理任意长程序”。
三组实验,三个需要保留的比较条件
| 实验组 | 长度与训练条件 | 读结果时要保留的条件 |
|---|---|---|
| 直接训练 | 8—256次赋值训练,最长64,000次赋值评测 | 专门训练过该任务;不能当作通用助手的开箱表现 |
| 开放预训练模型 | 预训练及中间训练上限8K token,长上下文扩展至64K,评测到128K | 论文图5取各格式准确率的最大值,不是六种格式的平均值 |
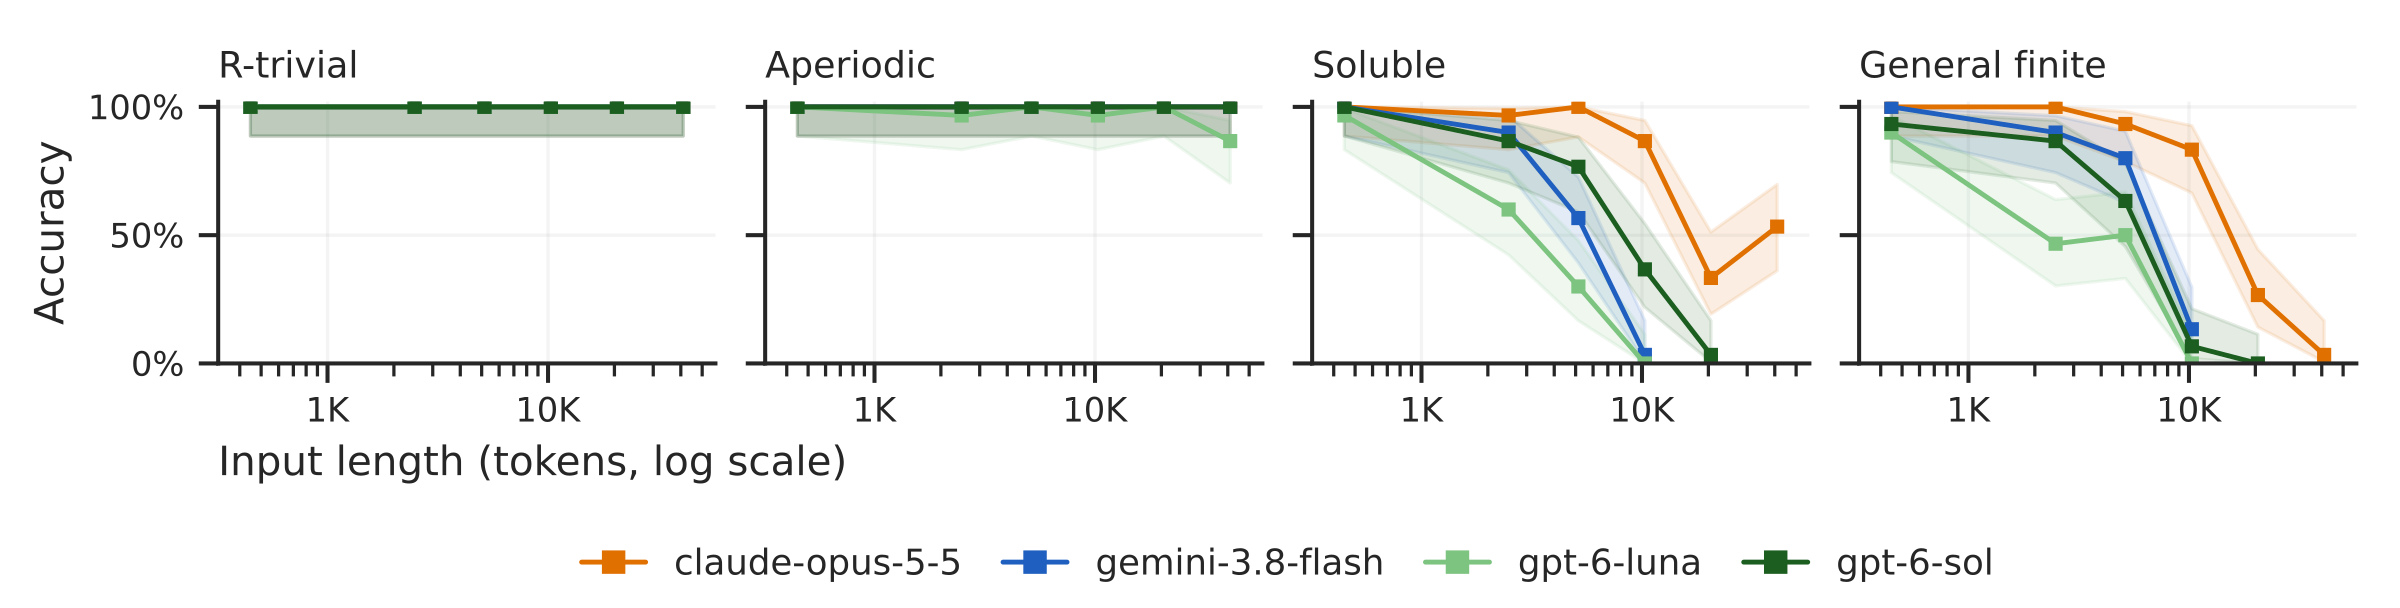
| 前沿模型 | 以输入token数分档,直接生成最终状态 | 与五选一答题不同;不能直接套用选择题20%的随机基线 |
论文图6评测的是作者所用版本的Gemini 3.8 Flash、Claude Opus 5.5、GPT-6 Sol和Luna。作者报告,前两类任务总体较强,涉及累积或跨变量依赖的后两类任务则随长度增加出现明显下降,尤其在约10K至64K token范围。这里的K按千计,长度单位已经变为token,不能与上图的赋值次数直接相除。
另一个实际影响选型的细节是文本呈现格式。在开放预训练模型实验中,同一底层序列改写为RULER式检索文本或电子表格操作,小模型的表现可能相差很大。因此,某一种检索模板上的高分,不能替代对表格更新或多轮任务记录的测试;图5选择各格式最大值,也不能解释成所有格式都达到那个分数。
用于长对话或智能体选型,还缺什么验证
StateBench目前提供的是合成任务上的实验和理论分析。每个问题的变量集合固定,现实对话却可能不断引入新人物、新物体或新约束;当前框架不能直接覆盖这种无限增长的状态空间。它也没有给出某个真实业务流程的部署成功率。理论结论依赖模型形式与数值精度等假设,不能直接宣判所有实际大模型的能力上限。
本文据此认为,可把业务评测拆成三步:先区分“找最近值”“累积自身变化”“跨对象传递变化”,再对齐输入长度、更新位置和文本格式,最后注明是选择答案还是生成完整状态。这样得到的失败样例,才更容易判断问题来自检索、计算还是状态依赖。关于任务版本和执行条件如何改变分数,也可参阅本站的Terminal-Bench 2.1评测分析。
来源与资料说明
- Ai2:StateBench研究介绍,来源发布日期:2026年11月3日,页面未标注具体时间和时区。
- 原论文:A Fine-Grained Hierarchy and Benchmark for State Tracking in Language Models(v1);论文全文与图表。arXiv提交时间:2026年11月2日13:12:15 UTC(北京时间21:12:15);首次公开可读的精确时刻未据此确认。
- 作者代码仓库与README、公开数据集,为持续更新资料,当前页面未提供可统一采用的首次发布日期;用于核对赋值语义、任务格式与数据结构。本文未运行模型或复现实验。
资料核验时间:2026年11月16日09:11(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。