NEWS & INSIGHTS
Benchleaking研究:复现测试题后,模型分数如何重算
北京时间2026年11月17日凌晨,一篇名为Benchleaking的预印本提交arXiv。Yiwei Qin等8位作者报告,对四个公开基础模型进行续写探测时,部分模型会复现未出现在输入中的完整测试题及参考答案。对正在比较AI模型的读者,值得核对的问题是:发现这类匹配后,榜单分数到底怎样重算,又能说明什么?
本文依据该项目的原论文v1整理。arXiv记录的提交时间为11月16日16:10:16 UTC,换算为北京时间11月17日00:10:16;提交时间不等于已确认的首次公开可读时刻。以下结果均归因于作者实验,本文没有取得独立复现证据,也没有访问模型的训练语料。
探测复现测试题,和测量答题能力分两次运行
研究比较的是ERNIE-5.5-Flash-Base、DeepSeek-V4-Flash-Base、Hy3-preview-Base和MiMo-V2.5-Base四个基础模型,不是它们所有聊天产品或后续版本。作者覆盖20项基准,包括知识、常识、数学、代码等任务。
续写探测会关闭停止字符串与EOS停止,使模型在答完当前题后继续生成,直到达到输出预算。研究只在同一基准的测试集中查找匹配,排除当前输入题及已给出的示范题。这一步用于形成匹配清单;原始分数来自另一组按正常停止条件运行的评测,不能把两次运行混成同一个成绩。
| 口径 | 作者实际检查什么 | 不能据此直接推出什么 |
|---|---|---|
| L1 | 完整题目字段被复现 | 只见到相似话题也算匹配 |
| L2 | 在L1之上,选项、段落或公开示例等附加字段也匹配 | 可把不同生成题的字段拼成一个匹配 |
| L3,正文采用 | 再要求参考答案或实现也匹配;统一大小写与空白后比较 | 答案等价、改名代码或同义改写也算完整复现 |
对于HumanEval,L3要求完整题面与参考实现匹配;写出另一份能通过测试的代码不算这种匹配。作者表4报告,ERNIE-5.5-Flash-Base在此探针下的HumanEval匹配覆盖率为96.3%,OpenBookQA为85.4%。这些比例的分母是相应测试集的不同样本数,同一题被多次复现只计一次;它们不是模型错误率,也不是训练语料中被污染的比例。
Anti-Hack把命中样本记零,保留原分母
作者将匹配清单对应到正常评测记录,把检出样本的单题得分设为零,再保留原样本总数重算。本文用一个说明算法的假设例子区分分母:100题原本答对80题,其中10道正确题被检出,记零后的分数是70/100=70%;如果把这10题从分母删掉,则变成70/90≈77.8%,那是另一种指标,不是本文所述Anti-Hack口径。
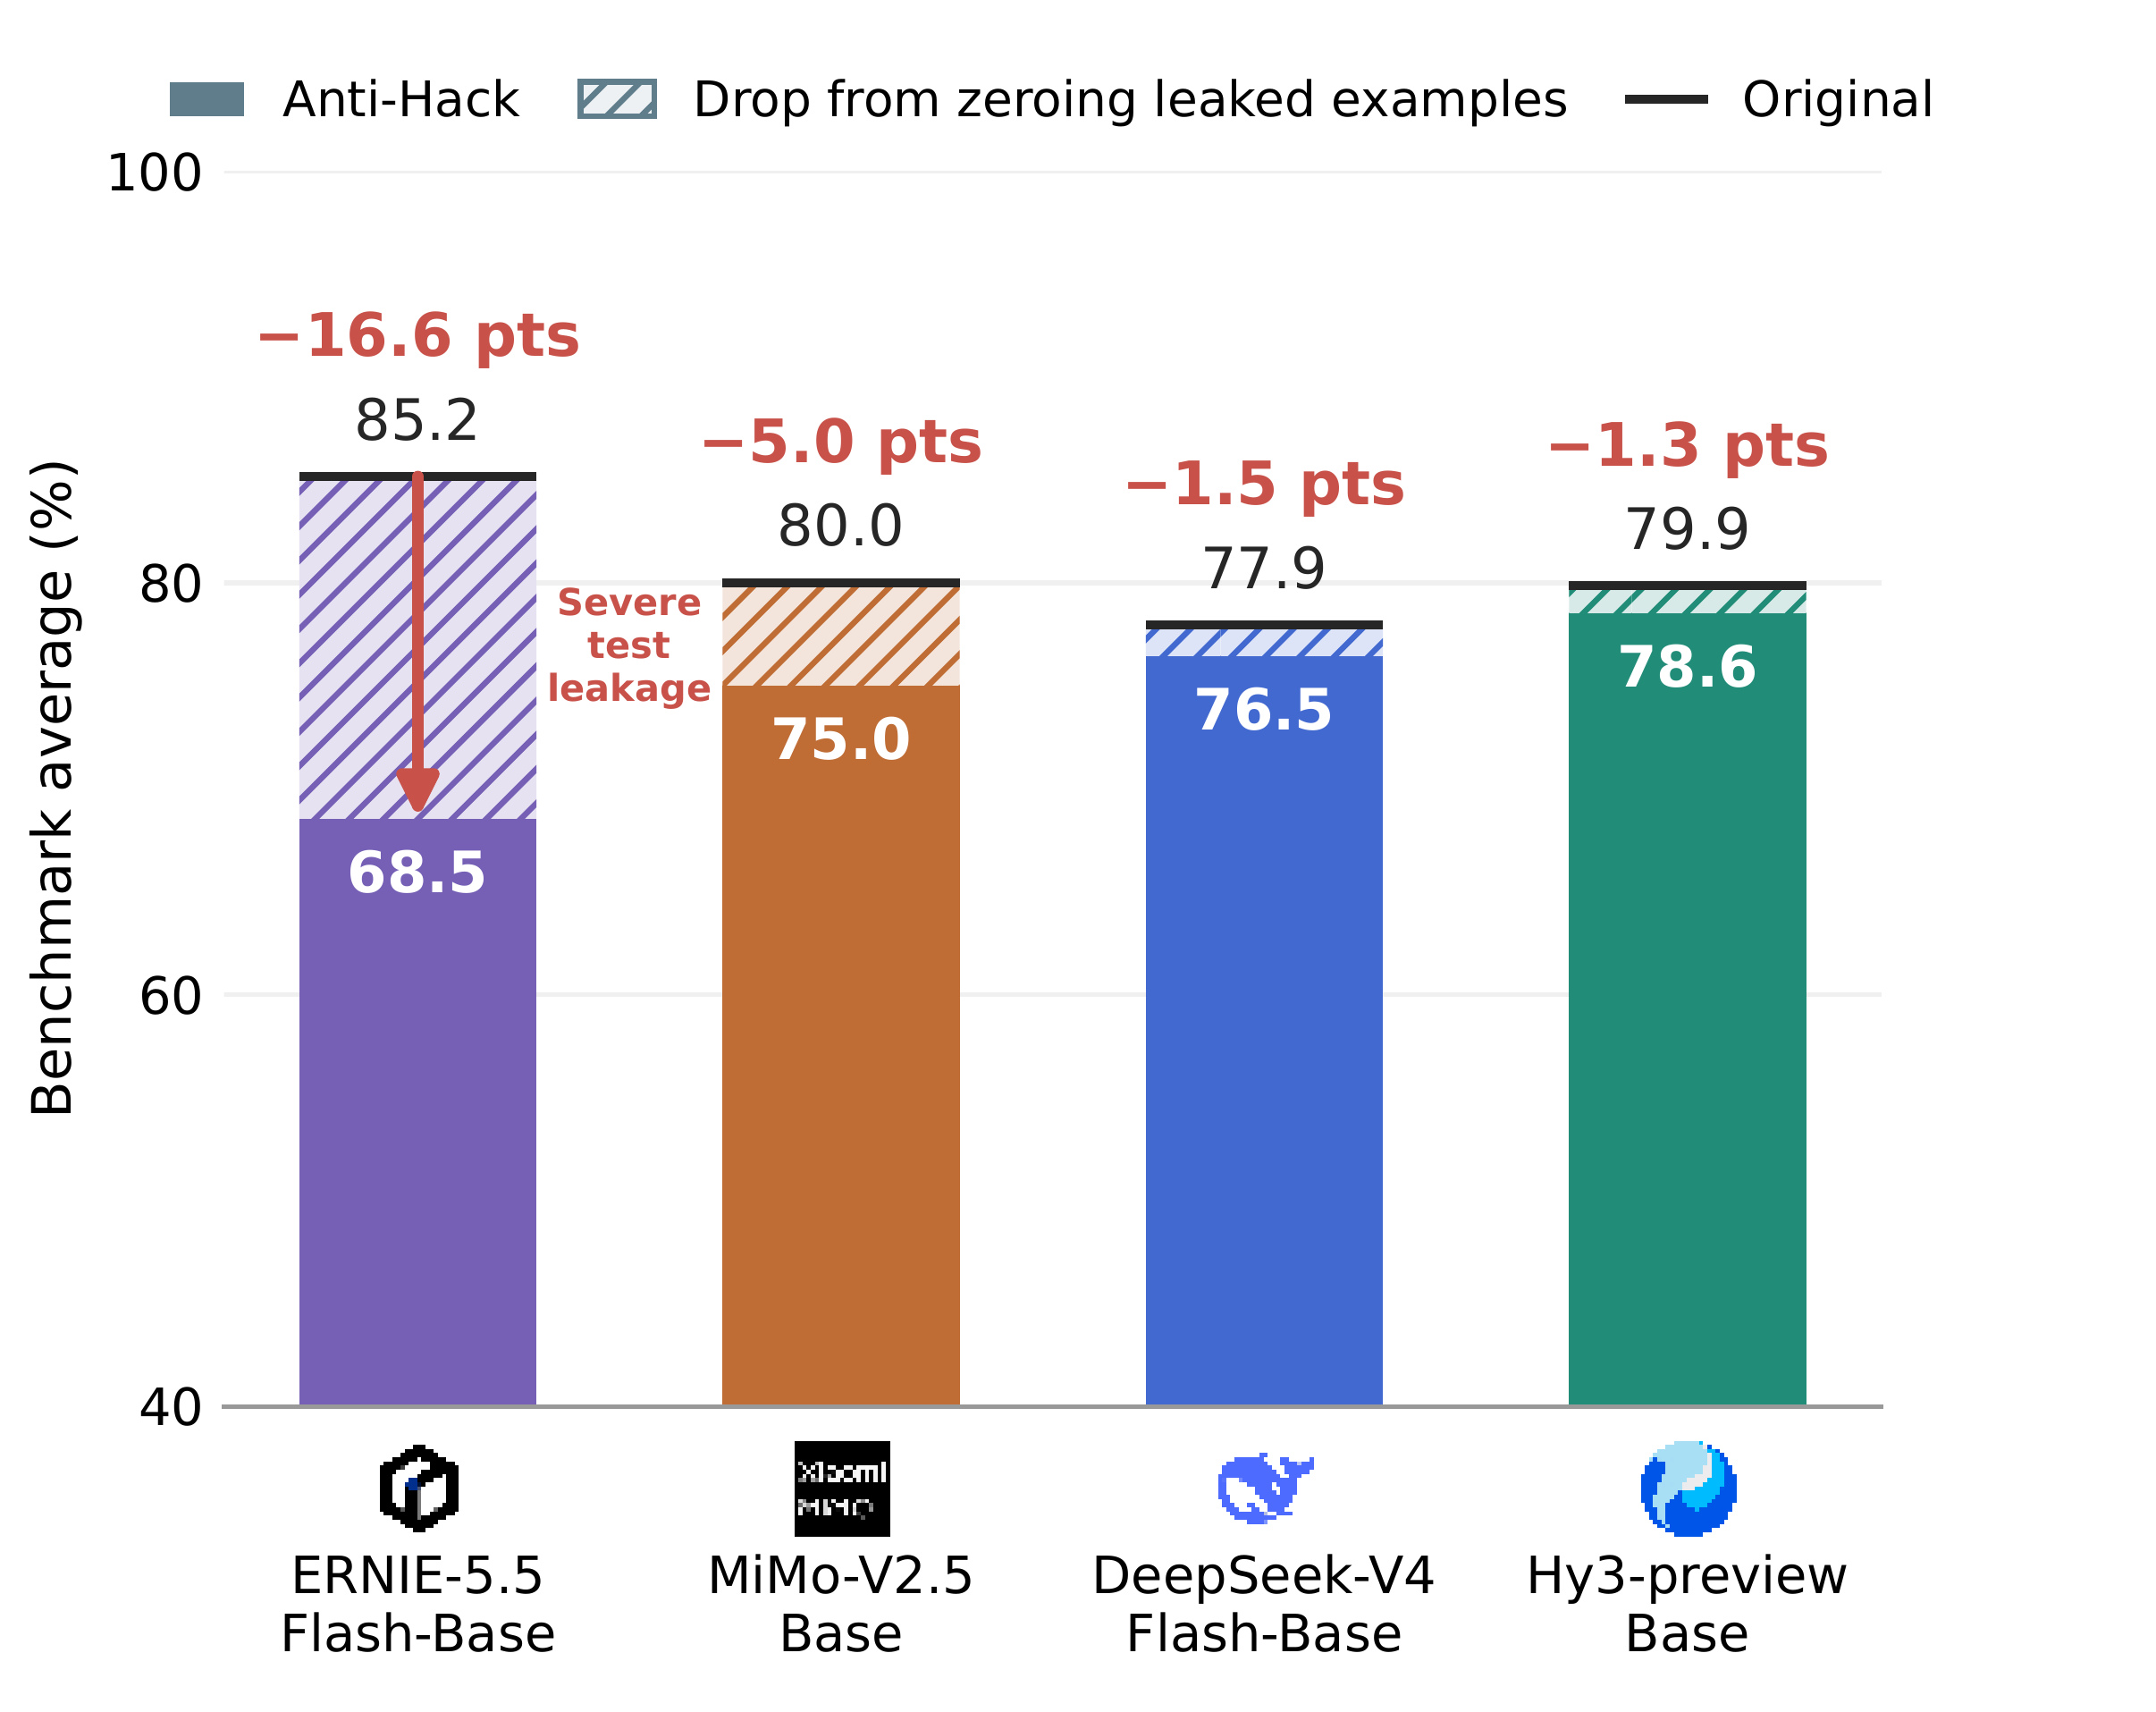
原论文表9给出以下百分制综合分。最后一列由本文按表中两数相减,保留两位小数;图1则显示一位小数。整体分数是20项基准得分的等权平均,不是把所有题合并计算的单一准确率。
| 作者评测的基础模型 | 原始综合分 | Anti-Hack综合分 | 分差(分) |
|---|---|---|---|
| DeepSeek-V4-Flash-Base | 77.95 | 76.48 | 1.47 |
| Hy3-preview-Base | 79.86 | 78.55 | 1.31 |
| MiMo-V2.5-Base | 80.01 | 75.03 | 4.98 |
| ERNIE-5.5-Flash-Base | 85.17 | 68.55 | 16.62 |
四者在这组基准下的排序因此改变,但不能把它改写成对所有模型、所有任务的通用排名。不同基准的指标也有区别:DROP使用F1,HumanEval与HumanEval+使用每题四次采样通过比例的平均值(Avg@4),不是“试四次只要成功一次就算满分”。
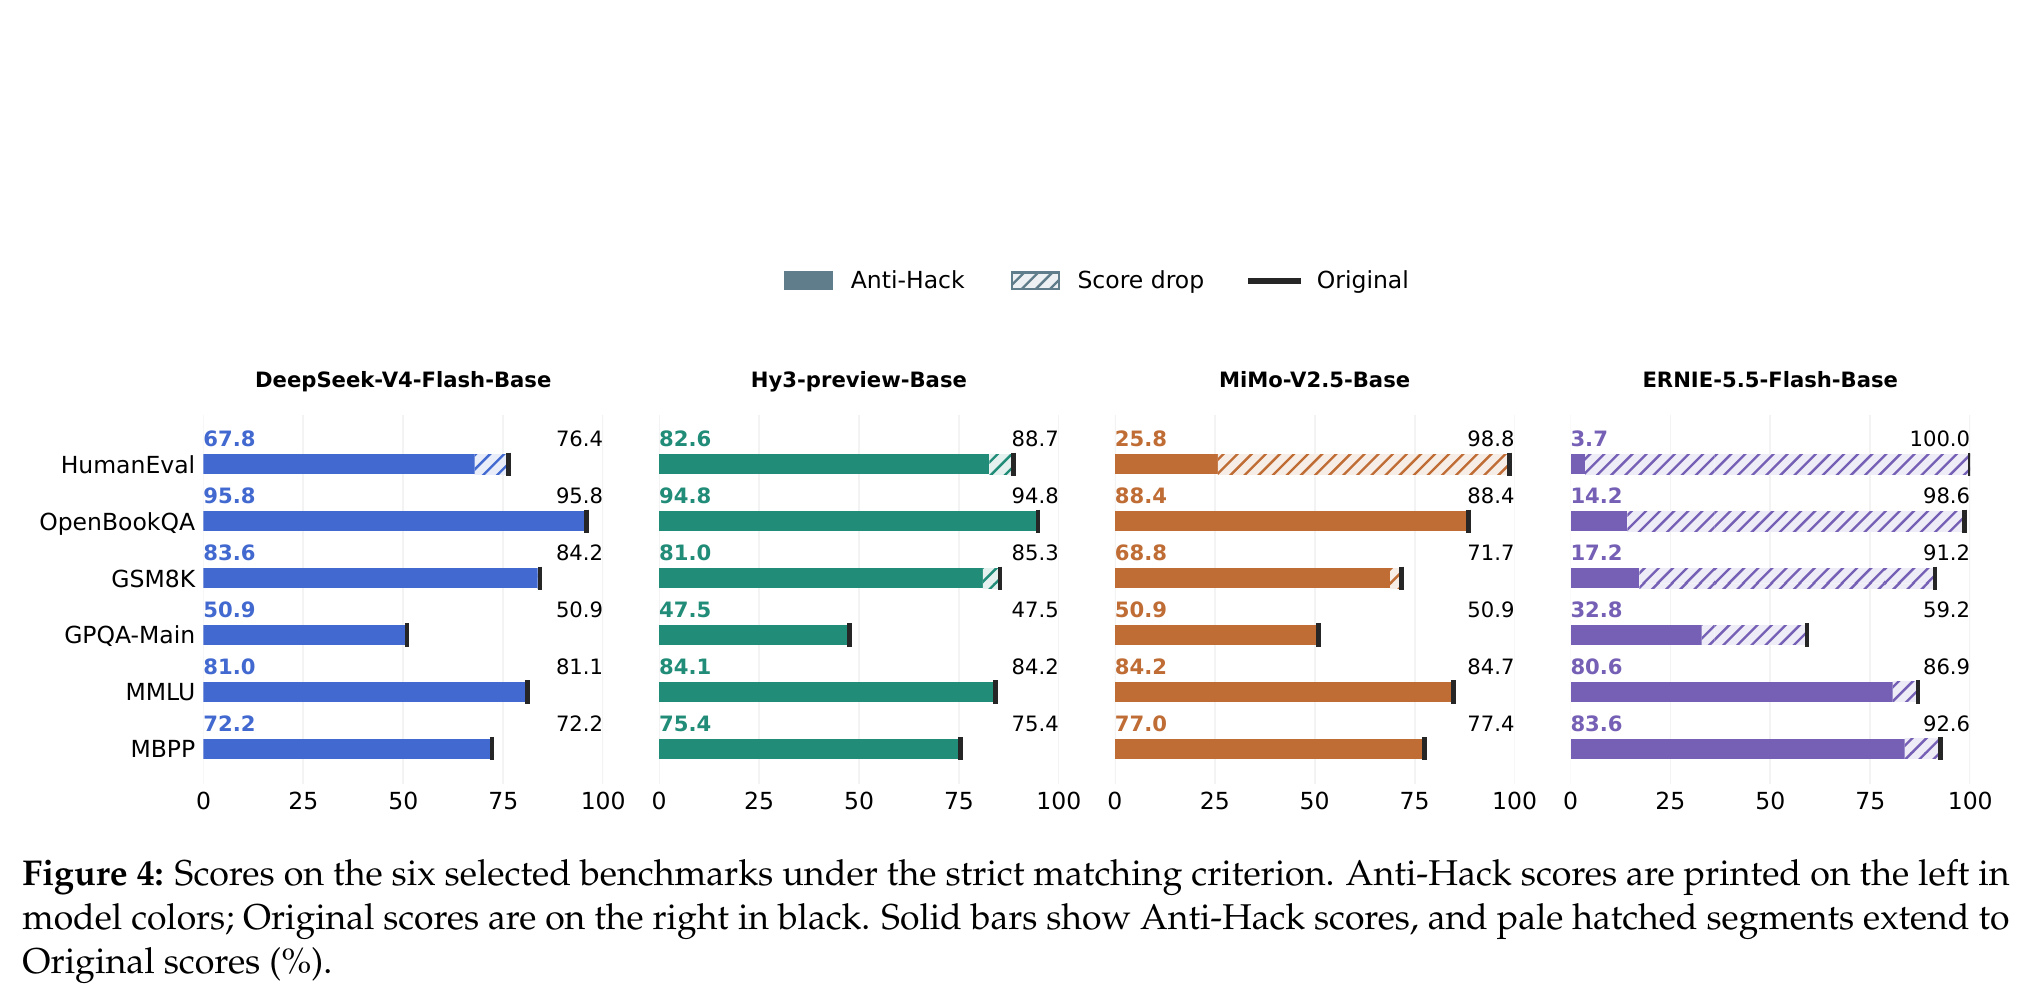
三项限制决定这些数字怎样用于选型
代码题的最高分来自多个提示模板
论文附录F.3说明,HumanEval系列测试三种模板,MBPP系列测试两种。匹配清单会汇总不同模板的检出项,应用到各模板的正常评测后,再取调整后最高分。因此,表中代码分数既不是单一提示词的表现,也不一定来自扣分前相同的最佳模板。直接拿它与另一份评测报告比较,应先对齐提示、采样和计分条件。
匹配并不总是同样强的暴露证据
作者在附录A特别指出,WinoGrande的孪生句只差一个词、答案相反,看到一题可能推得另一题,因而该项12.6%至14.4%的匹配不应直接读成泄漏证据。表9仍列出该项调整后的得分,阅读综合平均时也应保留这项限定。反过来,探针检出率为零,也只表示这一组提示与生成预算下没有检出,不能证明训练过程完全没有见过测试内容。
记零是一种保守计分规则,不是真实能力测量
本文据此认为,Anti-Hack衡量的是:在作者检出的匹配样本一律不计分后,原成绩还剩多少。它不能证明这些题若从未进入训练,模型就一定答错;本文也不能由续写结果确定接触测试内容的具体路径,或推断开发者是否有意使用。论文给出的项目入口在资料核验时未能公开访问,本文尚未从该入口取得代码和完整请求日志进行复现。
实际选择模型时,可把原始成绩、匹配规则、命中清单和新编或改写任务上的测试放在一起审视,再判断结果是否适用于自己的工作流。关于评测条件如何影响分数,也可参阅本站的Terminal-Bench 2.1评测维护分析。
来源与资料说明
- 原论文v1与提交记录:Benchleaking Is Accelerating;HTML全文、PDF全文。来源提交日期:2026年11月16日16:10:16 UTC(北京时间11月17日00:10:16);首次公开可读的精确时刻未据此确认。主要依据第3节、表4、表9及附录A、F.2、F.3。三种页面属于同一一手来源,不是三份独立证据。
资料核验时间:2026年11月18日09:03(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。