NEWS & INSIGHTS
RoboTeam研究:多机械臂协作的完成率与重试成本
2026年11月17日提交arXiv的RoboTeam预印本,用4至16个机械臂、36项仿真任务,检验AI智能体能否在“思考时模拟世界仍继续运行”的条件下完成协作。对准备评估机器人智能体的读者,研究提出一个实际问题:任务最终做完,是否也意味着过程可靠、时间和计算用量可接受?
论文由Changxuan Fan等21位作者完成,署名机构为香港科技大学及微软。v1提交时间为11月17日03:24:06 UTC,即北京时间11月17日11:24:06;提交时间不能据此当作首次公开可读的精确时刻。以下数值均归因于该项目的作者实验,本文未运行基准,也没有独立复现。
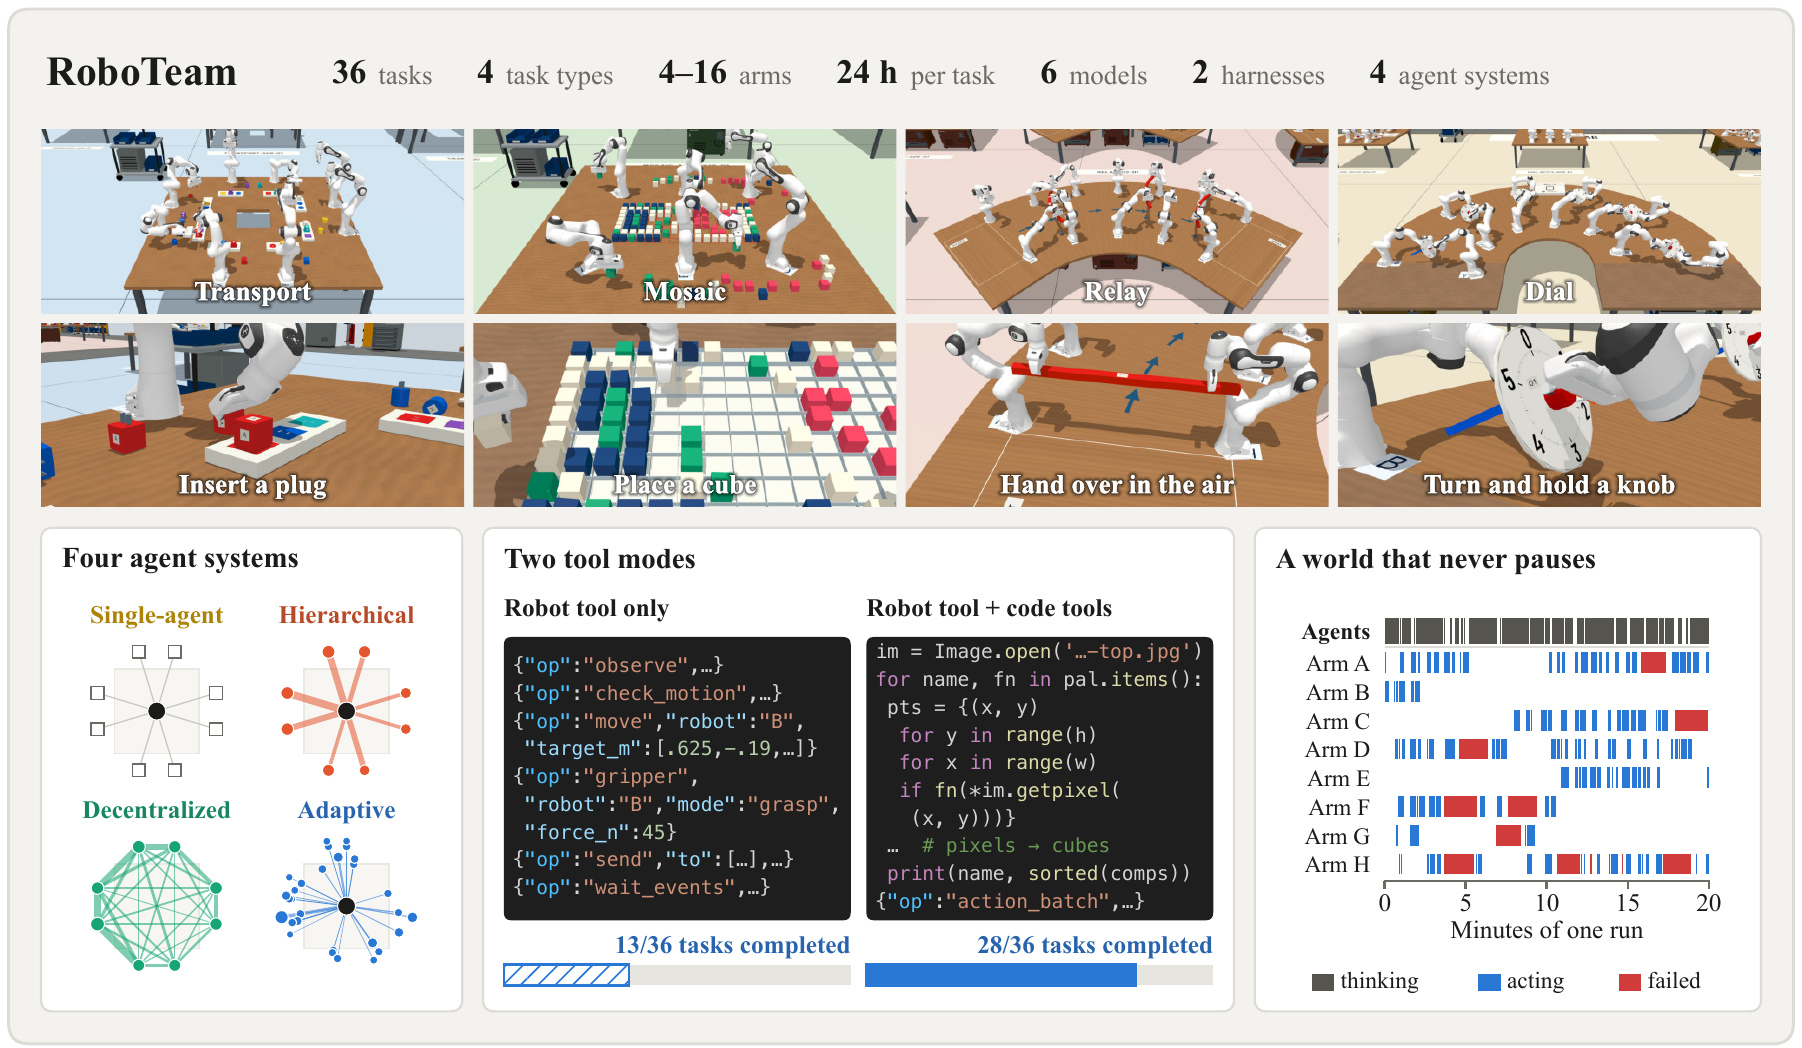
“实时”描述世界继续运行,不是毫秒级控制保证
36项任务由运输、拼图、接力和旋钮四类工作构成,每类有三种队伍规模与三个难度。机械臂需要共享空间、传递物体或互相支撑;“多臂协作”并不要求每个臂都由一个独立语言模型控制。
智能体能够读取相机RGB图像、相机参数和机械臂自身状态,但标准视觉条件不提供物体位置真值、深度或接触信息。动作通过受限机器人工具发出,代码工具则允许智能体在图像中测量位置、编写控制脚本和保存工作文件。
论文中的“实时”指模型推理时仿真不暂停,并不表示模型具有硬实时响应能力。每次运行最多24小时有效活动时间;网络故障等基础设施暂停发生时,世界、智能体和计时会一起停止。作者也明确说明,这些任务不要求快速反应。
完成任务、步骤失败和抓取失败,是三个口径
在gpt-6.1-sol、Codex和自适应智能体结构这一条件下,作者报告完成28/36项任务。该结构从一个控制器开始,按需分出委派智能体,再回收其控制的机械臂;每个机械臂同一时刻只属于一个智能体。这个结果应连同以下口径一起阅读。
| 指标 | 原论文报告 | 统计含义 |
|---|---|---|
| 完整任务完成 | 28/36项 | 最终状态符合全部要求;允许中途失败后重试 |
| 原子步骤失败率 | 中位数34% | 每个任务中,至少失败过一次的步骤占比;再对36项任务取中位数 |
| 抓取失败率 | 1,205/5,244,约23.0% | 汇总全部抓取尝试的失败比例,不是上述任务内比例的中位数 |
| 时间与输入用量 | 单任务时间中位数3.48小时;正文另报输入中位数2.18亿token | 都是单任务统计量,不能用累计值直接替换 |
原子步骤是任务内的最小进展,例如放好一个方块、交接一次横梁。一步后来重试成功,仍会被记作“至少失败过一次”。因此34%既不是34%的任务失败,也不是34%的抓取失败。
这种差别在接力任务中尤其明显:作者报告其任务内步骤失败率的中位数达到100%,但9项接力任务仍完成8项。仿真中掉落的物体可以再次拾起,这样的最终完成并没有证明实机上的损坏风险或产线中断成本已得到验证。
多智能体节省的时间,换来了多少输入用量
表S3在同一gpt-6.1-sol与Codex条件下比较四种结构。下表时间与输入均为36项任务的累计值;输入由原表的B单位换算为亿token,1B=10亿token。总时长含未完成的运行,自适应结构的258小时中有120小时来自五项达到24小时上限的任务。
| 结构 | 完成任务(/36) | 累计有效时间(小时) | 累计输入(亿token) |
|---|---|---|---|
| 自适应:按需委派 | 28 | 258.0 | 270.1 |
| 层级:控制器加每臂工作者 | 29 | 203.9 | 516.8 |
| 去中心:工作者直接协调 | 29 | 198.7 | 453.1 |
| 单智能体控制全部机械臂 | 27 | 407.3 | 171.2 |
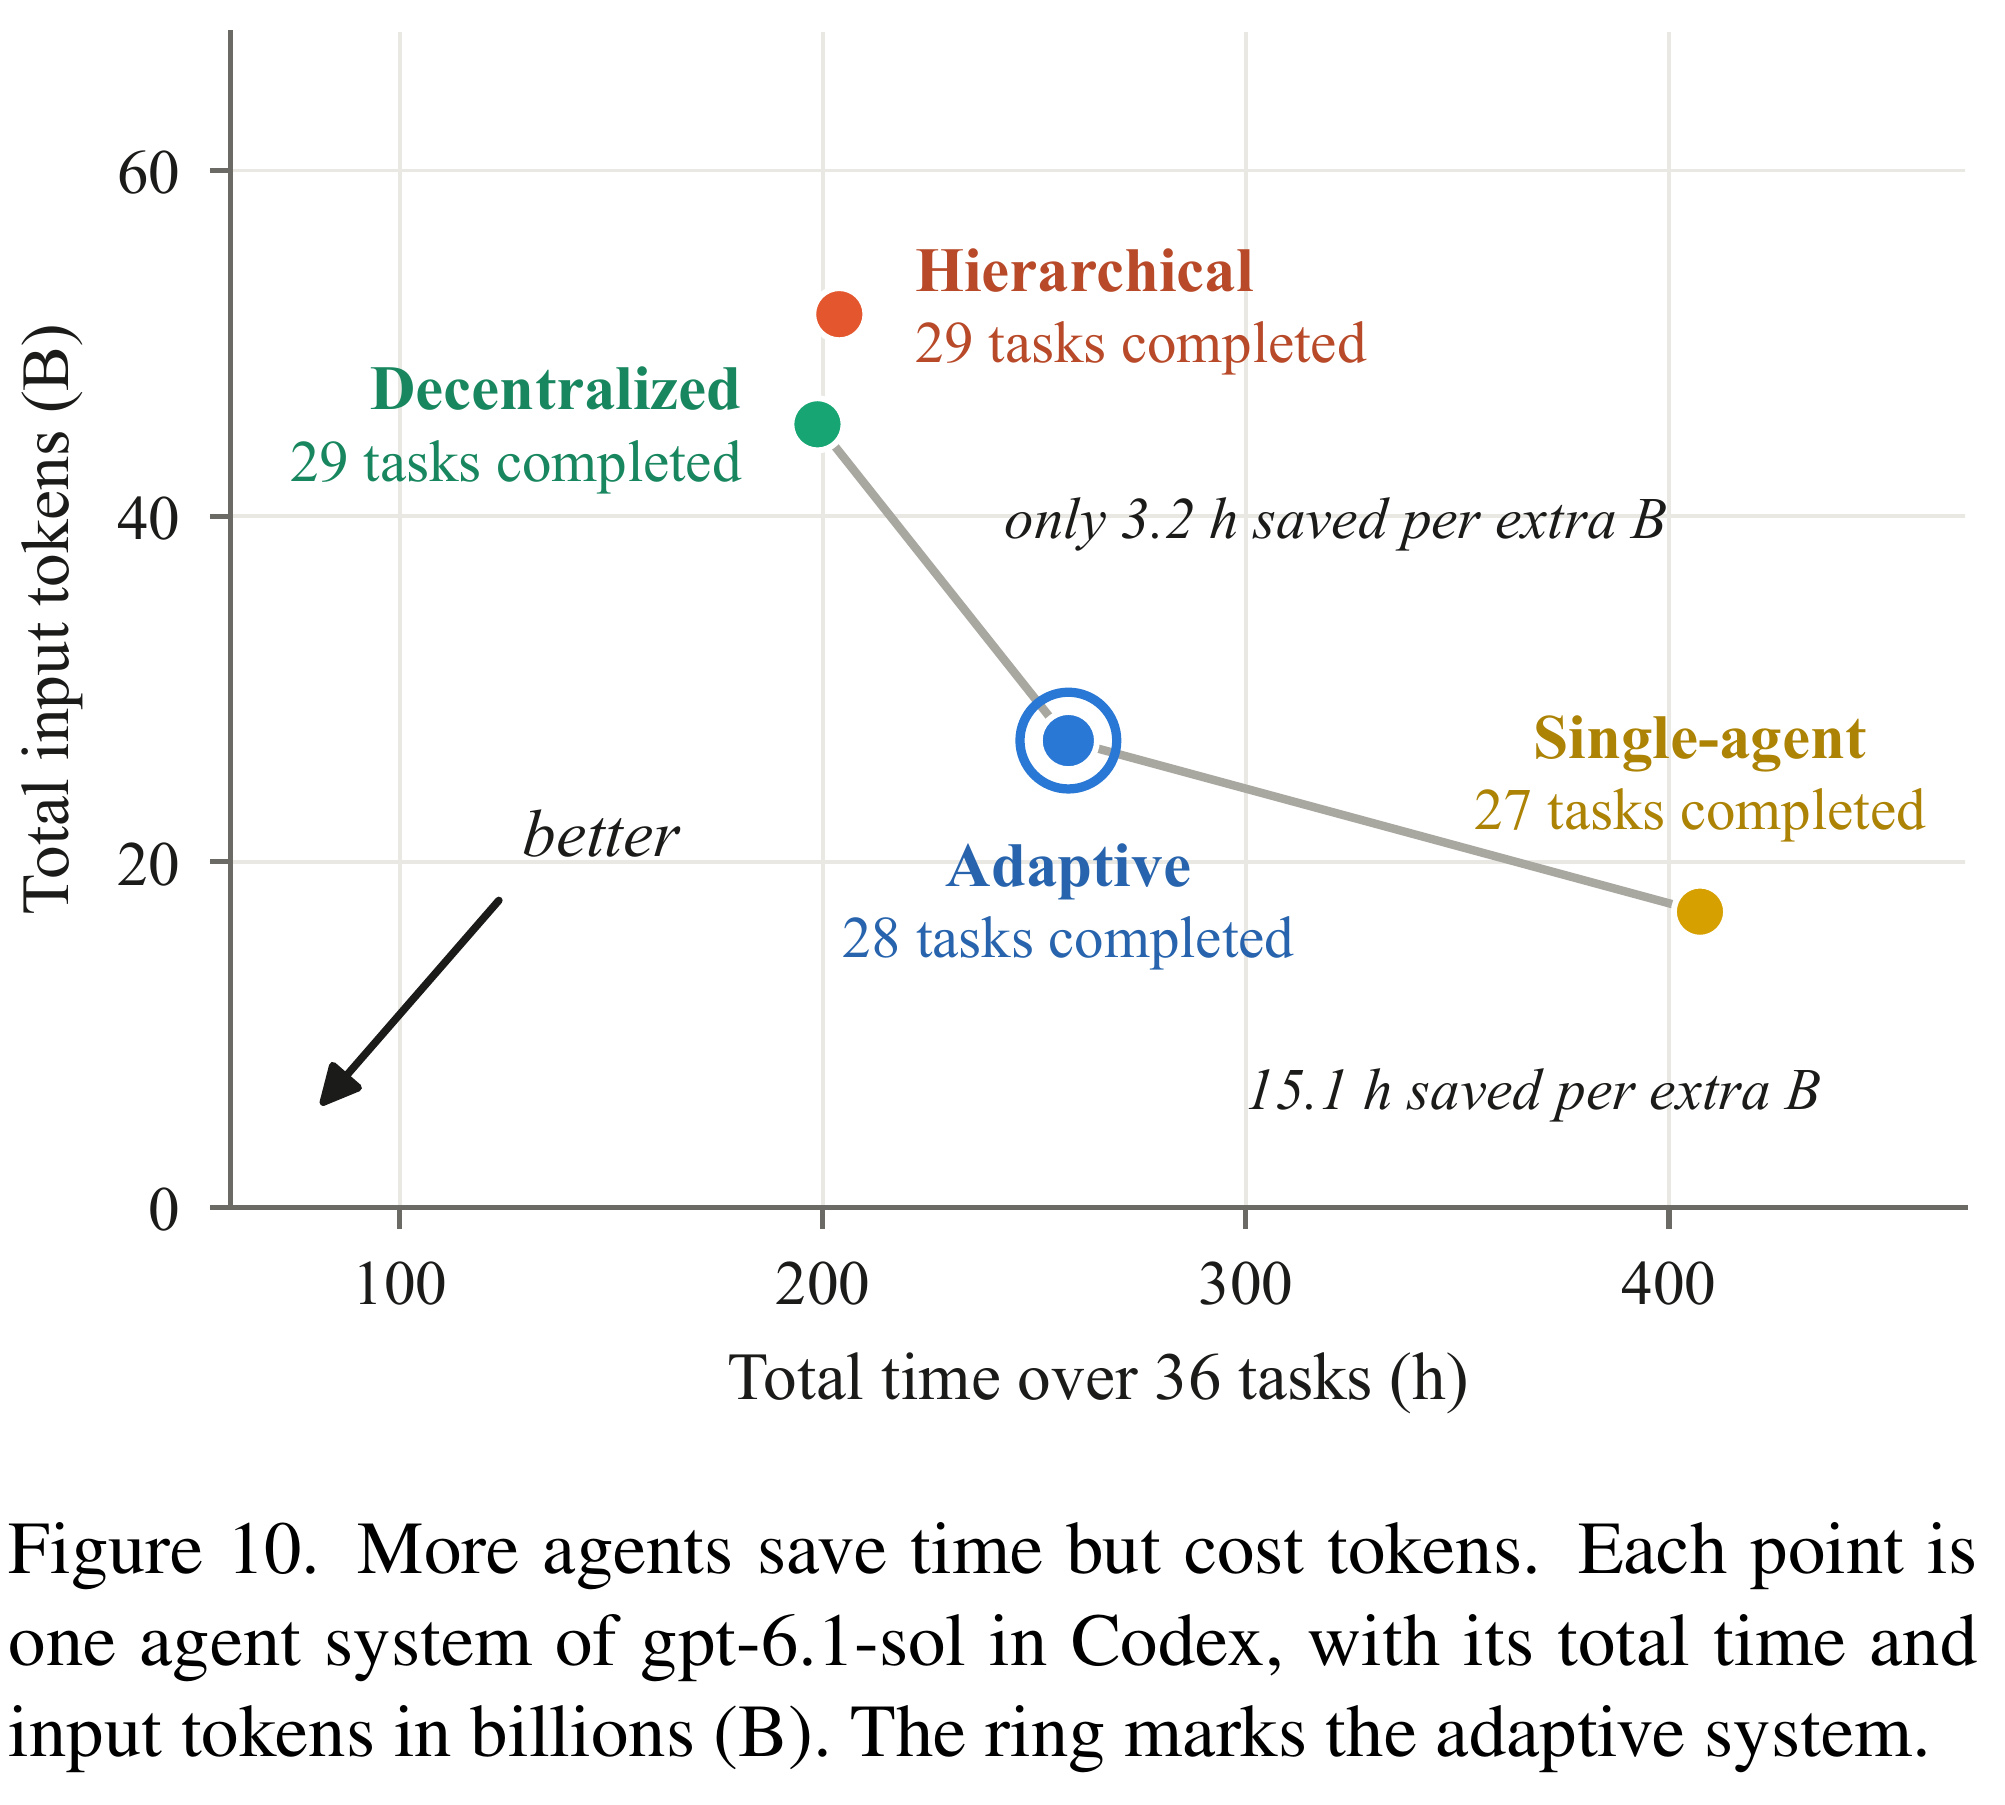
按表中数值计算,层级结构的累计输入约为自适应结构的1.91倍;单智能体的累计时间约为其1.58倍。这是累计值之比。单任务时间中位数8.70÷3.48=2.50又是另一种比较,不能把它与论文摘要的约1.6倍混为一谈。
输入token也不是新信息量或账单金额。自适应结构累计270.1亿输入token中,97.9%来自缓存上下文读取。论文比较的是用量;本文不据此换算API费用。270.1亿是36项任务累计值,正文的2.18亿则是单任务中位数,二者不是同一个统计量。
哪些差距有证据,哪些仍需验证
视觉与工具条件比一项完成数更值得核对
在标准视觉条件下,自适应结构完成28项;把图像降到128×80像素后完成14项,移除代码工具后完成13项。后一项同时拿掉了计算、脚本控制和工作文件,不能把全部下降都归因于某一个图像测量算法。
位置真值参照组(Oracle)完成36项,但它采用的是单智能体结构。如果把它直接与自适应结构的28项相比,会同时改变信息与组织结构。从表S3交叉对照可见,同为单智能体的图像组完成27项,位置真值组完成36项,提供了更接近的输入条件对照;真值仍是实验参照,不是已部署视觉系统可自动获得的能力。
一次运行和四类任务,不支持通用排名
作者主要用一个模型比较结构、工具和分辨率;大部分条件各运行一次。最高难度的12项任务额外重复两次,三次分别完成10、8、9项,因此28与29这类小差异不宜解释成稳定优势。四类任务、单一低分辨率设置和仿真环境,也限制了结论的适用范围;实机迁移仍是未来工作。
本文据此认为,评估协作机器人智能体时,应同时保留最终验收、途中失败、时间预算、输入用量及感知条件。只有最终完成数,无法看出反复恢复和等待是否能被实际流程承受。关于机器人基准的任务范围与统计分母,可参阅本站的VABAR机器人评测分析。
来源与资料说明
- 原论文v1与提交记录:RoboTeam;HTML全文、PDF全文。来源提交日期:2026年11月17日03:24:06 UTC(北京时间11:24:06);首次公开可读的精确时刻未据此确认。主要依据第3—4节、图1与图10、表S3及附录B、I、J。三种页面属于同一一手来源,不是独立复现。附录J写明将发布基准、运行时与运行记录,本文不据此宣称这些材料已开放可用。
资料核验时间:2026年11月19日09:13(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。