NEWS & INSIGHTS
FLUID研究:实时AI指导如何评估开口时机
密歇根大学团队于2026年11月19日17:45:07(UTC,北京时间11月20日01:45:07)提交FLUID预印本,把实时AI指导中的一个问题纳入评测:助手看见用户操作之后,什么情况下应当开口,什么情况下保持安静也合适?这关系到智能眼镜、远程操作指导等应用的使用体验。
研究同时提出证据标注、评测方法和指导智能体。以下结果来自作者团队的实验;论文仍是预印本,尚不能据此认定助手已能在真实用户交互中可靠完成整项任务。
完成一步,不必总接一句
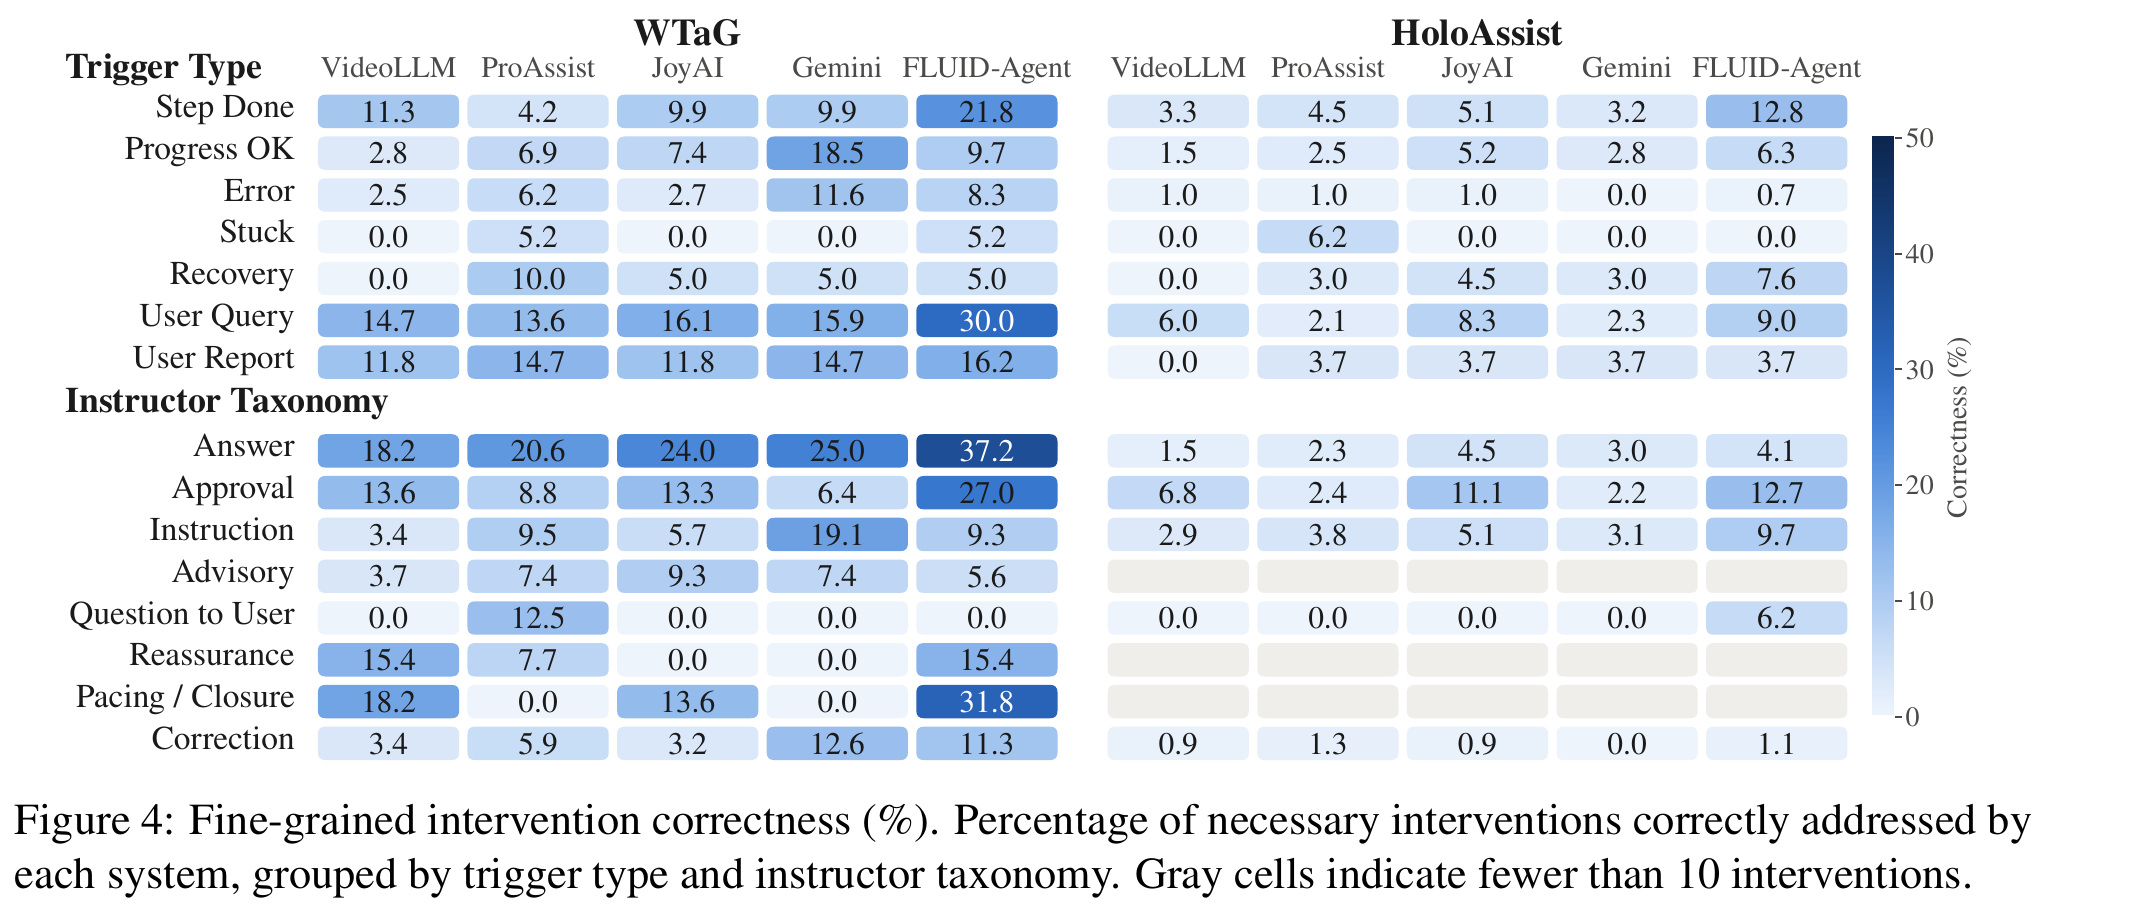
团队选取WTaG的43段会话和HoloAssist的72段会话。这两组第一视角视频都记录人与人的任务指导,但交流方式不同:前者的用户较能自行推进,后者更依赖指导者逐步说明。
这种差异会改变开口的必要性。作者标注的418次WTaG步骤完成中,12.9%随后需要必要指导,69.6%没有干预;HoloAssist的649次步骤完成中,对应比例是65.9%和21.9%。因此,“完成一步就播报下一步”很难成为通用规则。这些是所选会话的描述统计,不代表所有用户的偏好。
把“该说”与“说得及时”分开计分
FLUID为指导语句关联触发它的提问、动作或状态,再标注干预是否必要,以及何时开始仍然有用。回应提问要等用户说完;主动提示则要依据最早迹象、证据充分时刻和最晚有用时刻确定窗口。可选的回应允许不说,不因沉默扣分。
| 指标 | 分母与含义 | 阅读边界 |
|---|---|---|
| 及时正确性 Timely Correctness |
全部必要干预的平均时间得分;内容不匹配、未回应或超出有效窗口计零 | 同时衡量内容与时机,不能换算成用户完成任务的比例 |
| 干预精确率 Intervention Precision |
全部实际播放的系统语句中,内容正确且在有效窗口内匹配必要或可选干预的比例 | 重复、无关或时机不合适的发言都会拉低分数 |
| 语音重叠比例 Speech Overlap Ratio |
用户说话时间中,同时出现系统语音的占比 | 衡量潜在打断;分母不是系统发言时长 |
这组指标能识别两种不同问题:该提醒时没有提醒,以及说了很多却没有帮助。仅比较回答与参考句子像不像,容易把它们混在一起。
智能体把证据、任务记忆和发言决定连接起来
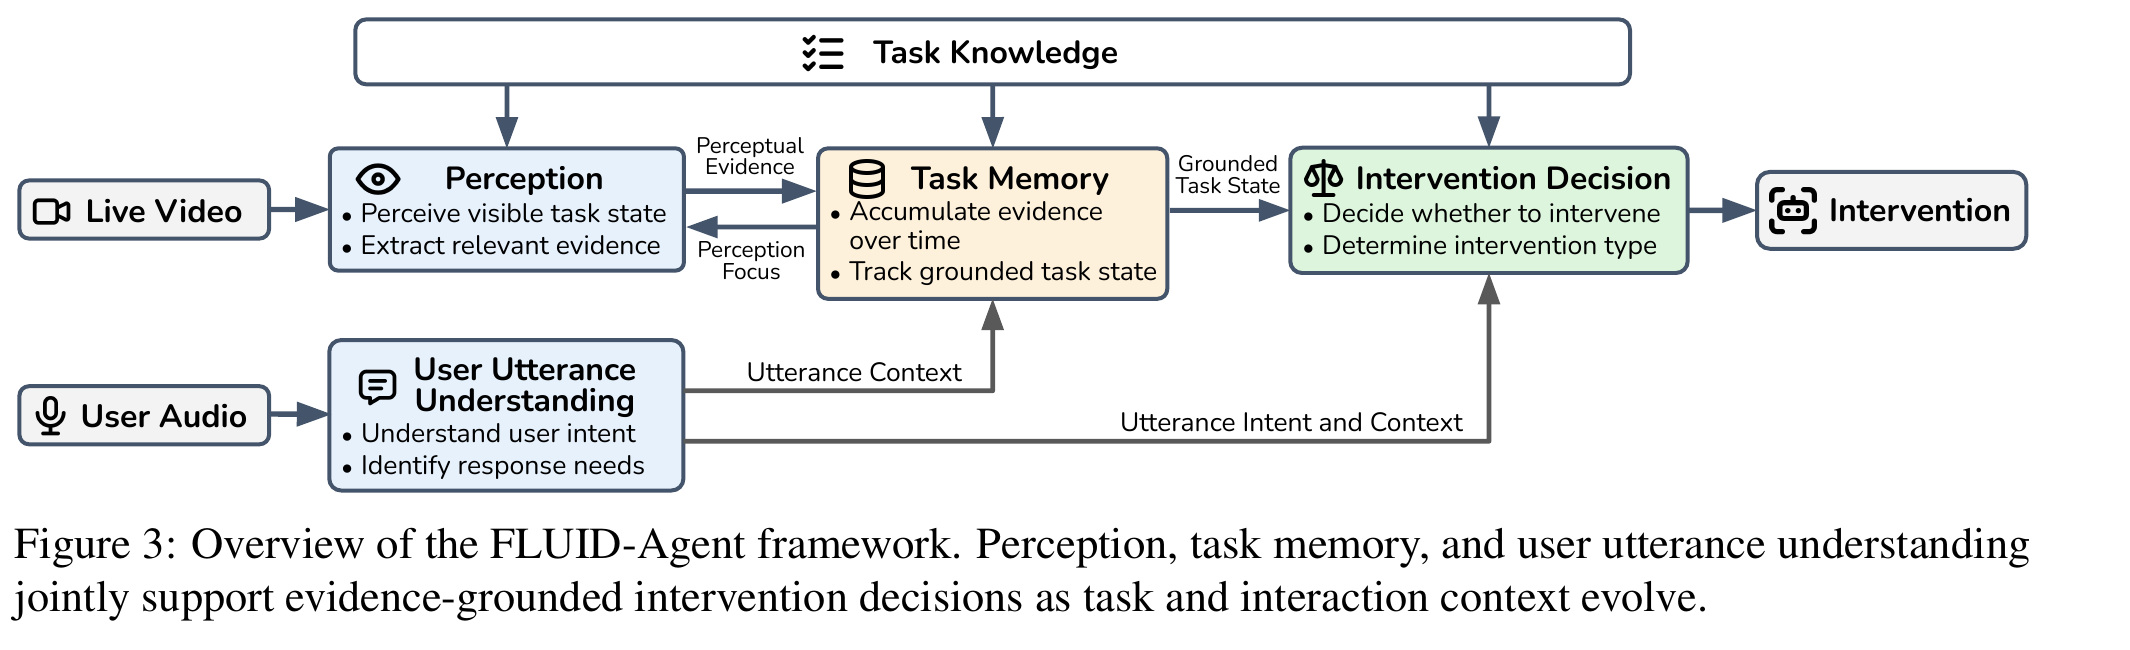
FLUID-Agent以一个冻结的Qwen3.6-35B-A3B视觉语言模型承担在线感知、话语理解和干预推理,通过不同提示执行不同角色。共享任务记忆积累证据与操作进度,外围代码安排调用和轮流发言;过时的待发提示可以取消。这是带有控制逻辑的系统实验,不能把结果全部归于某个模型本身。
主动指导仍明显落后于人类参考
论文表1中,FLUID-Agent在部分指标上较其他受测系统更好,但没有包揽所有指标。下表只对照它与原始人工指导,数值均为0到1的得分;±表示95%会话聚类bootstrap区间的半宽。
| 会话集与指标 | FLUID-Agent | 人工指导 |
|---|---|---|
| WTaG:主动及时正确性 | 0.046 ± 0.015 | 0.921 ± 0.018 |
| HoloAssist:主动及时正确性 | 0.062 ± 0.013 | 0.881 ± 0.011 |
| WTaG:干预精确率 | 0.164 ± 0.022 | 0.845 ± 0.027 |
| HoloAssist:干预精确率 | 0.166 ± 0.024 | 0.833 ± 0.021 |
例如0.046是必要主动干预的平均加权得分,不是“完成了4.6%的任务”。在WTaG上,FLUID-Agent的语音重叠比例为20.7%,Gemini对照系统为5.9%;开口更有依据与更少打断,仍需同时改善。
这些分数能支持什么结论
本次评测以实时速度回放录制的视频与音频,但采用teacher-forced历史:系统此前说的话不重新进入上下文,而是按规则提供人工指导历史。用户也不会因AI的错误或打断而改变下一步行为。因此,它主要隔离评估单次干预决定,尚未验证错误累积时的闭环交互效果。
内容匹配由语言模型裁判评定;两组标注的人工检查覆盖也不同,WTaG全部会话经检查,HoloAssist主要使用机器标注并抽查约10%。此外,系统运行硬件、视频采样和语音处理方式存在差异,响应延迟反映各自部署配置,不能直接解释成模型推理速度的公平排名。
对准备采用实时指导的读者,本文据此建议同时观察漏提醒、不必要发言和语音重叠,并在能够反映用户实际反应的试验中继续验证。关于任务状态是否被正确记录,还可参看本站的StateBench状态追踪研究解读;状态追踪与开口时机属于不同评测问题。
来源与资料核验
- Yunqi Zhao等:FLUID: Flexible, Evidence-Grounded Situated Task Guidance,v1。arXiv记录提交时间:2026年11月19日17:45:07 UTC(北京时间11月20日01:45:07);引用第3—6节、表1及附录B、C、E。提交时间不等同于已确认的首次公开访问时刻。
- 作者团队:FLUID项目页,页面未标明发布日期。它与论文属于同一团队的一手资料,不构成独立复现证据。
资料核验时间:2026年11月21日09:15:02(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。