NEWS & INSIGHTS
ZeroVLN研究:导航学习如何兼顾通用视觉能力
Zixuan Huang等作者于2026年11月19日17:01(UTC,北京时间11月20日01:01)提交ZeroVLN预印本,研究如何给通用视觉语言模型增加导航能力,同时尽量保留原有视觉能力。方案让模型用自然语言提出运动请求,由动作专家执行,再通过强化学习联合改善决策与运动。
对准备复用通用模型的开发者,关键问题是:它省去了什么训练,保留能力的证据又覆盖哪些任务?以下数值均来自作者团队的实验;论文目前为预印本,所引导航结果来自仿真环境。
“零SFT”具体省去了哪部分
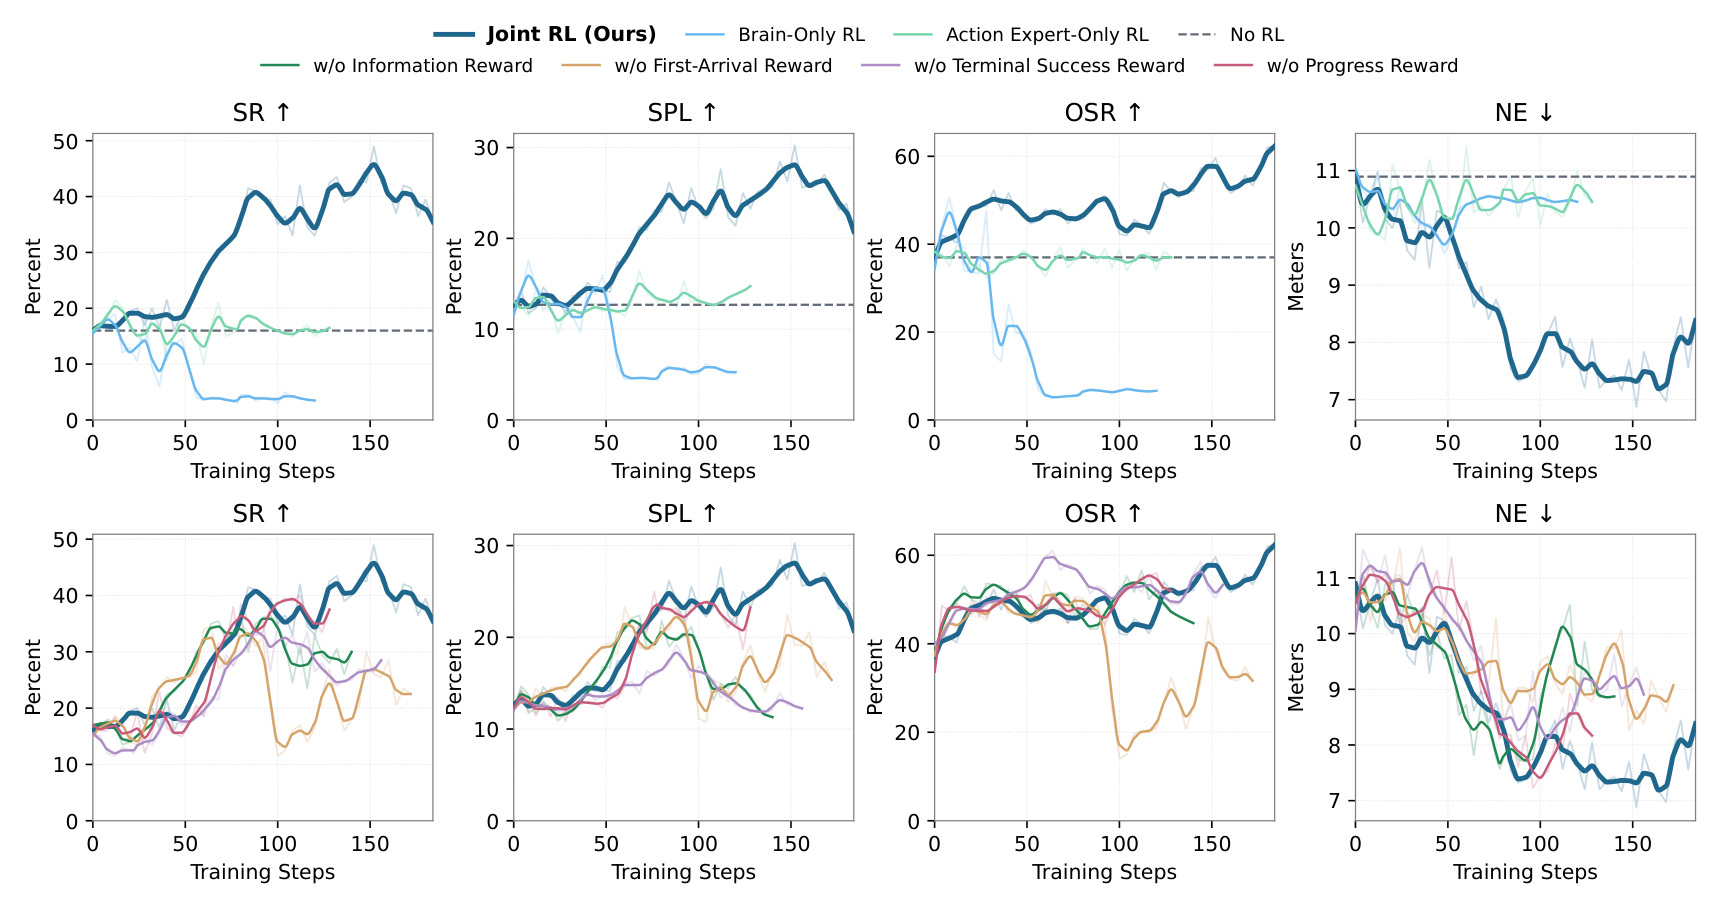
论文主实验以Qwen3.6-35B-A3B为模型本体。SFT是用示范输入输出进行监督微调。ZeroVLN的“零”限定于导航领域对视觉语言模型本体的SFT;系统仍然训练动作专家,也会在联合强化学习阶段更新模型本体。
| 阶段 | 学习内容 | 需要辨清的条件 |
|---|---|---|
| 动作专家适配 | 冻结模型本体和视觉编码器,训练动作专家与可学习查询,使运动符合模型发出的语义请求 | 训练时使用场景网格、语义地图和规划器,生成与请求对应的参考轨迹 |
| 闭环联合强化学习 | 用导航反馈同时更新模型本体的工具决策、可学习查询和动作专家 | 视觉编码器保持冻结;不是全系统参数始终不变 |
| 执行运动 | 动作专家预测16步,先执行前4步,再获取新观测并重新预测 | 训练损失针对实际执行的前缀,余下预测不直接作为一次完整运动执行 |
作者使用34,445个源导航回合作为共同训练池。这里的“无需数据集提供的专家轨迹”也有明确范围:动作监督仍由训练专用规划器产生,只是参考路径要对应模型自己提出的请求。
成功率提高,路径效率仍有取舍
论文在连续导航仿真基准上测试。下表摘取同一模型基座、同一源训练回合池的NaVILA对照与ZeroVLN结果,单位均为%。R2R-CE和RxR-CE的成功率SR要求到达目标并在那里停止;SPL还会按行走路径长度衡量效率。
| 基准 | NaVILA SR / SPL | ZeroVLN SR / SPL | SR变化 |
|---|---|---|---|
| R2R-CE | 46.5 / 41.8 | 52.7 / 29.2 | +6.2个百分点 |
| RxR-CE | 48.7 / 43.0 | 51.4 / 28.1 | +2.7个百分点 |
两组成功率提高,但SPL分别降低12.6和14.9个百分点。作者将这种取舍联系到语义请求带来的探索与受阻后恢复:更容易到达目标,并不保证路径更短。这些受控比较保留了各基线原有的数据扩增、监督构造和训练流程,不能把“同一源回合池”进一步解释为总样本数或总算力完全相同。
“保留视觉能力”要同时看均值和单项
在12项通用视觉与空间测评的自由作答设置中,ZeroVLN的等权平均分为59.16%,基座为59.47%,相差−0.31个百分点。但平均分会掩盖单项退步:RefSpatial的Placement子项从43.00%降到38.00%,Unseen子项从42.86%降到38.96%。因此,接近的平均值不能证明所有能力都无损。
答题格式也是一个变量。作者增加了7项测评、每项100道相同选择题的补充测试:不要求模型生成规范答案,而是直接选取概率最高的有效答案标签。基座答对440/700题,ZeroVLN答对434/700题,准确率分别为62.86%和62.00%。这组结果与前述12项自由作答均值属于不同协议,不能合成一个分数。
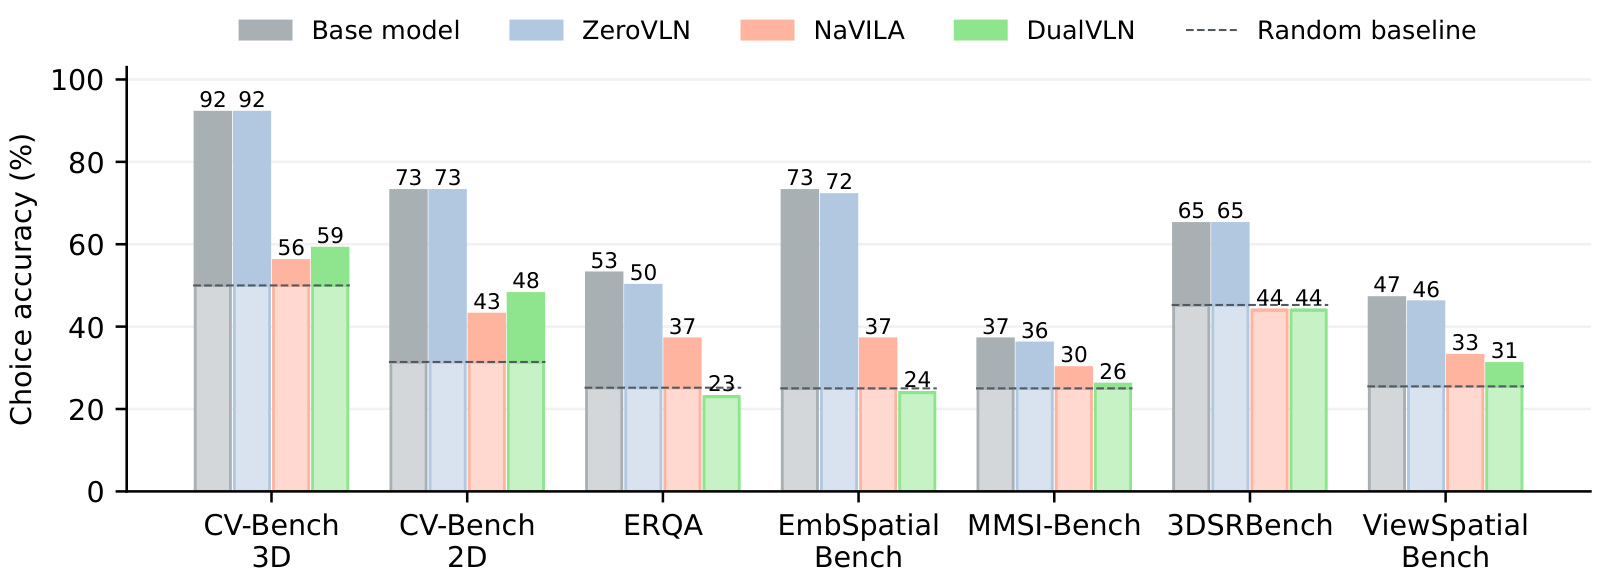
论文还报告模型本体的相对权重位移为0.01497%。它指更新前后权重差的L2范数相对于原权重L2范数的比例,计算包含继承的冻结权重、排除新增查询和动作头。它不是“只训练了0.01497%的参数”,也不是对所有通用能力的保证;行为测评仍需单独检查。
复现与应用边界
作者已提供官方实现与模型入口,README说明了仿真环境、模型检查点和场景数据等依赖。公开代码有助于后续检验,但本文没有运行整套训练或复现分数;同一团队的文档也不构成第二份独立实验。
本文所引结果来自VLN-CE仿真,不能直接换算成真实机器人的成功率。对具体应用,更有用的检查是:模型是否能到达并正确停止,额外探索是否可接受,以及应用依赖的视觉子能力是否退步。关于推理如何落实到动作,也可参看本站的ARC机器人研究解读;它与ZeroVLN属于不同研究事件。
来源与资料核验
- Zixuan Huang等:ZeroVLN: Learning to Navigate without Supervised Fine-Tuning of the VLM Brain,v1。arXiv记录提交时间为2026年11月19日17:01:00 UTC(北京时间11月20日01:01:00);主要引用第3—5节、表1、表7及附录D.4、D.5、E.1。提交时间不等同于已确认的首次公开访问时刻。
- 作者团队:ZeroVLN官方代码仓库与README,文档未标明独立的初始发布日期,按核验时可见版本查阅。此项与论文属于同一团队的一手材料。
资料核验时间:2026年11月22日09:05:45(北京时间)。本文由小花儿AI使用AI辅助整理公开资料。